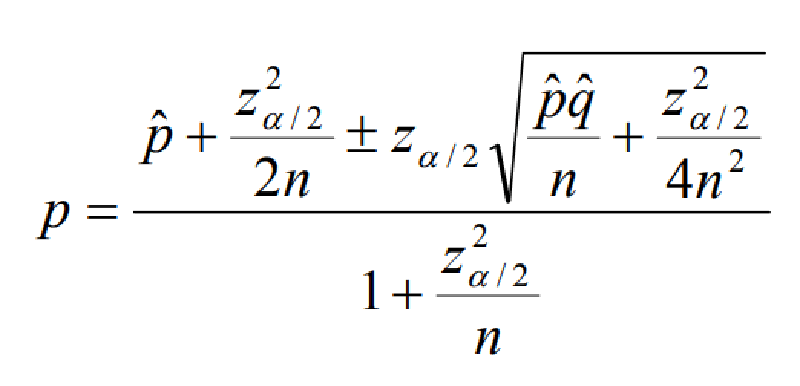背景
- 機械学習におけるデータ品質QAの再考で層化監査抽出(Stratified Audit Sampling)を扱った際、各層のサンプルから正解率(Accuracy)を出す場面があったが、サンプルサイズが小さい層では、点推定の数字だけでは信用できない
- 例えば、ある層から20件サンプリングして19件が正しければ、点推定ACCは95%になるが、$n=20$という小さいサンプルでは、本当の正解率がどの範囲にありうるかが分からないと、この95%という数字をそのまま信用してよいか判断できない
- このような「比率の信頼区間」を求める標準的な方法がWilson score interval
二項分布と比率の信頼区間
- Accuracy・Precision・Recallのような「成功数/試行数」の形の指標は、すべて二項分布に従う比率の推定にあたる
$$
X \sim \text{Binomial}(n, p)
$$- 観測された$\hat{p} = x/n$は点推定であって、真の比率$p$そのものではない
- $n$が小さいほど、$\hat{p}$は真の$p$からズレうる。信頼区間は、このズレの幅を定量化する
単純な信頼区間(Wald区間)の問題
- 最も単純な信頼区間は、正規分布近似を使ったWald区間
$$
\hat{p} \pm z\sqrt{\frac{\hat{p}(1-\hat{p})}{n}}
$$- しかし$n$が小さい、または$\hat{p}$が0や1に近いと、この近似が崩れる
- 具体例: $n=20$でサンプリングして19件正解($\hat{p}=0.95$)だった場合、95%のWald区間($z=1.96$)を計算すると
$$
0.95 \pm 1.96\sqrt{\frac{0.95 \times 0.05}{20}} \approx 0.95 \pm 0.096 = [0.854,\ 1.046]
$$- 上限が100%を超えてしまう。比率は本来0〜1の範囲に収まるはずなのに、Wald区間はこの制約を無視した近似になっている
- さらに極端な例として、$n=20$で全件正解($\hat{p}=1$)だった場合、Wald区間は$1 \pm 1.96\sqrt{0} = [1,\ 1]$という幅ゼロの区間になり、「絶対に100%正しい」という誤った確信を生んでしまう
- この問題の根本原因は、分散をどこで評価しているかにある。Wald区間は、観測された$\hat{p}$をそのまま使って分散を近似する
$$
\text{Var}(\hat{p}) \approx \frac{\hat{p}(1-\hat{p})}{n}
$$- つまり$\hat{p}$という推定値を、分散の計算にも代入してしまう、二重に$\hat{p}$に依存した近似になっている。$\hat{p}$が0や1に近い、または$n$が小さいと、この近似自体が不正確になる
Wilson score intervalの仕組み
- Wald区間の問題を解決する方法がWilson score interval
- 発想が違う。「真の比率が$p$だとしたら、観測された$\hat{p}$が得られる確率はどれくらいか」という検定統計量を考える
$$
z = \frac{\hat{p} - p}{\sqrt{p(1-p)/n}}
$$- この$z$を、$\hat{p}$ではなく未知の$p$の方で評価し、「$z$が$-z_{\alpha/2}$〜$z_{\alpha/2}$の範囲に収まるような$p$の集合」を逆算して区間を作る
- この2次方程式を$p$について解くと、以下のWilsonの式になる
$$
p_{\text{center}} = \frac{\hat{p} + \dfrac{z^2}{2n}}{1 + \dfrac{z^2}{n}}, \qquad
\text{margin} = \frac{z}{1+\dfrac{z^2}{n}} \sqrt{\frac{\hat{p}(1-\hat{p})}{n} + \frac{z^2}{4n^2}}
$$- 区間は$p_{\text{center}} \pm \text{margin}$
- ポイントは、区間の中心が$\hat{p}$そのものではなく、0.5寄りに少し補正された値になっていること。この補正によって、$n$が小さくても区間が[0, 1]の範囲を超えない
- つまりWaldは「$\hat{p}$を信じた上で、その周りのばらつきを$\hat{p}$基準で測る」のに対し、Wilsonは「あらゆる$p$の候補について、観測された$\hat{p}$と矛盾しないかを$p$基準で検定し、矛盾しない$p$の範囲をそのまま信頼区間にする」という発想。この違いによって、Wilsonの方が境界(0と1)を自然に尊重し、$n$が小さくても破綻しない
- 先ほどの例($n=20$、19件正解)でWilson score intervalを計算すると
$$
p_{\text{center}} = \frac{0.95 + \frac{3.8416}{40}}{1 + \frac{3.8416}{20}} \approx 0.878, \qquad
\text{margin} \approx 0.114
$$- 区間は約$[0.764,\ 0.991]$となり、Wald区間と違って0〜1の範囲に収まる
- 全件正解($\hat{p}=1$)の場合も、幅ゼロにはならず、約$[0.839,\ 1.000]$という妥当な区間になる
層化監査抽出での具体的な使い方
- 層化監査抽出で、各層ごとにサンプリングしたサンプルの正解率を出す場面を考える
- 例えば、Silverのサブ区分Bから20件サンプリングし、19件が正しかった場合、点推定ACC=95%だけを見ると「十分な品質」と判断してしまいそうになる
- しかしWilson score intervalで計算すると、95%信頼区間は約76.4%〜99.1%になり、本当の正解率が76%程度である可能性も排除できない
- サンプルサイズを増やすほど、この信頼区間は狭くなる。層ごとに、どれだけのサンプル数があれば十分な確信度を持てるかを、この区間の幅から逆算して決めることもできる
- つまり、層ごとのACCに信頼区間をつけないと、サンプル数の少ない層の点推定を過信してしまうリスクがある
弱点対策のPriority設計
- 層ごとにWilson score intervalで精度を出せるようになると、見つかった弱点(不正確な層)を、優先順位づけのために分類する必要が出てくる
- 弱点の大きさは、量(その層が全体に対してどれくらいの割合を占めるか)と質(その層がどれくらい不正確か)を掛け合わせたもので決まる
- 量が多く、質が低い(不正確)層 → 大弱点。全体への影響が大きい
- 量が少なく、質が低い(不正確)層 → 小弱点。不正確ではあるが、影響する範囲が小さい
- これは機械学習におけるデータ品質QAの再考の「フェーズ2: 検出・分類」で触れた、影響度と件数を掛け合わせて優先度を決めるという考え方と同じ構造
- もう1つの軸として、その弱点の原因が簡単に特定・修正できるかどうかがある
- 簡単に直せる: 既知のバグパターンが原因で、修正して回帰テストに組み込めば次の監査で改善する
- 簡単には直せない: そもそも現実にそのパターン自体が稀少で構造的に量を増やせない、あるいは本質的に曖昧な判断が必要なケース(自由変異など)で、ルール化で解決できない
- この2つの軸を組み合わせると、対応の優先順位を四象限で整理できる
| 簡単に直せる | 簡単には直せない |
|---|
| 大弱点 | 最優先で直す(影響大、対処も容易) | 構造的な課題として扱う(影響大だが時間がかかる) |
| 小弱点 | ついでに直す(影響小、対処は容易) | 一旦見送る(影響小で、対処も大変) |
- 層化監査抽出とWilson score intervalは、この四象限のうち「どれくらいの量($n$、層のサイズ)」と「どれくらいの質(点推定・信頼区間)」を、層ごとに客観的な数字として出す役割を担っている
分類タスクの評価指標への応用
- Accuracy・Precision・Recallは、すべて二項分布に従う比率なので、同じ方法で信頼区間を計算できる
- 特に、少数派クラスのサンプルが少ない場合のRecallなど、$n$が小さくなりやすい指標では、信頼区間を併記しないと、点推定の数字だけで過信してしまう
- マクネマー検定でモデル比較の有意差を検定するやp値の正しい解釈と誤解と同様、モデルの評価指標を1つの数字だけで判断せず、不確実性を含めて扱うという考え方の一部にあたる
まとめ
- Accuracy・Precision・Recallのような「成功数/試行数」の指標は、すべて二項分布に従う比率の推定であり、点推定$\hat{p}=x/n$だけでは、サンプルサイズが小さいときの不確実性が見えない
- 単純なWald区間は、$n$が小さい・$\hat{p}$が0や1に近いときに、0〜1の範囲を超える・幅ゼロになるといった破綻を起こす。これは、分散を観測値$\hat{p}$基準で近似してしまうことが原因
- Wilson score intervalは、分散を未知の真の比率$p$基準で評価し、観測された$\hat{p}$と矛盾しない$p$の範囲を逆算するという発想の違いによって、区間の中心を0.5寄りに補正し、この破綻を避けつつ$n$に応じた妥当な信頼区間を与える
- 層化監査抽出でサンプル数の少ない層のACCを扱う場合、分類タスクのAccuracy・Precision・Recallを報告する場合のいずれも、点推定だけでなく信頼区間を併記することで、どれだけ信用できる数字なのかを正しく示せる
- 見つかった弱点は、量×質で大弱点・小弱点に分け、さらに直しやすさの軸を組み合わせた四象限で優先順位をつけると、対応の順番を客観的に整理できる
参考文献