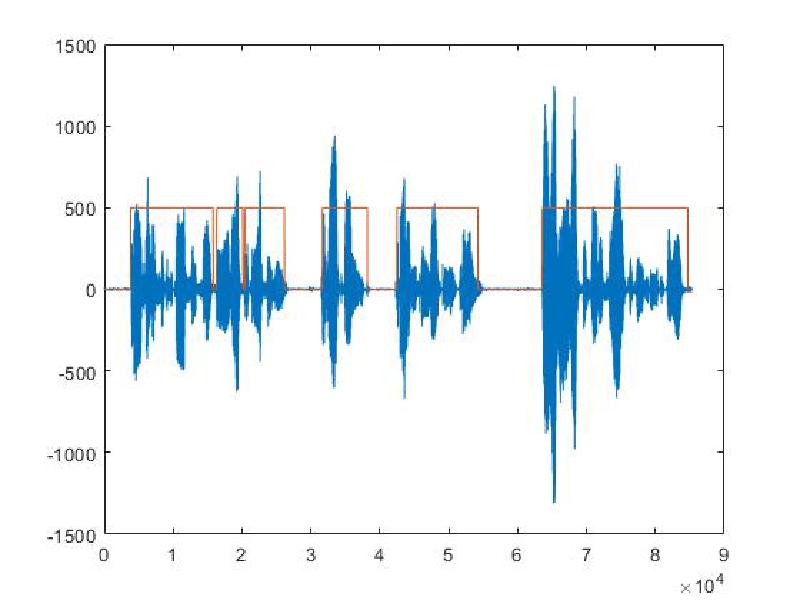
目次
背景
- 音声区間検出(VAD)でよく使われる
webrtcvadについて調べていた - 精度はDNNベースのものに勝てないが、中身がGMM(混合ガウス分布)と尤度比で構成される
- 中身が面白いので、その中身をAIで詳解した
VAD(Voice Activity Detection)とは
- 音声データの中から「人が喋っている区間」と「喋っていない区間」を判定する技術
- 無音部分のトリミング、音声認識(ASR)の前処理、通話の帯域節約など、幅広く使われる
webrtcvadは、Google WebRTCプロジェクトのVADエンジンをPythonから使えるようにしたライブラリ
WebRTC VADの全体像
- 音声を短いフレーム(10ms・20ms・30msのいずれか)に分割し、フレームごとにspeech/non-speechを判定する
- 対応サンプリングレートは8k/16k/32k/48kHzのモノラルPCM
- 内部処理は8kHzで行われており、16k/32k/48kHzの入力は、まず8kHzにダウンサンプルしてから同じ判定ロジックにかけている
- 判定の厳しさを
aggressiveness(0〜3)で指定でき、数字が大きいほどnon-speech寄りに判定する - ディープラーニングは使っておらず、GMMという古典的な統計モデルで判定している
処理の流れ
WebRTC VADの判定は、大まかに以下の流れで行われる。
- 音声をフレーム単位に分割する
- 各フレームを6つの周波数帯域(チャンネル)に分け、帯域ごとのエネルギーを計算する
- 帯域ごとに、そのエネルギーをspeech用・noise用のGMMに入力して尤度比を計算する
- 全帯域の尤度比を合算し、speechらしい方を採用する
この流れを理解するには、GMMと尤度という2つの概念を知っておく必要がある。(この後、実際のソースコードで確認したより正確な仕組みも解説する)
GMM(混合ガウス分布)とは
正規分布のおさらい
- 正規分布(ガウス分布)は、平均$\mu$を中心とした釣鐘型の分布
- 以下の式で表される
- $\mu$は分布の中心、$\sigma^2$は分布の広がり(分散)を表す
- 山が1つしかない、単純な形の分布
実際、WebRTC VADのソース(vad_gmm.cのWebRtcVad_GaussianProbability)のコメントにも、この式がそのまま書かれている。
| |
Q7・Q4・Q20は固定小数点の表現方法(浮動小数点を使わない代わりに、整数のどこまでを小数部として扱うかを表す)- 数式としては$\frac{1}{s}\exp\left(-\frac{(x-m)^2}{2s^2}\right)$そのもので、前述の$\mathcal{N}(x \mid \mu, \sigma^2)$と完全に一致する
正規分布1つでは表現できない分布
- 実際のデータは、山が複数ある分布になることが多い
- 例えば「静かな部屋のノイズのエネルギー」と「人が喋っているときのエネルギー」を混ぜて集計すると、低い値のあたりと高い値のあたりに、それぞれ山ができる
- こうした分布は、正規分布1つでは無理に1つの山として近似することになり、うまく表現できない
複数の正規分布を混ぜる
- そこで、複数の正規分布を重みつきで足し合わせたものがGMM
- 以下の式で表される
- $K$個の正規分布を混ぜ合わせる
- 各正規分布は、自分専用の平均$\mu_k$・分散$\sigma_k^2$を持つ
- $\pi_k$は「その正規分布がどれくらいの割合で混ざっているか」を表す重みで、全て足すと1になる
- イメージとしては、複数の釣鐘型の山を、それぞれ違う高さ・違う場所に立てて、足し合わせたもの
GMMの学習
- $\mu_k$・$\sigma_k^2$・$\pi_k$は、手元のデータから推定する必要がある
- 一般にはEM(Expectation-Maximization)アルゴリズムという手法で推定する
- 大まかには以下の2ステップを繰り返す
- Eステップ: 今のパラメータのもとで、各データ点がどの正規分布に属していそうかを確率的に割り当てる
- Mステップ: その割り当てをもとに、各正規分布の$\mu_k$・$\sigma_k^2$・$\pi_k$を更新する
- これを収束するまで繰り返すことで、データの分布にフィットするGMMが得られる
- 一般的には、こうして学習したパラメータは固定して使うことが多いが、WebRTC VADは少し違う(後述の「モデルは学習後も動き続ける」を参照)
尤度で分析するとは
尤度(Likelihood)の意味
- 尤度とは、「あるモデルのもとで、このデータが観測される確からしさ」を表す値
- GMMの場合、あるデータ点$x$に対する尤度は、前述の$p(x)$そのもの
- $p(x)$が大きいほど、そのモデルにとって「よくあるデータ」、小さいほど「珍しいデータ」ということになる
対数尤度とは(なぜ対数を取るのか)
- 対数尤度(log-likelihood)とは、尤度$p(x)$そのものではなく、その対数$\log p(x)$を指す
- わざわざ対数を取る理由は、主に以下の2つ
理由1は、掛け算が足し算になること。
以下は、独立した2つのデータ点$x_1$・$x_2$を同時に観測する尤度(同時尤度)の式である。
$$ p(x_1, x_2) = p(x_1) \cdot p(x_2) $$- 複数のデータを同時に扱うとき、各データが互いに独立なら、全体の尤度はそれぞれの尤度の掛け算になる
- しかし対数を取ると、この掛け算が足し算に変わる
- 足し算の方が、掛け算より計算コストが低く、桁あふれ(多くの小さい確率を掛け続けると、値がどんどん0に近づいてアンダーフローする問題)にも強い
理由2は、大小関係が変わらないこと。
- $\log$は単調増加関数なので、$p_A(x)$と$p_B(x)$の大小関係は、$\log p_A(x)$と$\log p_B(x)$の大小関係とそのまま一致する
- つまり、分類のために大小を比較する用途では、対数を取っても比較結果は変わらない
- こうした理由から、尤度は生の値ではなく対数を取った状態(対数尤度)で扱われることが多い
尤度比によるクラス判定
- クラスごとに別々のGMMを学習しておけば、そのGMM同士の尤度を比較することで分類ができる
- 具体的には、以下のような手順になる
- クラスAのデータだけを使ってGMM_Aを学習する
- クラスBのデータだけを使ってGMM_Bを学習する
- 新しいデータ$x$が来たら、$p_A(x)$と$p_B(x)$を両方計算する
- $p_A(x)$の方が大きければクラスA、$p_B(x)$の方が大きければクラスBと判定する
- 以下のような尤度比(対数を取ったもの)を閾値と比較する形で実装されることが多い
- これは「そのデータが、クラスAのモデルとクラスBのモデル、どちらにとってより自然か」を比較しているだけで、仕組みとしてはシンプル
WebRTC VADの判定の仕組み
- 前述のGMM・尤度比の考え方を、そのままspeech/non-speechの2クラス分類に当てはめたものがWebRTC VAD
- ここから先は、実際に
libwebrtcのソース(vad_core.c・vad_gmm.c)をcloneして確認した内容を元に、より正確な仕組みを解説する
特徴量:6つの周波数帯域のlog-energy
- 前半で「帯域ごとのエネルギー」と書いたが、正確にはエネルギーをdBスケールに変換したもの(log-energy)を特徴量として使っている
- 内部は8kHzで動くので、ナイキスト周波数は4kHz。この0〜4kHzを、以下のように繰り返し半分に分割して6つの帯域を作る(
vad_filterbank.cのWebRtcVad_CalculateFeatures)
| チャンネル | 周波数帯域 |
|---|---|
| 0 | 80 - 250 Hz |
| 1 | 250 - 500 Hz |
| 2 | 500 - 1000 Hz |
| 3 | 1000 - 2000 Hz |
| 4 | 2000 - 3000 Hz |
| 5 | 3000 - 4000 Hz |
- 分割には、ローパス/ハイパスに分ける
SplitFilter(オールパスフィルタ2つの組み合わせ)を使い、それを繰り返し適用して帯域を半分ずつに絞り込んでいく - 80Hz未満は、別途ハイパスフィルタで除去している(無音時の低周波ノイズ・DCオフセットの影響を避けるため)
- 各帯域のエネルギーは、
LogOfEnergyという関数で対数(dB相当、Q4固定小数点)に変換されてから特徴量になる。以下がそのコメント部分(vad_filterbank.cより抜粋)
| |
- つまりGMMに入力される$x$は「その帯域の生のエネルギー」ではなく「その帯域のエネルギーをdB変換した値」であり、これによって音量の桁の違い(静かな音と大きい音の差)を扱いやすくしている
チャンネルごとに独立したGMM
- WebRTC VADは、音声を6つの周波数帯域(チャンネル)に分けて処理する
- 各チャンネルに、noise用・speech用それぞれ2つの正規分布を混ぜたGMM($K=2$)を持っている
- つまり全体では、6チャンネル×2クラス×2つの正規分布で、合計24個の正規分布が使われている
- 前半で説明した「1つのGMMで全体を判定する」という書き方は簡略化しすぎで、正確には「チャンネルごとに独立したGMMを持ち、後で結果を合算する」という構造になっている
ローカル判定とグローバル判定
- 各チャンネルについて、noise側の尤度とspeech側の尤度から、対数尤度比(log-likelihood ratio)を計算する
- 各チャンネルの尤度比に、周波数帯域ごとの重み(高い帯域ほど大きい重み)をかけて合算し、全チャンネルまとめたグローバルな尤度比を作る
以下は、$C=6$個のチャンネルの尤度比$\text{LLR}_c$を、重み$w_c$で合算する式である。
$$ \text{LLR}\_{\text{global}} = \sum_{c=1}^{C} w_c \cdot \text{LLR}_c $$- 「掛け算」ではなく「足し算」で合算しているのは、前述の対数の性質(各チャンネルが独立なら、全体の尤度は各チャンネルの尤度の掛け算になり、対数を取ると足し算になる)を使っているため
- 6つのチャンネルをそれぞれ独立な情報源とみなし、各チャンネルの対数尤度比を(重みつきで)足し合わせることで、全帯域を総合した1つの証拠にまとめている、という考え方
判定は、以下の2つのテストの組み合わせ(どちらか一方でも満たせばspeech)で行われる。
- ローカル判定: いずれか1つのチャンネルだけでも、尤度比が強くspeech寄りであればspeechとする
- グローバル判定: 全チャンネル合算の$\text{LLR}_{\text{global}}$が閾値を超えていればspeechとする
実際の該当コードは以下(vad_core.cのGmmProbabilityより抜粋、コメントも含む)。
| |
- H0(帰無仮説)を「ノイズ」、H1(対立仮説)を「音声」とする、統計学の仮説検定(LRT: Likelihood Ratio Test)そのものの形になっている
kSpectrumWeight[channel]は、チャンネル(帯域)ごとの重み。値は{ 6, 8, 10, 12, 14, 16 }で、高い周波数帯域ほど大きい重みがついている
対数尤度比をビットシフトだけで近似計算する仕組み
- 組み込み機器向けの実装なので、浮動小数点の
log関数は一切使わず、整数のビットシフトだけで対数尤度比を近似している - 該当コードとコメントは以下(
vad_core.cより抜粋)
| |
h0_test・h1_testは、それぞれH0(ノイズ)・H1(音声)の尤度に相当する32bit整数値WebRtcSpl_NormW32(v)は、「符号ビットを除いた最上位ビットが1になるまで、vを何ビット左シフトできるか」を返す関数- 言い換えると、
vの最上位の1が立っているビット位置を求めているのと同じ - ある正の整数の最上位ビットの位置は、おおよそ$\lfloor \log_2 v \rfloor$に一致する(例えば
vが$2^{20}$〜$2^{21}-1$の範囲なら、最上位ビット位置は20で、シフト数は「31引く21」あたりの値になる)
- 言い換えると、
- つまり、必要なシフト数は「$v$の桁の大きさ」を表す指標であり、$v$が大きいほどシフト数は小さく、$v$が小さいほどシフト数は大きくなる、という$-\log_2 v$に近い性質を持つ
- コメントの式変形が示す通り、以下の近似が成り立つ
- 右辺には
log計算が一切登場せず、整数の左シフト回数を数えるだけなので、組み込み機器でも高速に計算できる - 誤差として捨てているのは、最上位ビットより下の桁(コメント中の$b_0$・$b_1$)の情報だが、これは$0$以上$1$未満の小さい値で、H0側とH1側で平均的に打ち消し合うため、実用上は無視できるとされている
h0_testまたはh1_testが0(アンダーフロー)の場合は、シフト数を最大値31にして「その仮説の尤度はほぼ0(=強く否定される)」ことを表現している
モデルは学習後も動き続ける(オンライン適応)
- 一般的なGMM分類器は、事前に学習したパラメータを固定して使うことが多い
- しかしWebRTC VADは、noise用・speech用それぞれのGMMの平均を、判定結果に応じてフレームごとに更新し続ける
- そのフレームがspeechと判定されれば、speech側GMMの平均をそのフレームの特徴量に近づける
- noiseと判定されれば、同様にnoise側GMMの平均を近づける
- 更新の強さは
kSpeechUpdateConst・kNoiseUpdateConstという定数で決まっていて、急激に動きすぎないよう抑えられている
- さらに、noise側の平均には長期的な補正もかかる
- チャンネルごとに、直近の特徴量(log-energy)の中で特に小さかった値を16個、経過フレーム数(最大100フレーム)つきで保持し続ける仕組みがあり(
vad_sp.cのWebRtcVad_FindMinimum)、そこから長期的な最小値(ノイズの床)を推定する - noise側の平均は、その推定値の方向へ
kBackEtaという定数の分だけゆっくり引き寄せられる(該当コード:nmk3 = nmk2 + (int16_t)((ndelt * kBackEta) >> 9);、コメントには"Long term correction of the noise mean"とある) - これにより、周囲のノイズレベル自体が時間とともに変化しても(エアコンが止まる、環境音が変わる等)、noiseモデルがその変化に追従できる
- チャンネルごとに、直近の特徴量(log-energy)の中で特に小さかった値を16個、経過フレーム数(最大100フレーム)つきで保持し続ける仕組みがあり(
- つまり、事前学習したパラメータはあくまでスタート地点であり、実際に動かしている環境に合わせてモデル自体が少しずつ適応し続ける仕組みになっている
aggressivenessによる閾値の違い
aggressiveness(0〜3)は、ローカル判定・グローバル判定それぞれの閾値のセットを切り替えるパラメータ- 例えば、10ms(80サンプル)フレームでの閾値は以下のように変わる
| aggressiveness | ローカル閾値 | グローバル閾値 |
|---|---|---|
| 0(Quality) | 24 | 57 |
| 3(Very Aggressive) | 94 | 1100 |
- 数字が大きいほど、speechと判定するためにより強い証拠(尤度比の差)が必要になり、non-speech寄りに判定が倒れやすくなる
判定のちらつきを抑える仕組み(hangover)
- フレーム単位の判定をそのまま出力すると、speechの終わり際などで判定がON/OFFを細かく繰り返してしまう
- WebRTC VADは、これを抑えるためにhangover(一種の余韻)という仕組みを持つ
- 一度speechと判定されると、その後しばらくnoise判定が続いてもspeechのまま扱う
- 直近でspeechが長く続いていたかどうかに応じて、hangoverの長さを切り替える
- hangoverの長さも
aggressivenessによって変わる
WebRTC VADの特徴と限界
- 特徴量が6帯域のlog-energyだけで、log-melやMFCCのようなメル尺度ベースの特徴量は使っていないため、計算が軽く高速
- ディープラーニング以前の手法のため、ノイズや残響で音質が劣化した音声には弱く、拾い漏れ(recallの低下)が起きやすい
- 話者性・方向・距離といった情報は一切使っていないため、「誰が喋っているか」「どの方向の声か」は区別できない
- カフェなど雑音の多い環境で、目的の話者以外の声(雑談など)を除外したい場合は、VAD単体では対応できない
- その用途には、話者のembeddingを使ったtarget speaker extractionや、ビームフォーミングなど別の技術が必要になる
まとめ
- WebRTC VADは、GMMと尤度比という古典的な統計モデルでspeech/non-speechを判定している
- GMMは、複数の正規分布を重みつきで混ぜ合わせて、複雑な分布を表現するモデル
- 尤度は「あるモデルからそのデータが出てくる確からしさ」で、クラスごとにGMMを学習して尤度を比較すれば、そのまま分類器として使える
- 対数尤度(尤度の対数)を使うと、独立なデータの同時尤度の掛け算が足し算になり、計算が軽く数値的にも安定する。WebRTC VADが各帯域の尤度比を足し算で合算しているのもこの性質による
- dB・dBFS・log-mel・MFCCは、いずれも音声処理でよく出てくる基礎的な特徴量表現だが、WebRTC VADはそのどれでもなく、オールパスフィルタで再帰的に分割した6帯域のlog-energyというシンプルな特徴量を使っている
- 実際のソースコードを確認すると、以下のようなことが分かった
- 特徴量は6つの周波数帯域(80-250, 250-500, 500-1000, 1000-2000, 2000-3000, 3000-4000 Hz)ごとのlog-energy
- 帯域ごとに独立したGMMがあり、ローカル判定(帯域単体)とグローバル判定(重みつき合算)を組み合わせている
- これはH0: ノイズ/H1: 音声という尤度比検定(LRT)そのものの形になっている
- 対数尤度比は
log関数を使わず、32bit整数の正規化に必要なビットシフト数の差だけで近似計算されている - GMMのパラメータは事前学習した値で固定ではなく、動作中もフレームごとにオンラインで適応し続けている(ノイズの床の長期的なドリフトにも追従する)
- hangoverという仕組みで、判定のちらつきを抑えている
- WebRTC VADは軽量・高速な反面、話者を区別する仕組みがなく、ノイズへの頑健性もニューラルVADに比べて劣る