背景 ROS上でHRI(Human-Robot Interaction、人間とロボットのインタラクション)を扱うための標準規格・OSSツール群であるROS4HRIについて、仕組みを整理する ROS4HRIとは ROS REP-155として仕様化された、ROS 1・ROS 2の両方に対応する、人間の認識・表現のための標準的なメッセージ型・規約 「ロボットが共有空間の中で人間を意味のある形で認識・解釈・応答できるようにする」ことを目的とした、オープンソースのリソース群 EUの資金援助を受けて開発されており、Apache 2.0ライセンスで公開されている REP-155自体は、骨格追跡・顔認識・音声処理といった分野で、ROSエコシステムの他の分野ほど広く受け入れられた共通インターフェースがなかったという問題意識から作られている REP-155の仕様 4種類のID ID 永続性 割り当て元 Person ID 永続的なUUID。セッションを超えて同一人物を表す 顔認識・声認識など、人物識別が可能なノード Face ID 非永続的。顔がフレームから外れると無効になる 顔検出ノード Body ID 非永続的。骨格が追跡されている間だけ有効 骨格追跡ノード Voice ID 非永続的 音声分離ノード
トピックの名前空間 全てのHRI関連トピックは/humans/以下に置かれ、faces・bodies・voices・persons・interactionsという5つのサブ名前空間に分かれる 例えば/humans/faces/<faceID>/croppedのように、個々の実体(顔など)ごとの名前空間を持つことで、下流のノードが情報を追加していける なぜ単一のFaceメッセージではなく分割するのか 仮に全ての顔情報をまとめた汎用的な1つのFaceメッセージを発行する設計にすると、1つのノードが顔に関する全ての情報を先に統合しなければならなくなり、モジュール性が損なわれる そのため、切り出し・表情認識・ランドマーク検出といった個々の情報を、別々のノードがそれぞれのサブトピックに発行する設計になっている 座標フレーム REP-120の慣習に従い、以下のような座標フレームが定義されている フレーム 原点 軸の向き face_<faceID>セリオン(両目の中間点) x軸が前方、z軸が頭頂方向 body_<bodyID>腰の中間点 x軸が前方、z軸が頭方向 gaze_<faceID>face_<faceID>と同じ位置z軸が視線方向 person_<personID>追跡中はface/bodyフレームと同じ位置、そうでなければ最後に確認された位置 -
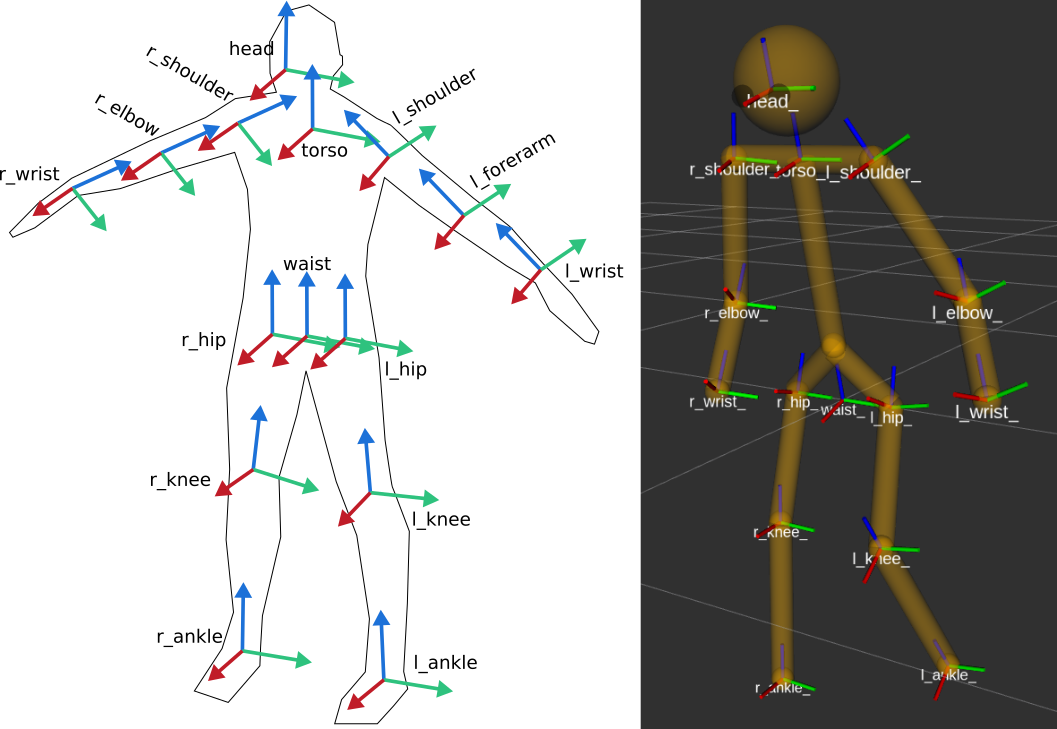
person_<personID>フレームの位置は、location_confidence(位置の確信度)によって扱いが変わる。追跡中は1.0、最近見えていた場合は1.0未満、既知だが一度も観測されていない場合は0になる人体のキネマティックモデルは、頭・胴体・肩・肘・手首・腰・膝・足首など15個の主要なリンクで構成され、URDFが/human_description_<bodyID>としてパラメータサーバーに動的に読み込まれる 視線の非対称性 「AがBを見ている」という関係は、必ずしも「BもAを見ている」ことを意味しない。視線(Gaze)は送り手(sender)と受け手(receiver)の非対称な関係として表現される Kinematic Model of the Human
The main 15 links defined on the human body are presented in the above diagram. Frames orientations and naming are based on REP-103 and REP-120. Right: render of the reference URDF model of the human body in rviz.
全体像: ROS4HRIエコシステムの構成 公式サイト(ros4hri.github.io)で確認すると、ROS4HRIは単なるメッセージ規約ではなく、「知覚→人物統合→インタラクションのスキル→UI・可視化」という一連の流れを、パッケージ群として提供するエコシステムになっている 大まかな処理の流れは以下の通り 順序 段階 内容 1 知覚(Perception) カメラ・マイクから、顔・身体・声を個別に検出する 2 人物統合(Person Fusion) 検出された顔・身体・声を、hri_person_managerが1人の人物として統合する 3 インタラクションスキル(Interaction Skills) 統合された人物の情報を使って、発話・注視・ナビゲーション・動作・把持といった、標準化された「スキル」をロボットに実行させる 4 UI・可視化(UI & Visualization) 開発中のデバッグや、ロボットの対話用インターフェースの構築に使う
パッケージのカテゴリ一覧 公式サイトでは、パッケージは大きく5つのカテゴリに分けられている カテゴリ 内容 コアライブラリ・メッセージ hri_msgsなど、全体の基盤となるメッセージ定義・ライブラリ 知覚(Perception) 顔・身体・音声の検出と、それらを人物に統合する機能 インタラクションスキル 発話・ナビゲーション・操作など、ロボットに実行させる標準化された動作 可視化・デバッグ 開発時の確認・デバッグ用のツール UI構築 対話的なユーザーインターフェースを作るための部品
下の表では、「知覚」と「インタラクションスキル」をさらに細かいサブカテゴリ(知覚(顔)・知覚(身体)など)に分けて示している カテゴリ別パッケージ一覧 カテゴリ パッケージ 役割 コアライブラリ・メッセージ hri_msgs 顔・身体・声・人物に関する標準メッセージ コアライブラリ・メッセージ hri_actions_msgs HRIのIntent(意図)に関する標準アクション コアライブラリ・メッセージ human_description 人体の標準URDFモデル コアライブラリ・メッセージ libhri(C++)/pyhri(Python) ROS4HRIトピックを簡単に扱うためのライブラリ 知覚(顔) hri_face_detect 顔検出・ランドマーク・視線 知覚(顔) hri_emotion_recognizer 表情認識 知覚(顔) hri_face_identification 顔の識別・認識 知覚(身体) hri_body_detect 身体に関する知覚機能 知覚(音声) asr_vosk 音声特徴の抽出・発話区間検出 人物追跡・統合 hri_face_body_matcher 顔と身体のマッチング 人物追跡・統合 hri_person_manager 人物への統合(Mr. Potato algorithm) 人物追跡・統合 hri_engagement エンゲージメント(関わりの度合い)の追跡 インタラクションスキル Communication 発話・対話(Say、Chat、Ask) インタラクションスキル Interaction 社会的インタラクション(LookAt、LookFor、LED、Expressions) インタラクションスキル Navigation ナビゲーション(Navigate、Waypoints、Zones) インタラクションスキル Motions 動作実行(関節・直交座標系の軌道) インタラクションスキル Manipulation 操作(Grasp、Place、ハンド制御) 開発ツール rpk スキル・タスク・アプリケーションのパッケージ生成器 開発ツール architecture_schemas / architecture_tools / std_skills スキル定義のJSONスキーマ・検証・標準メッセージ 可視化・デバッグ hri_rviz RVizでの3Dスケルトン等の可視化プラグイン 可視化・デバッグ hri_visualization カメラ画像への顔・身体・表情のオーバーレイ表示 可視化・デバッグ rqt_human_radar / rqt_chat 人物のレーダー表示/対話デバッグ用チャットUI 可視化・デバッグ interaction_sim HRI研究用のROS 2シミュレーション環境 UI構築 ui_server / ui_msgs / ros-qml-plugin QMLを使った対話的UIの表示・ROS連携
対応ロボット 区分 ロボット 特徴 商用 PAL TIAGo 7自由度アーム+昇降トルソーを持つ、研究向けモバイルマニピュレータ 商用 PAL TIAGo Pro 両腕7自由度、画面・LEDなどの対話機能を強化した上位版 商用 PAL TIAGo Pro Head 表情豊かな頭部のみの単体版。社会的信号・視線研究向け 商用 PAL ARI 受付・案内・エンターテインメント向けの、表情豊かな顔とジェスチャーを持つ社会的ロボット OSS・研究用 EMOROBCARE ICMAT/IIIA(CSIC)が開発する、自閉症療育向けの低コストな社会的ロボット(球状の台座+3自由度の頭部)
開発元のPAL Robotics社自身が、TIAGo・ARIといった商用ロボットシリーズを展開しており、ROS4HRIはこれらのロボットの人間認識基盤としても使われている EUのHorizon Europe研究助成を受けて開発されている メッセージ定義: hri_msgs ROS4HRIでは、人間の認識結果を表現するための専用メッセージ型が定義されている。実際にリポジトリをクローンして、msg/以下の17種類のファイルを確認した カテゴリ一覧 17種類のメッセージは、内容に応じて5つのカテゴリに分けられる カテゴリ 対象 含まれるメッセージ 顔・表情 顔から読み取れる情報 Expression、FacialActionUnits、FacialLandmarks、Gaze 身体 身体から読み取れる情報 Skeleton2D、Gesture、BodyPosture 属性・音声 年齢・性別や、音声から読み取れる情報 SoftBiometrics、AudioFeatures、LiveSpeech 集団・ID管理・関係性 複数の人物・特徴の間の関係 Group、IdsList、IdsMatch、EngagementLevel 幾何的なプリミティブ型 他のメッセージから使われる座標の基礎型 NormalizedPointOfInterest2D、NormalizedPointOfInterest2DStamped、NormalizedRegionOfInterest2D
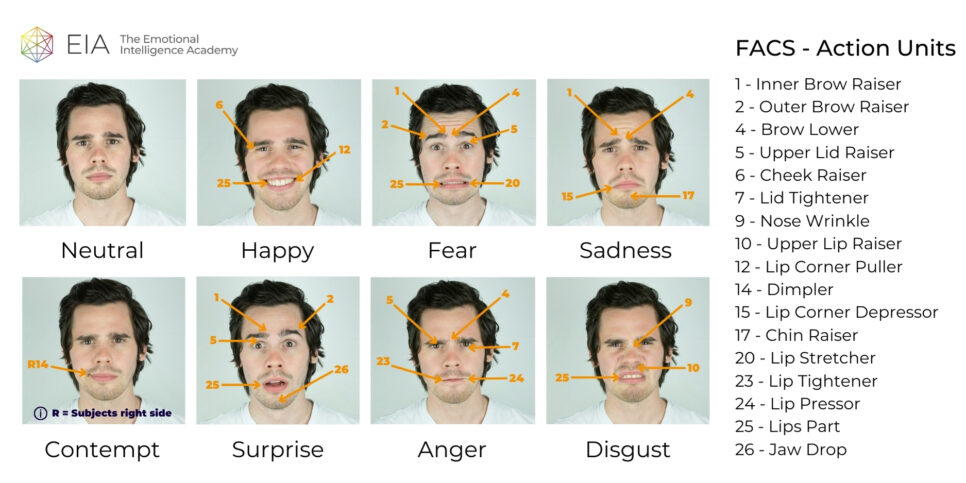
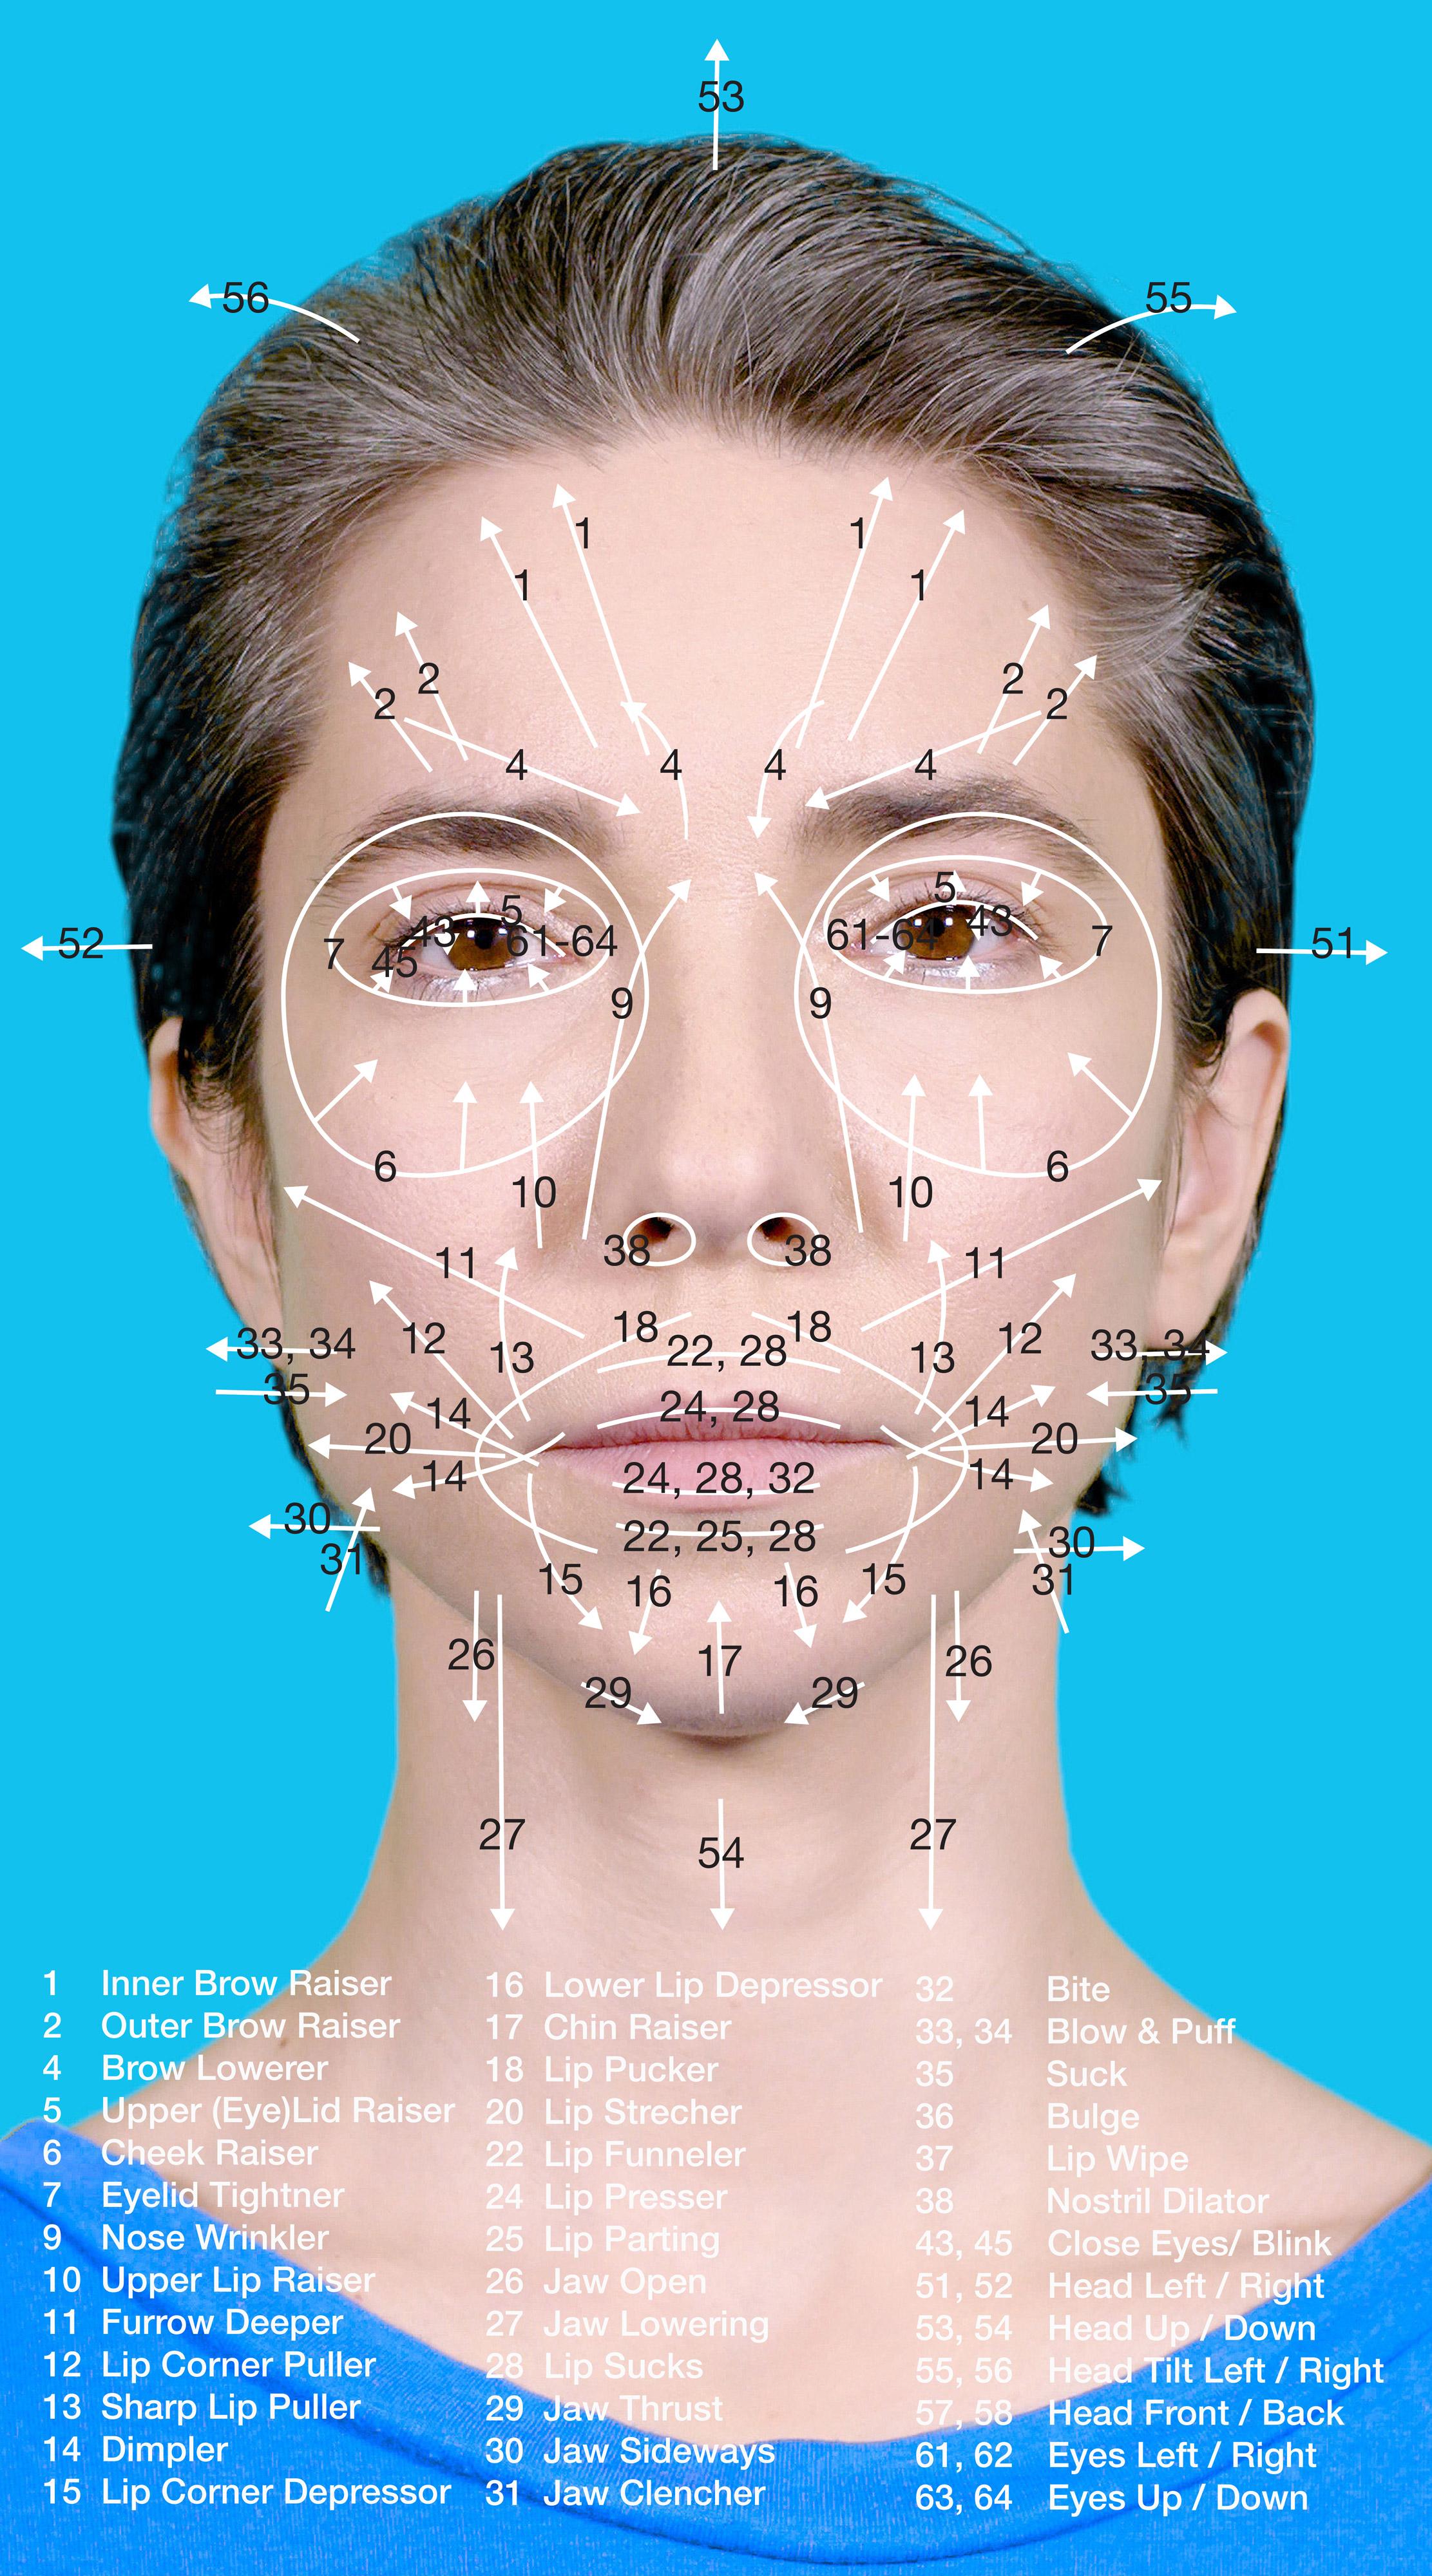
顔・表情に関するメッセージ メッセージ 内容 Expression 表情を、カテゴリ(neutral、angry、happyなど25種類、Chambers 2020年MSc論文・Ekmanの基本6感情モデルに基づく)と、Valence/Arousalモデル(感情のpositive/negative度を表すvalence、興奮度を表すarousal、それぞれ-1.0〜+1.0)の両方で表す FacialActionUnits Ekmanが開発したFACS(Facial Action Coding System)の命名に従い、99種類のAU(Action Unit、表情を作る顔の部位ごとの動き)それぞれの強度と確信度を配列で表す。頭の向き・視線の向き・顔の可視性なども含む FacialLandmarks dlib・OpenPoseの規約に従った70点の顔のランドマーク(輪郭・眉・目・鼻・口など)を、正規化された2D座標の配列として表す Gaze 視線の送り手(sender)と受け手(receiver)の人物IDを表す。空文字列はロボット自身を意味する
身体に関するメッセージ メッセージ 内容 Skeleton2D OpenPoseのCOCOモデルの規約に従い、鼻・両肩・両肘・両手首・両腰・両膝・両足首・両目・両耳という18点の骨格キーポイントを、正規化された2D座標の配列として表す Gesture 手を顔に当てる・腕を組む・手を挙げる・手を振るといった、身体から検出されるジェスチャーを表す BodyPosture 立っている・座っている・しゃがんでいる・寝ているという、身体の姿勢を記号的に表す
属性・音声に関するメッセージ メッセージ 内容 SoftBiometrics 推定した年齢・性別を、それぞれの確信度(confidence)付きで表す AudioFeatures INTERSPEECH 2009 Emotion Challengeで選定された16種類の音声特徴(ゼロ交差率、RMSフレームエネルギー、ピッチ、調波対雑音比、MFCC1〜12)を、openSMILEツールキットで抽出した値として表す LiveSpeech 音声認識の途中結果(incremental)と最終結果(final)、その確信度、ISO 639-1の言語コード+ISO 3166-1の地域コードによるlocale(例: en_GB)を表す
集団・ID管理・関係性に関するメッセージ メッセージ 内容 Group グループIDと、そのグループに属する人物IDのリストを表す IdsList 顔ID・身体ID・人物IDなど、ROS4HRIのIDのリストを表す汎用的なメッセージ。例えば/humans/faces/trackedで、現在検出されている顔のIDの一覧が配信される IdsMatch 一時的なID(顔・身体・声)と永続的なID(人物)の対応候補を、確信度付きで表す。確信度0.0は「この2つは対応しない」という意味を持つ特別な値。/humans/candidate_matchesに配信され、Mr. Potato algorithmの入力になる EngagementLevel 人間がロボットにどれだけ関わっているかを、unknown・disengaged・engaging・engaged・disengagingという5段階の離散値で表す。/humans/persons/<person_id>/engagement_statusで配信される
幾何的なプリミティブ型 Skeleton2DやFacialLandmarksなど、複数のメッセージから共通して使われる、座標を表すための基礎的な型も定義されている 型 内容 NormalizedPointOfInterest2D 正規化された(0.0〜1.0の範囲の)点の座標(x, y)と、その点の確信度(c)を表す NormalizedPointOfInterest2DStamped NormalizedPointOfInterest2Dにタイムスタンプ付きヘッダを加えたもの NormalizedRegionOfInterest2D 正規化された矩形領域を、左上(xmin, ymin)と右下(xmax, ymax)の座標と確信度(c)で表す
hri_actions_msgs: アクション・意図の定義 hri_msgsが「知覚(Perception)」側のメッセージを扱うのに対し、hri_actions_msgsは「アクション(Action)」側、つまりロボットに何をさせるか・人間が何を意図しているかを表すメッセージを扱う Intent: 意図の表現 Androidのintentに着想を得た、ロボットに実行させたい操作を抽象的に表すメッセージ intent(どの操作か)と、data(JSON形式のパラメータ)という2つの必須フィールドを持つdataの中身は、動作主(agent)・対象(object)・目的地(goal)・受け手(recipient)という、言語学の主題役割(thematic role)に基づくキーで指定する例えば「キッチンにいるLukeに食材を持っていって」は、intent: BRING_OBJECT、data: {"object": "groceries", "goal": "kitchen_1", "recipient": "person_luke"}のように表現される 定義済みIntent 意味 RAW_USER_INPUT 意図の抽出に失敗した場合のフォールバック ENGAGE_WITH 相手と関わりたい MOVE_TO 指定した場所に移動する GUIDE 誰かをどこかへ案内する GRAB_OBJECT / BRING_OBJECT / PLACE_OBJECT 物を取る/持っていく/置く GREET 挨拶する SAY 指定したテキストを話す PRESENT_CONTENT 画面などで決められたコンテンツを提示する PERFORM_MOTION ダンスや手を振るなどの動作を実行する START_ACTIVITY / STOP_ACTIVITY スクリプト化された振る舞いの開始・停止 WAKEUP / SUSPEND システムの再起動・休止
Intentには、他にもsource(ロボット自身・リモート監督者・不明な相手のどれが発した意図か。REP-155準拠の場合は人物IDも使える)、modality(発話・動作・タッチスクリーン・内部処理のどれで伝えられたか)、priority(0〜255)、confidence(0.0〜1.0)といったフィールドがある その他のメッセージ メッセージ 内容 ActivityList START_ACTIVITY/STOP_ACTIVITY Intentで起動できる、アクティビティ名の一覧 ClosedCaption 発話者ID・テキスト・localeを持つ、字幕(クローズドキャプション)表示用のメッセージ LookAtWithStyle 注視対象の3D座標に加え、目だけ/頭だけ/両方(デフォルト)という、視線の動かし方のスタイルを指定する
アクション定義 ROS 2のAction(Goal・Result・Feedbackからなる、時間のかかる処理向けの通信方式)として、以下のようなものが定義されている アクション 内容 LookAt 指定した3D座標を注視する ApplicationControl 下位のアプリケーションコントローラーにJSON形式のパラメータを渡す SelfPresentation 自己紹介などの、複数のフレーズからなる発話を実行し、進行状況(現在のフレーズ数/総フレーズ数)をフィードバックする FaceOverlay 顔のディスプレイに画像・アニメーションを重ねて表示する。表示時間・レイヤー(背景/前景)・レイアウト(両目に表示/左右の目ごとなど)・スケール・位置・フェード効果を指定できる PointTrajectory 複数の3D座標点と、それぞれに到達する時刻を指定し、軌道を描かせる
hri_person_manager: 顔・身体・声を1人の人物に統合する カメラ・マイクなど複数のセンサーから得られる顔・身体・声の検出結果は、それぞれ別々に検出されるが、それらが同じ1人の人物のものだと紐付けなければ、ロボットは人間を1人の人物として認識できない hri_person_managerは、検出された顔・身体・声を集約し、一貫した「人物(person)」として扱い、それぞれの検出結果への紐付けを外部に公開するノード Mr. Potato algorithm 他のノード(顔認識ノードなど)が/humans/candidate_matchesに投稿する、IdsMatchメッセージ(特徴同士・特徴と人物の対応候補、確信度付き)を受け取り、確率的なグラフ(person features graph)を構築する アルゴリズムは、クローンしたリポジトリのdoc/ALGORITHM.mdに、以下のような形式的な定義がある特徴(feature): 顔・身体・声のいずれか 許容されるパス(permissible path): 同じ種類のノードを2つ以上含まない経路。尤度はパス上の尤度の積 関連(association): 閾値(デフォルト0.5)を超える尤度の許容パスで結ばれた、ノードの連結集合 要件として、(1) 全ての関連の尤度の合計を最大化する、(2) 全ての特徴は必ず1人の人物(匿名も含む)に紐付く、(3) 人物に紐付かない特徴は匿名の人物に紐付ける、(4) 間接的なパスが切れた場合も、尤度が閾値を超えていれば直接的な関連として安定的に維持する、という4点が定義されている この手法は、“Probabilistic fusion of persons’ body features: the Mr. Potato algorithm"という論文として発表されている(DOI: 10.1145/3610977.3637479) パラメータ パラメータ デフォルト値 意味 match_threshold 0.5 顔・身体・声を同じ人物とみなす最小尤度 reference_frame map 人物のTFフレームを配信する基準フレーム。固定された基準フレームを使うことで、人物が一度カメラの視界から外れても、最後に見えた位置に留まり続ける personal_distance 1.2m 近接学(proxemics)に基づく、個人距離圏の上限 social_distance 3.6m 社会距離圏の上限 public_distance 20m 公共距離圏の上限
主なトピック トピック 内容 /humans/candidate_matches 他ノードから受け取る、特徴同士・特徴と人物の対応候補 /humans/persons/known・/humans/persons/tracked 人物の一覧 /humans/persons/in_{personal|social|public}_space 各近接圏にいる人物の一覧 /humans/persons/<person_id>/proxemic_space 個々の人物の近接圏 /humans/graph 特徴同士の対応関係をDOT形式で可視化したもの
libhri: 人間の認識結果への簡単なアクセス ROS4HRIの各トピックを生のまま扱う代わりに、HRIListenerというクラスを通じて、検出された人間・顔・身体をオブジェクトとして扱える、簡易的なAPIを提供する C++実装のhriパッケージと、それをPybind11でラップしたPython版のpyhriパッケージがある チュートリアル ROS4HRIには、公式サイトの新しいチュートリアルと、IROS22で行われた(ROS 1 Noetic時代の)より古いチュートリアルの、2種類がある 新しいチュートリアル: LLM対応インタラクティブアプリの構築 公式サイトには「ROS4HRIの知覚・スキルを使って、LLM対応のインタラクティブアプリを構築する」という、実践的なチュートリアルが用意されている 使われているツール・ノードは以下の通り 層 ツール・ノード 役割 知覚 gscam Webカメラの映像を配信 知覚 hri_face_detect 顔検出(確信度の閾値付き) 知覚 hri_emotion_recognizer 検出した顔からの表情分類 知識・推論 knowledge_core OWL/RDFベースの記号的な知識ベース(Webビューア付き) 知識・推論 hri_person_manager 顔・身体・声を1人の人物に統合 対話 dialogue_manager 発話の入出力管理 対話 ollama ローカルLLM推論(カスタムのチャットボットが利用) 対話 rqt_chat テキストでの対話確認用プラグイン 可視化 rqt_human_radar 検出した人物・空間的な関係のレーダー表示 制御・表出 interaction_sim 2Dのソーシャルインタラクション・シミュレーター
このチュートリアルで出てくるGUIは、ロボット・人間のアバターをSVGで描いた2Dの見下ろし型シミュレーター(interaction_sim)と、procedural(手続き的)に生成された目だけの表情豊かなロボットの顔の2種類がある。アニメ風に見えたのは、おそらくこのどちらか 手順は、Part 0(Docker環境構築)→Part 1(顔検出の動作確認)→Part 2(シミュレーターと知識ベースの導入)→Part 3(rpkでミッションコントローラーを生成し、/skill/sayでの発話や、検出した表情をロボットの表情にそのまま反映する「感情ミラーリング」を実装)→Part 4(ollamaでのLLM統合、意図抽出のプロンプト設計、知識ベースを使ったコンテキスト付与)という流れで進む 古いチュートリアル: IROS22のROS4HRI完全ウォークスルー ROS 1 Noetic時代に、IROS22で実施された、1日がかりの完全なチュートリアル 題材として「OfficeBots」という、HRI研究用のマルチプレイヤーゲーム型シミュレーターを使っている。キャラクターを選んでプレイする、ゲームらしい見た目のGUIを持つ 3部構成になっている パート 内容 Part 1 OfficeBotsを使い、ROS4HRIのAPIに触れながら、視線の合致度(mutual gaze)を使ったエンゲージメント推定器を自作する Part 2 Webカメラの実データを使い、顔検出(hri_face_detect)・骨格検出(hri_fullbody)・ジェスチャー認識(waving検出)を実装する Part 3 Rasaで作ったチャットボットと、音声認識結果(LiveSpeech)を統合した、マルチモーダルなチャットボットを完成させる
Part 1のエンゲージメント推定は、ロボットと人物が互いを見ている度合いを表す相互視線の指標$M_{RP}$(ロボットの視野内での人物の位置と、人物の視野内でのロボットの位置、それぞれの光軸からの距離の積)と、それを距離で正規化した社会的エンゲージメントの指標$S_{RP}=\min(1, M_{RP}/\text{dist}(R,P))$を使う Part 2のhri_face_detect・hri_fullbody(2D/3D骨格検出)はどちらもGoogleのMediaPipeを使っている。骨格検出の結果はrobot_state_publisherとhuman_descriptionパッケージのURDFを使って、3Dの関節状態・TFツリーとして公開される waving(手を振る)ジェスチャーの検出は、肩・肘・手首の間の距離(肩肘間・肘手首間・肩手首間)が、それぞれ特定の範囲(0.1〜0.25、0.1〜0.25、0.15〜0.25)に収まるかどうかで判定する、シンプルな閾値ベースの手法 Part 3では、音声認識結果を/humans/voices/<id>/speechからRasaのチャットボットサーバーに送り、その応答を/sayトピック(ROS4HRI標準ではない、OfficeBots独自のトピック)でロボットに発話させる 顔と人物の対応付けも、rostopic pub /humans/candidate_matches hri_msgs/IdsMatchのように、手動でIdsMatchメッセージを配信することで体験できる 今後の展望: 生理指標への拡張(Sense4HRI) Scheibl, Leichert, Görmez, Wrede (2026, Bielefeld University) “Sense4HRI: A ROS 2 HRI Framework for Physiological Sensor Integration and Synchronized Logging”(arXiv:2603.19914)は、ROS4HRIを生理指標(EEG・ECG・PPGなど)の統合に拡張する論文 生理信号はHRIにおけるユーザーの心理状態の推定に重要性が増しているが、ROS 2ベースのHRIフレームワークには、こうしたデータストリームを標準化された形で統合する再利用可能な仕組みがまだ無いという問題意識から提案されている センサードライバと解釈ロジックを分離し、PhysioRaw.msgという汎用的なメッセージ形式、ROS4HRIの命名規則に準拠した階層的なトピック名、複数センサーを同期させるためのデバイス側タイムスタンプなどを導入している Polar社のECG・PPGセンサーと表情認識を統合したプロトタイプで、複数モダリティを組み合わせた感情状態の推定を実証している ROS4HRI自体はこれまで顔・身体・声・表情といった外部から観測できる情報を中心にしていたが、Sense4HRIのような拡張によって、生理指標という内部状態の推定も同じ命名規則・名前空間の中に統合していく方向性が今後見込まれる まとめ ROS4HRI(REP-155)は、ROS上で人間を認識・表現するための標準的なメッセージ型・規約を定めた、OSSのフレームワーク REP-155は、Person ID(永続)・Face/Body/Voice ID(非永続)という4種類のIDと、/humans/以下の名前空間、face_<faceID>などの座標フレームを定義している。汎用的な単一メッセージではなく、サブトピックに分割することでモジュール性を確保している 全体としては、知覚(顔・身体・声の検出)→人物統合(Mr. Potato algorithm)→インタラクションスキル(発話・注視・ナビゲーション・操作)→UI・可視化という流れを、一貫したパッケージ群として提供するエコシステムになっている 開発元のPAL Robotics社のTIAGo・ARIといった商用ロボットや、CSICのEMOROBCAREのような研究用ロボットで実際に使われている hri_msgsが、表情(カテゴリ+Valence/Arousal)・FACS準拠のAU・顔のランドマーク・視線・骨格・ジェスチャー・姿勢・年齢性別・音声特徴・音声認識結果・グループ・ID対応候補(IdsMatch)・エンゲージメント・座標のプリミティブ型を含む、全17種類のメッセージ型を定義している hri_actions_msgsが、知覚の反対側にあたる「アクション」側として、Androidのintentに着想を得たIntent(主題役割に基づくdata、14種類の定義済みIntent)や、LookAt・FaceOverlay・SelfPresentationといったROS 2 Actionを定義している hri_person_managerが、別々に検出される顔・身体・声を、確率的グラフマッチング(Mr. Potato algorithm、尤度の積で計算される許容パスと、要件を満たす最大尤度の分割)によって1人の人物として統合する 近接学に基づく3つの距離圏(personal/social/public)と、固定された基準フレームによる位置の記憶も、hri_person_managerの機能の一部 libhriが、これらの情報にオブジェクト指向的にアクセスできる簡易APIを提供する 公式サイトのLLM対応チュートリアルでは、知覚(顔検出・表情認識)・知識ベース(knowledge_core)・対話(ollamaによるローカルLLM)・シミュレーター(interaction_sim)までを一通り組み合わせた、実践的な構築手順が示されている IROS22の古いチュートリアルでは、OfficeBotsというゲーム型シミュレーターを使い、相互視線に基づくエンゲージメント推定・骨格検出によるジェスチャー認識・Rasaチャットボットの統合を、実際にコードを書きながら体験できる Sense4HRIのように、ROS4HRIの命名規則・名前空間を踏襲しつつ、生理指標のような新しいモダリティを統合する拡張も登場している 参考文献