目次
背景
- p値は統計的検定で最もよく使われる指標の一つだが、同時に最も誤解されやすい指標でもある
- Martin (2026)の"Teaching Thoughtful Statistical Inference: Stories for the World Beyond p < 0.05"でも、p<0.05という閾値への過度な依存と、学生・研究者の間での根強い誤解が指摘されている
- ここで改めて、p値の正しい定義とよくある誤解を整理した
- 特に、誤解の根っこにある「Base Rate Fallacy(基準率の誤謬)」を軸に据える
p値
p値の正しい定義
- p値とは、帰無仮説$H_0$が正しいと仮定した場合に、実際に観測されたデータ、またはそれと同じかそれ以上に極端なデータが得られる確率
- 重要なのは、これは条件付き確率$P(\text{データ} \mid H_0)$であって、$P(H_0 \mid \text{データ})$(帰無仮説が正しい確率)ではないという点
- この2つを取り違えることが、p値をめぐる誤解の大半の出発点になる
p値と棄却と採用
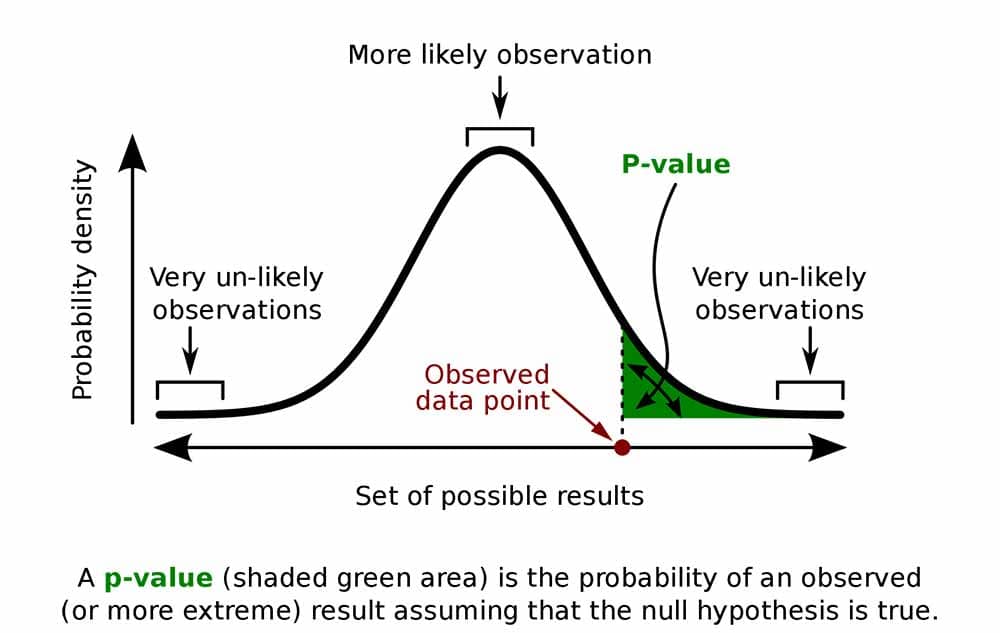
p値は、帰無仮説$H_0$が真だと仮定したもとで、観測された検定統計量と同じか、それ以上に$H_0$と整合しにくい(極端な)値が出る確率の事。
ロジックとしては:
- 「帰無仮説$H_0$が正しいと仮定すると、今回観測したもの以上に極端な結果が出る確率(p値)が 0.05 以下だった」
- 「したがって、あらかじめ有意水準を$\alpha=0.05$と決めていたなら、$H_0$を棄却する」
- 「その結果を統計的に有意(statistically significant)と呼ぶ」
よく使われる言い方だと、以下みたいな感じ:
- 帰無仮説が前提の時に、観測した結果がでる可能性が有意水準の0.05以下だから(起こりにくく)、帰無仮説は棄却されて対立仮説が偶然ではなく有意とした
- 偶然だけでは説明しにくい結果なので、帰無仮説を棄却し、対立仮説を支持する証拠が得られた
帰無仮説が棄却=対立仮説が正とも限らない
これは帰無仮説H0と対立仮説H1と広い対立仮説H1*を表した図。
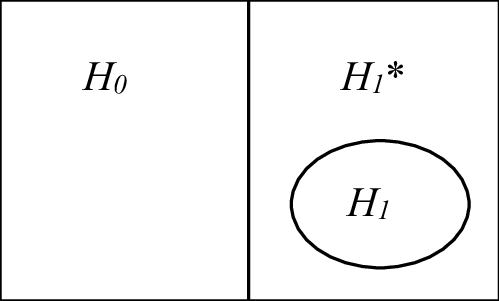
それぞれの象限は以下を意味する:
- $H_0$:
- 帰無仮説が成り立つ世界
- 例: 「新薬と既存薬で効果に差がない」
- $H_1^*$:
- 帰無仮説ではないすべての可能性
- 例:「差がある場合すべて」
- $H_1$:
- 対立仮説が成り立つ世界
- 例:「新薬のほうが既存薬より効果が高い」
すなわち、H0がRejectされた=H1が正しい、というわけではない事を示している。
簡単な例: コイン投げで考えるp値
帰無仮説と対立仮説
- 帰無仮説($H_0$): 「差がない」「効果がない」という、保守的な既定の仮説。今回は「このコインは表裏が五分五分である($p=0.5$)」
- 対立仮説($H_1$): 検証したい主張。今回は「このコインは表が出やすい($p>0.5$)」
- 仮説検定は、$H_0$を真だと仮定した世界で、実際に観測したデータがどれくらい起こりにくいかを調べることで、$H_0$を棄却できるかを判断する
NOTE:
- $H_0$は必ずしも「差がない」を意味するとは限らない
- 本質は「反証されるまでは採用される、懐疑的・保守的な既定の立場」であり、それがたまたま多くの場面で「差がない」という形を取りやすいだけ
- 例えば後述の同等性検定(TOST)では、証明したいのが「同等である」側なので、$H_0$はむしろ「差がある(マージンを超えて離れている)」側に置かれる
- 何を証明したいかによって、どちらが$H_0$になるかは変わる
- 適合度検定のように、2つを比較するのではなく「このデータはある分布に従っている」という、単一のデータセットについての仮説を立てる場合もある
- $H_0$は「差=0」である必要もなく、特定の値(例えば「効果量は基準値の5と同じ」)でもよい
- 重要なのは、$H_0$が1点(または単純な形)に定まっていて、そのもとでのデータの分布を計算できること
具体例: 10回投げて8回表が出た
- あるコインを10回投げたところ、8回表が出たとする
- $H_0$($p=0.5$の公正なコイン)のもとで、8回以上表が出る確率を計算する
- 計算すると
- つまりp値は約0.055。これは「公正なコイン($H_0$)だと仮定した場合に、10回中8回以上表が出る確率」であり、「このコインが公正である確率」でも「このコインが偏っている確率」でもない
- 慣習的な有意水準0.05と比べると、0.055はわずかに上回っており、「統計的に有意とは言えない」という判断になる
- 直感的には「10回中8回も表が出たら偏っていそう」と感じやすいが、$H_0$のもとでも約5.5%の確率で起こりうる程度の偏りであり、積極的に$H_0$を棄却できるほど極端な結果ではない、というのがp値の読み方になる
第一種の誤りと第二種の誤り
仮説検定の判断には、2種類の誤りがありうる。
| $H_0$が真 | $H_0$が偽 | |
|---|---|---|
| $H_0$を棄却する | 第一種の誤り($\alpha$) | 正しい判断(検出力, $1-\beta$) |
| $H_0$を棄却しない | 正しい判断($1-\alpha$) | 第二種の誤り($\beta$) |
- 第一種の誤り(Type I Error): $H_0$が実際には真なのに、誤って棄却してしまう誤り。確率は有意水準$\alpha$で表され、慣習的に0.05に設定されることが多い。いわゆる偽陽性(False Positive)
- 第二種の誤り(Type II Error): $H_0$が実際には偽なのに、棄却できない誤り。確率は$\beta$で表され、いわゆる偽陰性(False Negative)
- 検出力(Power)は$1-\beta$で、本当に効果がある場合にそれを正しく検出できる確率。前述の新薬の臨床試験の例で使った「検出力80%」は、まさに$1-\beta=0.8$のこと
トレードオフの関係
- $\alpha$を小さくする(有意水準を厳しくする)と第一種の誤りは減るが、同じサンプルサイズのままだと$\beta$が大きくなりやすく、第二種の誤りが増えてしまう
- $\alpha$と$\beta$は同じサンプルサイズのもとではトレードオフの関係にあり、両方を同時に小さくするにはサンプルサイズを増やす必要がある
- 後述のマンモグラフィの例・新薬の臨床試験の例で使う「感度」「偽陽性率」「検出力」という言葉は、実はこの第一種・第二種の誤りの言い換えになっている
- 感度(Sensitivity) = 検出力 = $1-\beta$
- 偽陽性率(False Positive Rate) = $\alpha$
p値とBase Rate Fallacy(基準率の誤謬)
- $P(\text{データ}\mid H_0)$と$P(H_0\mid\text{データ})$の取り違えを、具体的な数字で可視化すると、Base Rate Fallacy(基準率の誤謬)という、より一般的な確率の誤解に行き着く
- Base Rate Fallacyとは、検査・検定そのものの精度(感度・偽陽性率)だけに注目し、調べている対象がそもそもどれくらいの割合で真である(基準率)かを無視してしまう誤り
コロナの例
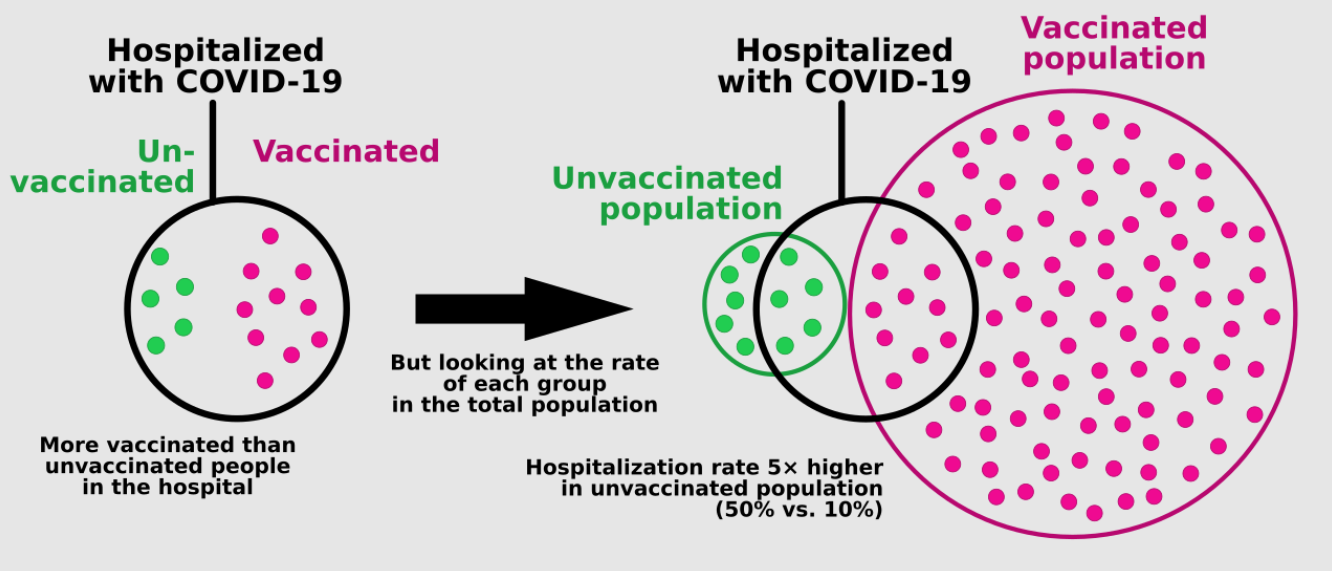
- 左側では、COVID-19で入院している人の中に、緑の「未接種者」よりピンクの「接種者」が多く描かれている
- ここだけ見ると「接種者のほうが入院しているじゃん」と思える
- しかし、右側では、そもそもの母集団を示している
- そして、接種者の人口が未接種者よりずっと多い場合、人数ではなく、それぞれの集団のうち何%が入院したかを比較する必要がある
- この図の例では、以下の設定:
- 未接種者:50%が入院
- 接種者:10%が入院
- つまり、未接種者の入院率は接種者の5倍
- たとえば、
- 接種者1000人 → 100人入院(10%)
- 未接種者100人 → 50人入院(50%)
- 目の前の入院患者だけを見て接種者の人数が多いからといって、接種者のほうが“入院しやすい”とは限らない
- つまり、ベースレート(母集団の大きさ)を考慮する必要があるという話
マンモグラフィの例
- 乳がんの基準率(有病率)が0.8%の集団に対して、感度90%(がんがある人を正しく陽性と判定する割合)、偽陽性率7%(がんが無い人を誤って陽性と判定する割合)の検査を行うとする
- 10,000人のうち、がんのある人は80人、無い人は9,920人
- 真陽性: $80 \times 0.90 = 72$人
- 偽陽性: $9{,}920 \times 0.07 \approx 694$人
- 陽性と判定される人の合計: $72 + 694 = 766$人
- 陽性と判定された766人のうち、本当にがんがあるのはわずか72人、つまり約9.4%
- 検査自体の精度(感度90%・偽陽性率7%)はそれなりに高いにもかかわらず、陽性と判定された人の約91%は偽陽性になる
- これは、基準率(0.8%という低い有病率)を無視して、検査結果だけを見てしまうと起きる典型的な誤解
新薬の臨床試験の例
- 同じ構造は、仮説検定にもそのまま当てはまる
- 100種類の新薬を試験し、そのうち本当に効果があるのは10種類(基準率10%)だとする
- 検出力(Power)80%、有意水準$p<0.05$で検定を行うと
- 真に効果がある10種類のうち、$10 \times 0.8 = 8$種類が正しく「有意」と判定される(真陽性)
- 真に効果が無い90種類のうち、$90 \times 0.05 = 4.5 \approx 5$種類が誤って「有意」と判定される(偽陽性)
- 「有意」と判定される薬の合計: $8 + 5 = 13$種類
- つまり、「有意」と判定された13種類のうち、本当に効果があるのは8種類、約62%に留まる
- 「p<0.05で有意だった」という結果だけを見ると、まるで95%の確率で本物の効果があるかのように錯覚しがちだが、実際には基準率(どれくらいの薬が本当に効くか)次第で、この数字は大きく変わる
- 基準率が低い(本当に効果のあるものが少ない)領域ほど、p<0.05を満たした結果のうち偽陽性が占める割合が大きくなる
多重検定問題への拡張
- 検定の数を増やすほど、この問題はさらに深刻になる
- 独立な帰無仮説を$k$個検定するとき、有意水準$\alpha=0.05$のもとで少なくとも1つ偽陽性が出る確率は
- $k=20$なら約64%、$k=45$なら約90%が、少なくとも1つの偽陽性を含む計算になる
- 1980年代の医学論文は平均して1研究あたり30回の比較を行っていたという報告もあり、個々の検定だけを見てp<0.05で判断すると、見かけ上の発見の多くが偽陽性になりうる
対策: Benjamini-Hochberg法
- 複数の検定を行う際、Bonferroni補正のように有意水準を単純に厳しくするだけでは、検出力が大きく落ちてしまう
- Benjamini & Hochberg (1995)は、個々のp値の誤り確率ではなく、有意と判定した結果全体に占める偽陽性の割合(False Discovery Rate, FDR)を直接制御する方法を提案した
- p値を小さい順に並べ、順位に応じた基準と比較することで、「有意」と判定する集合全体のFDRを一定以下に抑えつつ、Bonferroni補正より高い検出力を確保できる
その他のよくある誤解
p値が小さいほど効果が大きい
- p値はサンプルサイズに強く依存する。サンプルサイズを増やせば、どれほど小さな効果でも、いずれp値は小さくなる
- 逆に、本当は意味のある効果があっても、サンプルサイズが小さければp値は大きく出ることがある
- つまりp値は「効果があるかどうか」の目安にはなるが、「効果がどれくらい大きいか」(効果量, Effect Size)とは別の指標
- 機械学習におけるデータとデータソースの再考の「データの量」で触れた、サンプルサイズと統計的優位性の関係も同じ話
p<0.05なら「証明された」、p>0.05なら「効果がない」
- p値は証明でも反証でもなく、連続的な証拠の強さを表す指標の一つに過ぎない
- 0.05という閾値はFisherが提案した慣習であって、理論的に導かれた絶対的な境界ではない
- p=0.049とp=0.051の間に、質的な違いがあるわけではない
有意でないことは、効果が無いことの証明である
- “Absence of evidence is not evidence of absence”(証拠が無いことは、無いことの証拠ではない)
- 検定の検出力(Power)が低いだけで有意差が出ないことは珍しくなく、サンプルサイズ不足が原因であることも多い
- 有意でない結果は「効果がないと確認された」のではなく、「今回のデータでは効果を検出できなかった」という意味に留まる
「差がないこと」を証明したい場合: 同等性検定
- 「差がないこと」を積極的に証明したい場面(新しい製造方法が品質を落とさないことを示したい、ジェネリック薬が先発薬と同等であることを示したいなど)では、通常の検定の$H_0$と$H_1$を単純に入れ替えても証明にならない
- 通常の検定では$H_0$(差がない)が1点(例えば$差=0$)に定まるからこそ、$H_0$のもとでのデータの分布を計算してp値を定義できる
- 単純に入れ替えて$H_0$を「差がある」にしようとすると、「差がある」は0以外のすべての値という広がりを持つ集合になり、単一のサンプリング分布を定義できず、検定として成立しない
- そこで使われるのが、同等性検定(Equivalence Testing)、特にTOST(Two One-Sided Tests)という手法
- まず「実務上無視できる差の範囲」として、同等性マージン$[-\delta, \delta]$を事前に決める
- 「真の差が$-\delta$以下である」「真の差が$+\delta$以上である」という2つの片側検定を行う
- 両方とも棄却できれば、真の差は$(-\delta, \delta)$の範囲に収まっている、つまり実務上「同等」と結論づけられる
- ポイントは、証明したい「同等である」を対立仮説に据えるのではなく、「同等でない($\delta$以上離れている)」という2つの帰無仮説を立てて、それぞれを棄却するという形を取ること
対策
p値と効果量・信頼区間を併用する
- p値単体で判断するのではなく、効果量(Cohen’s dなど)と信頼区間を併記することが推奨される
- 信頼区間は、p値のような二値的な判断材料ではなく、「真の効果がどのくらいの範囲にありそうか」という情報を連続的に提供する
- マクネマー検定でモデル比較の有意差を検定するで触れた「p値は差がないとは考えにくいことを示すだけで、効果量や実務的な重要性は別に評価する必要がある」という注意点も同じ趣旨
ASA(米国統計学会)の2016年声明
- 2016年、American Statistical Association(ASA)はp値の誤用に関する公式声明を出した
- 声明は、おおむね次のような原則をまとめている
- p値は、データがある特定の統計モデルとどれくらい相容れないかを示す指標である
- p値は、調べている仮説が正しい確率や、データが偶然だけで生じた確率を測るものではない
- 科学的な結論やビジネス上の意思決定を、p<0.05という閾値を超えたかどうかだけに基づかせるべきではない
- 適切な推論には、完全な報告と透明性が必要
- p値や統計的有意性は、効果の大きさや結果の重要性を測るものではない
- p値だけでは、ある仮説についての証拠の強さを十分に測れない
新しい論文の視点: 統計的思考としての教育
- Martin (2026)は、p<0.05という閾値の使い方だけを教えるのではなく、統計的推論をより広い「統計的思考」の枠組みの中で教えるべきだと主張している
- 実際の研究事例や統計学の歴史的な逸話を使うことで、仮説検定の有用性と限界の両方を、文脈とともに伝える教育法を提案している
- これは、p値を単独の合否判定ツールとして扱うのではなく、基準率・効果量・信頼区間・再現性・ドメイン知識と組み合わせた、総合的な証拠評価の一部として位置づける考え方と一致する
まとめ
- p値は$P(\text{データ} \mid H_0)$であり、$P(H_0 \mid \text{データ})$(帰無仮説が正しい確率)ではない
- コイン投げの例(10回中8回表、p≈0.055)のように、直感的に偏って見えても、$H_0$のもとで十分起こりうる程度であれば有意とは言えない
- 仮説検定には第一種の誤り($\alpha$, 偽陽性)と第二種の誤り($\beta$, 偽陰性)の2種類があり、同じサンプルサイズのもとではトレードオフの関係にある
- この取り違えを数字で可視化するとBase Rate Fallacyに行き着く。マンモグラフィの例では、検査自体の精度が高くても、基準率(有病率0.8%)が低いせいで陽性的中率はわずか9.4%になる
- 新薬の臨床試験でも同じ構造が起き、基準率10%・検出力80%・p<0.05の設定では、「有意」と判定された結果のうち本物は約62%に留まる
- 検定の数が増えるほど、少なくとも1つの偽陽性を含む確率は急速に上昇し(20回で64%、45回で90%)、Benjamini-Hochberg法のようなFDR制御の仕組みが必要になる
- p値はサンプルサイズに強く依存するため、効果の大きさとは別の指標として扱う必要がある
- p<0.05という閾値は慣習に過ぎず、証明・反証の境界線ではなく、有意でないことも効果が無いことの証明にはならない
- 「差がないこと」自体を証明したい場合は、$H_0$と$H_1$を単純に入れ替えるのではなく、同等性マージンを決めて2つの片側検定を行うTOST(同等性検定)という専用の枠組みを使う
- p値は基準率・効果量・信頼区間と併用し、ASAの2016年声明が示す原則に沿って解釈するべき
参考文献
- Wasserstein, R. L., & Lazar, N. A. (2016). “The ASA Statement on p-Values: Context, Process, and Purpose”
- Martin, P. (2026). “Teaching Thoughtful Statistical Inference: Stories for the World Beyond p < 0.05” (Teaching Statistics)
- Reinhart, A. “Statistics Done Wrong: The Woefully Complete Guide”, Chapter 4 “The p Value and the Base Rate Fallacy” — statisticsdonewrong.com
- Benjamini, Y., & Hochberg, Y. (1995). “Controlling the False Discovery Rate: A Practical and Powerful Approach to Multiple Testing”
- Amrhein, V., Greenland, S., & McShane, B. (2019). “Scientists rise up against statistical significance” (Nature)
- Schuirmann, D. J. (1987). “A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability”
- P値に関するよくある誤解 - Sei Consulting Group
- マクネマー検定でモデル比較の有意差を検定する
- 機械学習におけるデータとデータソースの再考