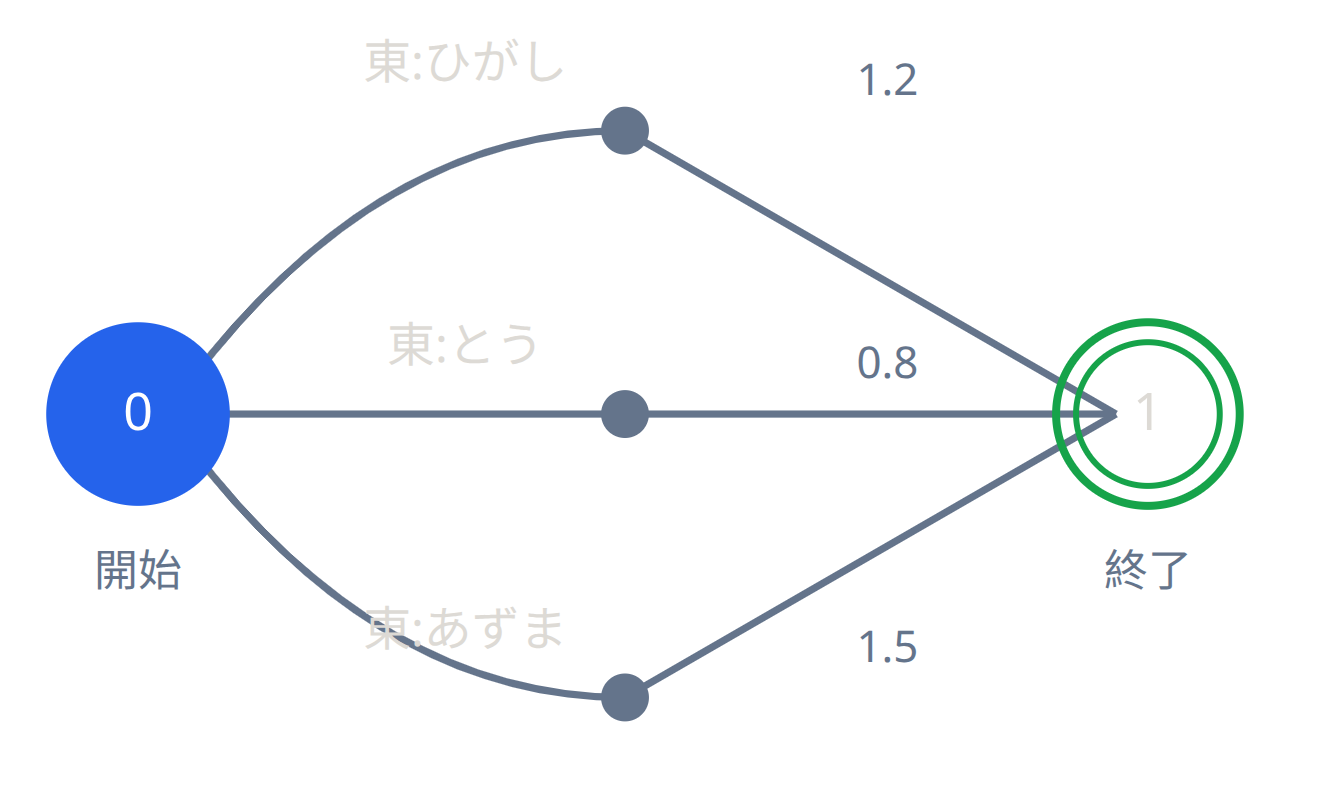
背景 G2Pライブラリを作る時に調査した先行文献などのメモ で、日本語G2P(Grapheme-to-Phoneme)の先行研究を調べる中で、「辞書制約ラティス+CRFスコアリング」という設計に出会ったこの設計は新しいアイデアではなく、日本語形態素解析器MeCabが2000年代から使ってきた古典的な骨格だと分かった この記事では、MeCabの仕組みを中心に、ラティスとCRFそれぞれの役割を整理した上で、この骨格が最新の研究にどう引き継がれているかまで見る MeCabとは 公式サイト によると、京都大学とNTTコミュニケーション科学基礎研究所の共同研究によって開発された、オープンソースの日本語形態素解析器Kudo, Yamamoto, Matsumoto (2004) “Applying Conditional Random Fields to Japanese Morphological Analysis”(EMNLP 2004)で提案された 辞書から得られる全ての分割候補をラティスとして構築し、CRFでそのラティス上の最適な経路(最も妥当な分割・品詞列)を選ぶ、という設計を採用した この論文の時点で、すでに「ラティス+CRFスコアリング」は日本語処理の実用技術として確立していた 特定の辞書・コーパスに依存しない汎用的な設計(dictionary and corpus-independent generic design)を特徴としていて、辞書を入れ替えるだけで様々なドメインに対応できる ライセンスはGPL・LGPL・BSDのトリプルライセンス 辞書の検索には、効率的な文字列検索ができるDouble-Array TRIE(ダブル配列のトライ木)というデータ構造を使っている ラティス ラティスとは ラティス(lattice、格子)とは、複数の候補仮説を1つのグラフとしてまとめて表現したもの 例えば「東京都」という文字列を分割する場合、「東京/都」「東/京都」「東京都」のような複数の分割候補が考えられる これらの候補をすべて別々に保持するのではなく、共有できる部分(文字の区切り位置をノードとする)をまとめて1つのグラフにすることで、多数の候補を効率的に表現できる 日本語の場合、辞書に載っている単語の分だけ、文字列上にノードとエッジを張ることで、考えられる分割パターンすべてを含むラティスが自然に構築できる 東京都の例 「東京都」の場合、文字の境界を4つのノード(0=文頭、1=「東」の後、2=「京」の後、3=「都」の後)とし、辞書にある単語の分だけノード間にエッジを張ると、以下のようなラティスになる 1
2
3
4
5
6
7
8
9
10
ノード:   (0)    (1)    (2)    (3)
          文頭   東の後  京の後  都の後(文末)

エッジ(辞書にある単語):
  (0) → (1): 東
  (1) → (2): 京
  (2) → (3): 都
  (0) → (2): 東京
  (1) → (3): 京都
  (0) → (3): 東京都
このラティス上で、(0)から(3)まで辿る経路(パス)が1つの分割候補に対応する(0)→(1)→(2)→(3): 「東」「京」「都」 (0)→(2)→(3): 「東京」「都」 (0)→(1)→(3): 「東」「京都」 (0)→(3): 「東京都」 どのパスを選ぶのが最も妥当かを決めるのが、次に説明するCRFの役割 WFST(Weighted Finite-State Transducer)との関係 ラティスは、より一般的な形式である重み付き有限状態トランスデューサ(WFST)の特殊ケースとして捉えることができる WFSTは、各状態遷移に入力ラベル・出力ラベル・重みを持つオートマトンで、Mohri, Pereira, Riley (1994) “Weighted rational transductions and their application to human language processing"をはじめ、音声認識・機械翻訳・OCRなど幅広い分野で使われてきた、より汎用的な理論的枠組み 今回のラティスの例は、各エッジに「入力(文字列)」と「スコア(重み)」が乗った、WFSTの入出力ラベルが同一の場合(weighted acceptor、重み付き受理オートマトン)にあたる 音声認識の分野では、認識結果の複数候補をまとめた「認識ラティス」を、WFSTの合成(composition)演算によって、音響モデル・発音辞書・言語モデルを1つのオートマトンに統合して生成することが一般的で、MeCabのラティス+CRFという設計も、この一般的な枠組みの日本語形態素解析版と位置づけられる
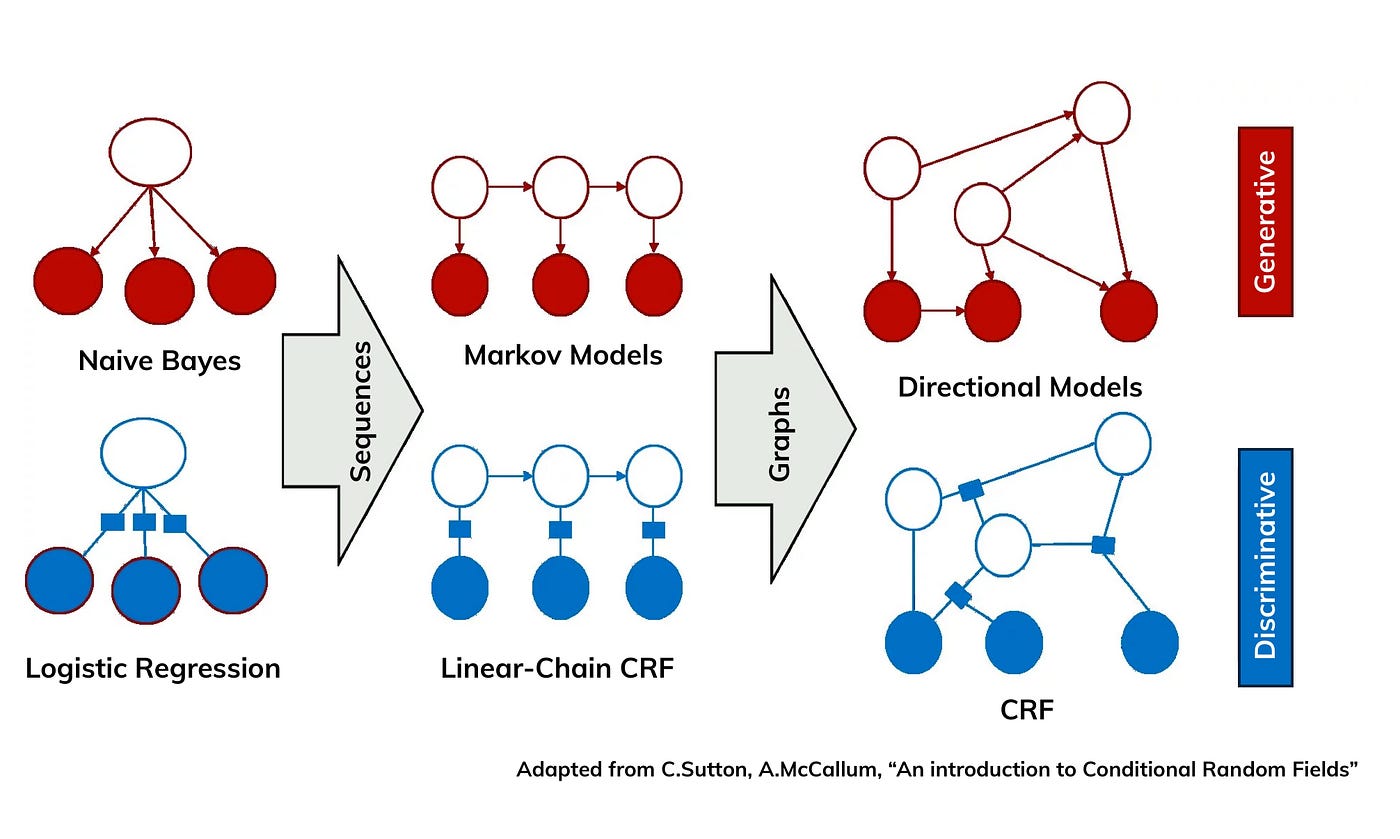
CRF CRF(Conditional Random Field)とは Lafferty, McCallum, Pereira (2001) “Conditional Random Fields: Probabilistic Models for Segmenting and Labeling Sequence Data"が提案した、系列ラベリング(品詞タグ付け・分割など)のための識別モデル なぜ単純な個別判定ではダメなのか 1文字ずつ「ここは単語の境界かどうか」を独立に判定する方法も考えられるが、境界の妥当性は前後の文字列に依存するため、独立に判定すると矛盾した結果になりやすい 例えば「京」の後が境界かどうかは、「東京」として読むか「京都」として読むかによって変わる。1箇所だけを見て判定するのではなく、全体の組み合わせ(パス)を一貫性を保ったまま評価する必要がある Naive BayesとLogistic Regressionから見るCRF CRFをいきなり理解しようとすると難しいが、より身近な分類器であるNaive BayesとLogistic Regressionの関係から辿ると分かりやすい。Sutton & McCallum (2010) “An Introduction to Conditional Random Fields"では、この関係を次のような2x2の対応として整理している。
- 生成モデル(Generative) 識別モデル(Discriminative) 系列でない(1件ずつ分類) Naive Bayes Logistic Regression 系列(文字列・時系列など) HMM CRF
Naive Bayes: 特徴量$X$の各要素がクラス$Y$ごとに独立に生成されると仮定した、生成モデルの分類器。$P(X,Y)=P(Y)\prod_i P(x_i\mid Y)$という形でモデル化する Logistic Regression: Naive Bayesと同じ特徴量を使うが、$P(X,Y)$を生成的にモデル化せず、$P(Y\mid X)$を直接モデル化する識別モデル。Naive Bayesの「生成・識別ペア」にあたる(Ng & Jordan, 2002) HMMは、Naive Bayesを系列に拡張したもの。各時刻のラベル$Y_t$が前のラベル$Y_{t-1}$に依存し(マルコフ性)、各時刻の観測$X_t$はそのときのラベル$Y_t$だけから生成されると仮定する。この「観測がラベルだけから独立に生成される」という仮定が、Naive Bayesの特徴量独立性の仮定の系列版にあたる CRFは、Logistic Regressionを系列に拡張したもの。HMMの「生成・識別ペア」にあたり、系列全体に対する条件付き分布$P(Y\mid X)$を直接モデル化するため、HMMのような独立性の仮定を置かずに、重なり合う豊かな素性を使える つまり「CRFはLogistic Regressionの系列版」であり「HMMはNaive Bayesの系列版」という対応関係で理解すると、CRFの位置づけが掴みやすい
生成モデルと識別モデルの違い HMM(隠れマルコフモデル)のような生成モデルは、観測列とラベル列の同時分布$P(X,Y)$をモデル化する。「まずラベル列が決まり、そこから観測列が生成される」という想定の確率モデル CRFは、ラベル列の条件付き分布$P(Y\mid X)$を直接モデル化する識別モデル。「観測列$X$が与えられたとき、ラベル列$Y$はどれくらい妥当か」だけを直接扱うため、観測列側の複雑な依存関係を気にせず、任意の素性を自由に組み込める HMM・MEMM・CRFの比較 CRFがなぜ必要かは、HMMとMEMM(Maximum Entropy Markov Model)という2つの先行モデルの弱点を踏まえると分かりやすい。
モデル 種類 正規化の方法 弱点 HMM 生成モデル 各ステップの遷移・出力確率の積として、系列全体が自動的に正規化される 観測$X$の各要素が対応するラベルだけに依存するという強い独立性の仮定があり、複数の文字・候補語をまとめた豊かな素性を使いにくい MEMM 識別モデル 各ステップごとに個別に(局所的に)正規化する ラベルバイアス問題(Label Bias Problem)。遷移先の選択肢が少ない状態では、観測からの情報をほとんど無視して、決まった遷移を選んでしまう CRF 識別モデル 系列全体を通して1回だけ(大域的に)正規化する ラベルバイアス問題を避けつつ、MEMMと同様に自由な素性を使える
HMMは「ラベル列→観測列」という生成過程を想定するため、観測$X$の各要素が対応するラベル$Y_i$だけに依存するという、強い独立性の仮定を置く必要がある。この仮定のせいで、複数の文字・複数の候補語をまとめて見るような、重なり合う素性を組み込みにくい MEMMは、HMMの弱点を解消するために、各ステップで観測$X$を条件とした遷移確率$P(y_i\mid y_{i-1},X)$を直接モデル化する識別モデルとして考案された。しかし各ステップを個別に正規化する(各ステップの遷移確率の合計を1にする)ため、遷移先の選択肢が少ない状態では、観測からの情報をほとんど無視して、決まった遷移を選んでしまうラベルバイアス問題が生じる CRFは、各ステップを個別に正規化するのではなく、系列全体のスコアを使って1回だけ大域的に正規化する。これにより、ラベルバイアス問題を避けながら、MEMMと同じように観測$X$について自由な素性を使える CRFのスコアリング ラティス上の各パス($Y$)に対して、素性(辞書にある単語かどうか、前後の品詞の組み合わせなど)を重み付けして合計したスコアを計算する このスコアを指数関数$\exp(\cdot)$に通し、全パスのスコアの合計で割ることで、確率として正規化する 分母はすべての候補パス$Y'$について合計するため、正規化項(分配関数)と呼ばれる 最もスコアが高いパスが、そのまま最も確率が高いパスになる($\exp$は単調増加関数なので、スコアの大小関係がそのまま確率の大小関係になる) 具体例: 東京都のラティスにスコアをつける 前述の3つのパスに、辞書の情報などから求めた生スコアが次のようについたとする パス 生スコア 東京+都 5.2 東+京都 2.1 東京都 6.8
パス $\exp(\text{score})$ 確率 東京+都 181.3 16.7% 東+京都 8.2 0.8% 東京都 897.8 82.6%
最もスコアが高かった「東京都」(1語)が、そのまま最も確率が高いパスとして選ばれる 実際のラティスでは候補パスの数が多くなるが、次に説明するViterbiアルゴリズムを使うと、すべてのパスを1つずつ数え上げなくても、最良のパスを効率的に見つけられる MeCabでのラティス+CRFスコアリング ラティスは、考えられる分割・読みの候補を網羅的に、しかし効率的に表現する役割を担う CRFは、そのラティス上の各経路(=1つの分割・読みの組み合わせ)に対してスコアを計算し、Viterbiアルゴリズムで最もスコアの高い経路を効率的に探索する役割を担う つまりMeCabは「候補の生成(ラティス)」と「候補の評価・選択(CRF)」という2段構えの設計になっている 最新研究への接続 G2Pライブラリを作る時に調査した先行文献などのメモ で扱った、Hu, Zhan & Lin (2026)の論文(arXiv:2609.19805)も、このMeCabと同じ骨格を使っている違いは、CRFのスコアリングに現代的なニューラル特徴(埋め込み)を使い、分割と読みを同時にモデル化し、データ不足をLLMが生成した200万文超のデータで解決した点 検証実装のLatticeG2P-JPも、スコアラを「辞書コストのみ」「連接行列」「小型ニューラルネット」から選べるようにしている。連接行列は、まさにMeCabが使っている古典的なスコアリング方式そのもので、1つの選択肢として扱われている まとめ MeCabは、辞書から構築したラティスと、CRFによるスコアリングを組み合わせた、2000年代初頭から実用化されている古典的な設計 ラティスが候補の生成(分割・読みの組み合わせを効率的に表現すること)を担い、CRFが候補の評価・選択(最適な経路を見つけること)を担う、という役割分担になっている CRF自体も、HMMやMEMMの弱点(独立性の仮定の強さ、ラベルバイアス問題)を踏まえて設計された識別モデル 現代のニューラルG2P研究も、この骨格の上に、ニューラル特徴やLLM生成データといった新しい要素を組み合わせているだけで、根本の設計は変わっていない 参考文献 G2Pライブラリを作る時に調査した先行文献などのメモ MeCab: Yet Another Part-of-Speech and Morphological Analyzer Mohri, M., Pereira, F., & Riley, M. (1994). “Weighted rational transductions and their application to human language processing” Lafferty, J., McCallum, A., & Pereira, F. (2001). “Conditional Random Fields: Probabilistic Models for Segmenting and Labeling Sequence Data” Ng, A. Y., & Jordan, M. I. (2002). “On Discriminative vs. Generative Classifiers: A comparison of logistic regression and naive Bayes” Sutton, C., & McCallum, A. (2010). “An Introduction to Conditional Random Fields” (arXiv:1011.4088 ) Kudo, T., Yamamoto, K., & Matsumoto, Y. (2004). “Applying Conditional Random Fields to Japanese Morphological Analysis” Hu, R., Zhan, Z., & Lin, X. (2026). “Dictionary-Constrained Grapheme-to-Phoneme for Unsegmented Languages from LLM-Annotated Data” (arXiv:2609.19805 ) LatticeG2P-JP