目次
背景
- これまでROS4HRIの仕組み・SPRING: 高齢者介護施設における社会的ロボットの実証実験・ロボット発話のパラフレーズが意味を壊す問題とNLIによる対策と、LLMを使ったHRI(Human-Robot Interaction)研究を個別の論文単位で読んできた
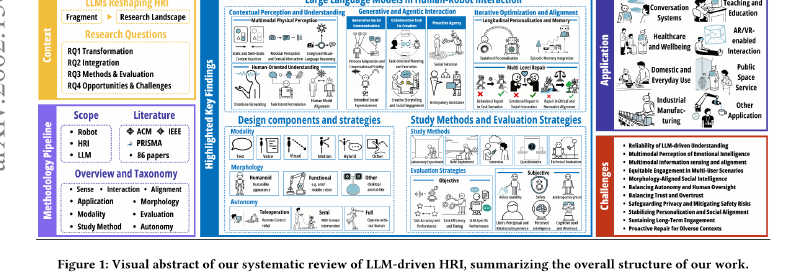
- Wang, Xu, Nikolova他 (2026) “How Do We Research Human-Robot Interaction in the Age of Large Language Models? A Systematic Review”(CHI ‘26、バルセロナ)は、2015〜2025年のLLM駆動HRI研究86本をPRISMAガイドラインに沿って体系的にレビューした論文。これまで個別に読んできた論文群が、研究分野全体の中でどこに位置づけられるかを整理する
論文の概要
- 著者はThe Hong Kong University of Science and Technology (Guangzhou)を中心とするチーム。ACM Digital Library・IEEE Xploreを主データベースに、Nature・Science Robotics・Computers in Human Behavior・International Journal of Social Roboticsを加えた学際的な検索を実施
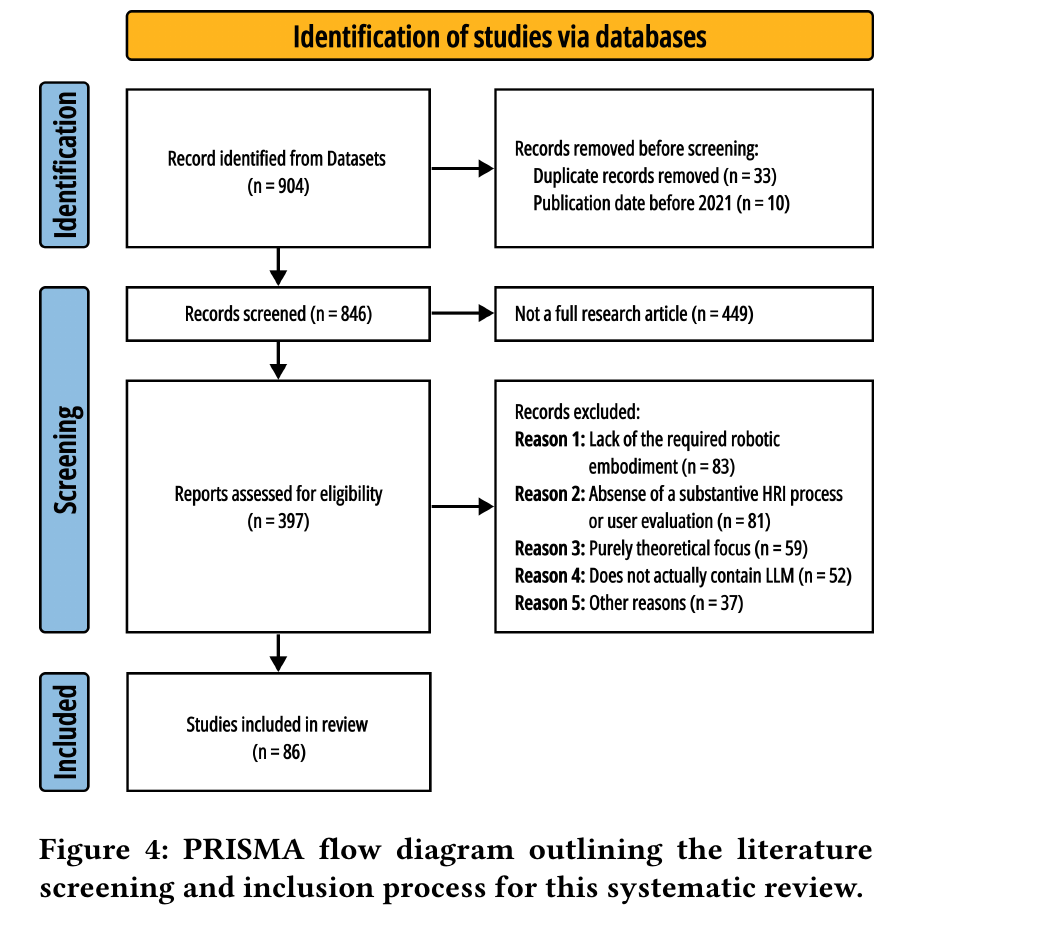
- 904件の初期レコードから、重複除去・2021年以前の除外・タイトル/抄録スクリーニング・全文評価を経て、最終的に86本の論文を採用している(PRISMA 2020ガイドラインに準拠)
- 採用基準は、(1) 査読済みの英語フルペーパーであること、(2) ロボットへのLLM統合に関する実証研究であること、(3) 物理ロボットまたは高精細なVR/ARアバターなど身体性を持つエージェントが対象であること、(4) ユーザーとのインタラクション・評価プロセスを含むこと
- コーダー間の一致度はCohenのカッパ係数で評価されており、評価が難しいカテゴリ(Contextual Perception and Understandingなど)はκ=0.720、表層的に判断しやすいカテゴリ(ロボットの形態など)はκ=0.894と、カテゴリによって差がある
- 論文のFig. 4に、この選定プロセスがPRISMAフロー図としてまとめられている
研究の全体像: Sense-Interaction-Alignmentフレームワーク
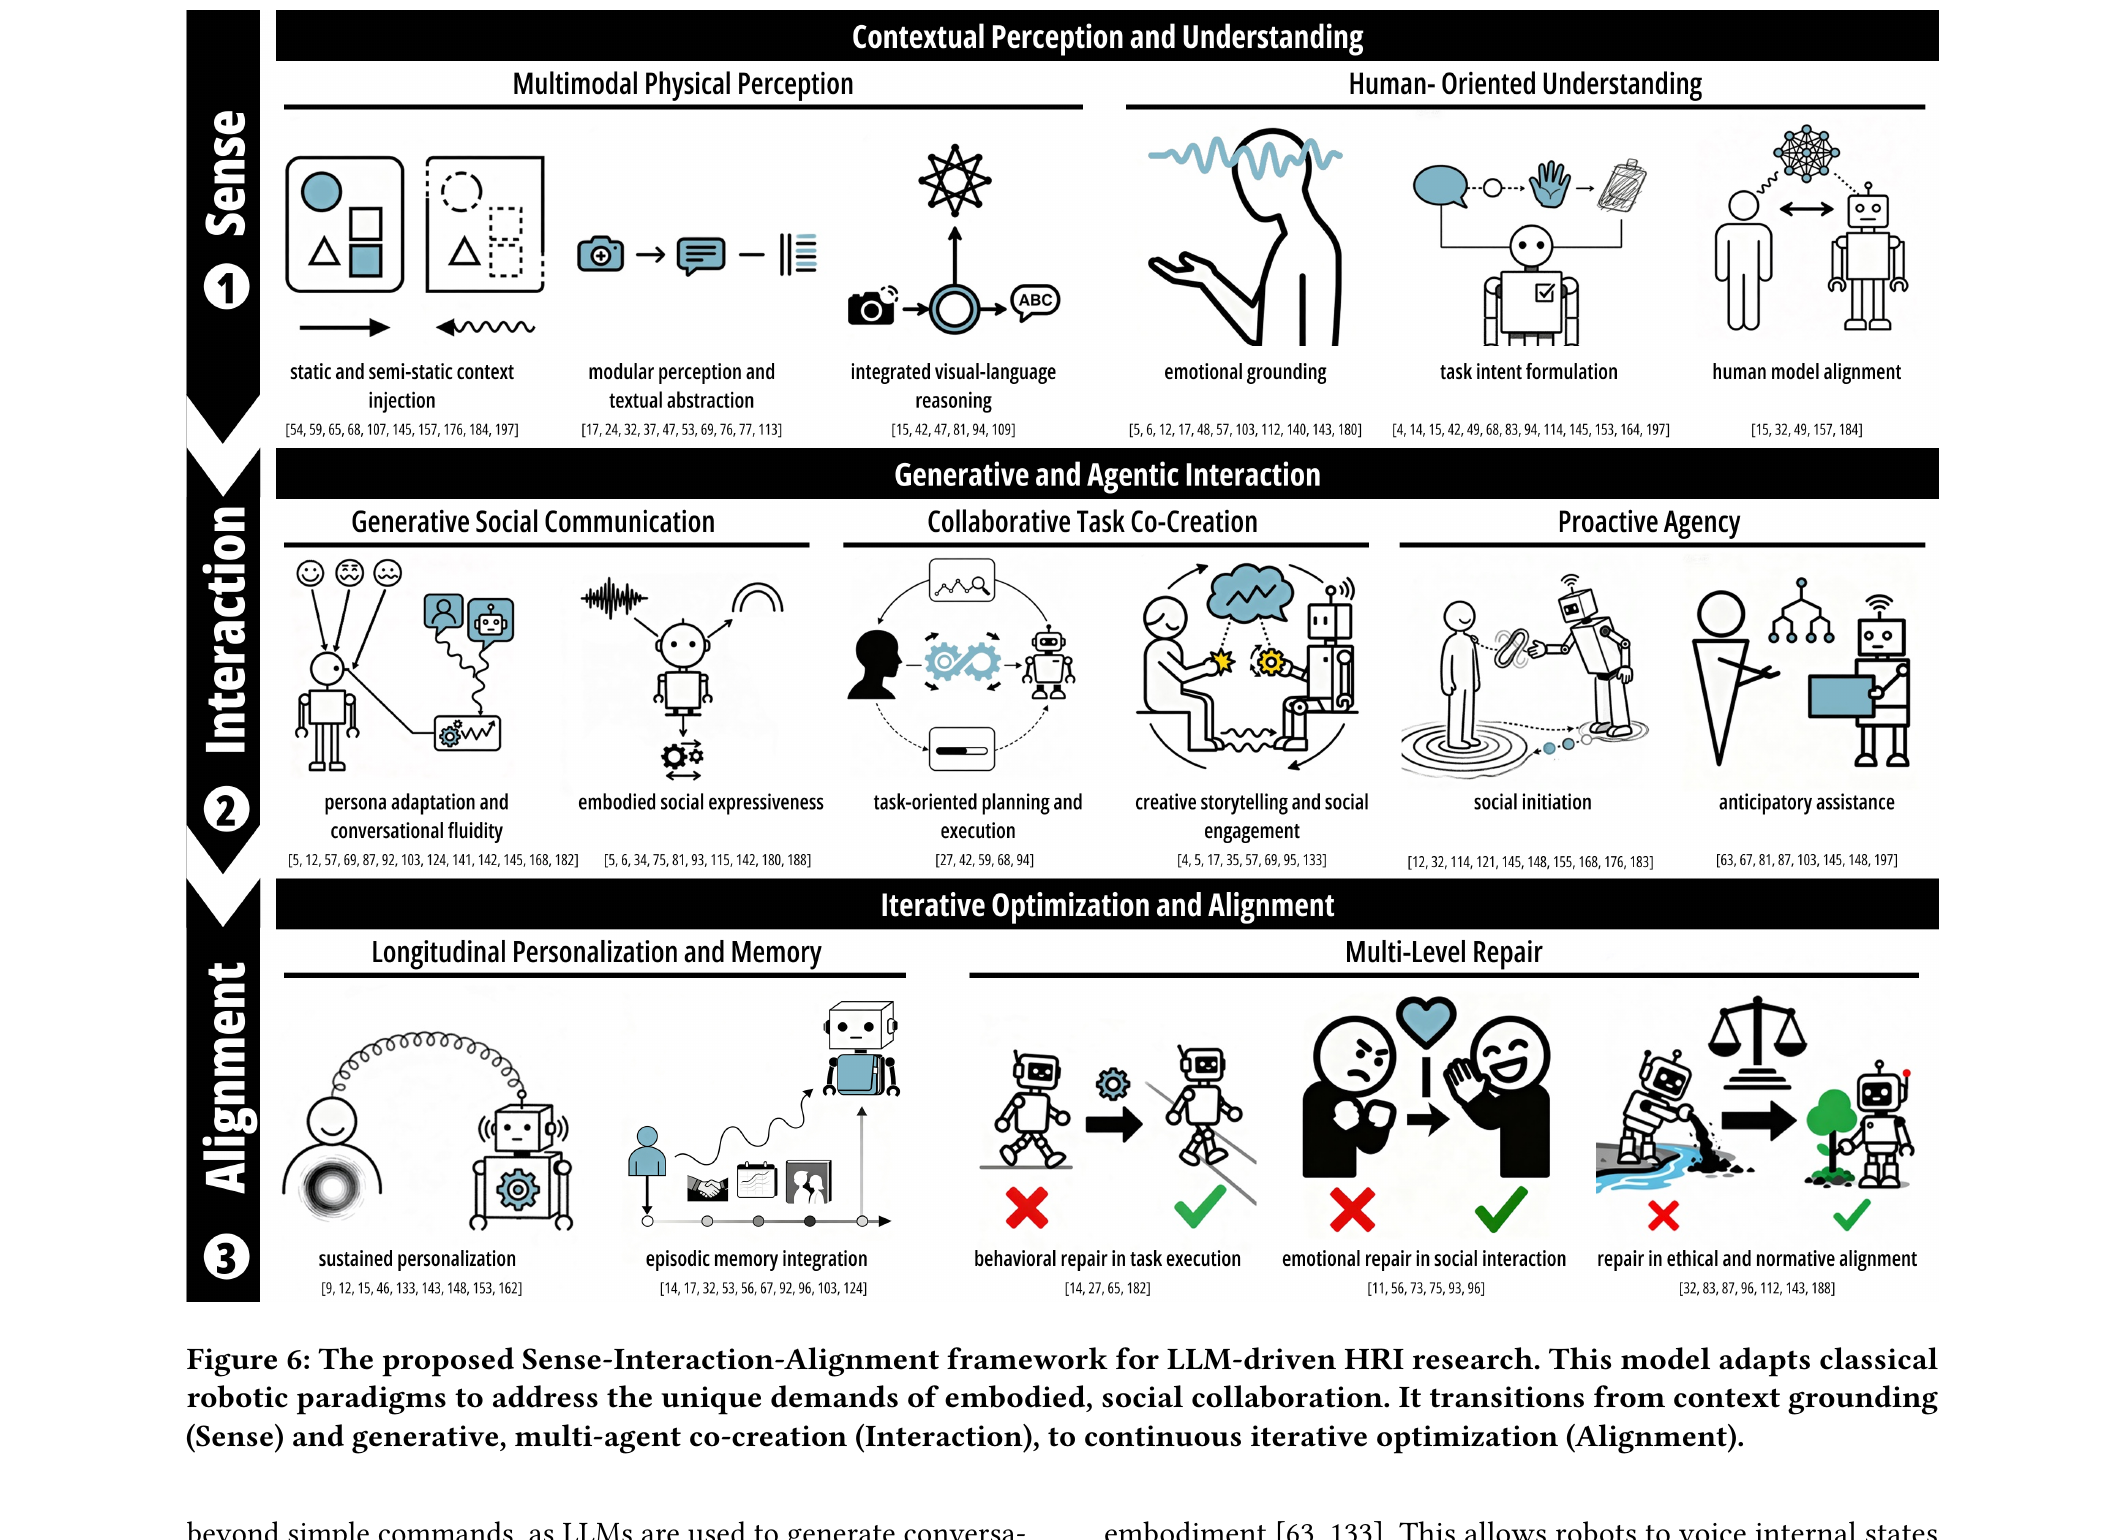
- 従来のロボティクスにおける「Sense-Plan-Act」「Reason+Act」という枠組みを、LLM駆動HRI向けに再構成した「Sense-Interaction-Alignment」という3段階のフレームワークを提案している
| 段階 | 内容 |
|---|---|
| Sense(知覚) | 生のセンサー入力を、意味のある文脈として理解する段階。物理的な知覚だけでなく、感情・意図・暗黙の社会規範まで含む |
| Interaction(相互作用) | 単発の行動実行ではなく、プロアクティブかつ生成的な、マルチエージェント的な協働として相互作用を捉え直す段階 |
| Alignment(整合) | Human-in-the-Loopを前提に、継続的な個人適応・修復を通じて、ロボットの行動を人間のニーズ・社会規範と整合させ続ける段階 |
- 論文のFig. 6に、この3段階と、各段階に含まれるサブカテゴリの全体像がまとめられている
Sense: Contextual Perception and Understanding
- Multimodal Physical Perception(物理的な多感覚知覚): 静的・準静的なコンテキストをプロンプトに埋め込む手法から、YOLO・SAMなどで物体を抽出してテキスト化するモジュール式知覚、VLM(Vision-Language Model)による直接的な視覚言語推論へと発展してきている
- Human-Oriented Understanding(人間指向の理解): 表情・声の抑揚などから感情を読み取る「Emotional Grounding」、曖昧な発話から具体的なタスクを切り出す「Task Intent Formulation」、暗黙の社会規範まで内面化する「Human Model Alignment」(Zero-Shot Human Modelとも呼ばれる、Theory-of-Mind的な能力)に分けられる
Interaction: Generative and Agentic Interaction
- Generative Social Communication: Big Fiveなどの性格特性に基づいて会話の個性を調整する「Persona Adaptation」、うなずきなどの非言語動作と発話を同期させる「Embodied Social Expressiveness」
- Collaborative Task Co-Creation: タスクの計画・実行を人間とロボットで共有する「Task-Oriented Planning」、物語を共創する「Creative Storytelling and Social Engagement」
- Proactive Agency: ユーザーに先んじて話しかける「Social Initiation」、ユーザーのニーズを先読みする「Anticipatory Assistance」
Alignment: Iterative Optimization and Alignment
- Longitudinal Personalization and Memory: 短期的な調整を超えて、長期的に意思決定モデルを洗練させる「Sustained Personalization」、過去のやり取りを蓄積する「Episodic Memory Integration」
- Multi-Level Repair(多層的な修復): タスク実行の失敗に対応する「Behavioral Repair」、関係性の摩擦に対応する「Emotional Repair」、倫理・規範からの逸脱に対応する「Repair in Ethical and Normative Alignment」の3層に分けて整理されている
設計コンポーネントと戦略: モダリティ・モルフォロジー・自律性
モダリティ(やり取りのチャネル)
| モダリティ | 内容 |
|---|---|
| Text | 直接的なコマンド入力から、会話的なやり取り、タブレット等へのシステム出力まで |
| Voice | ASR(音声認識)→LLM→TTS(音声合成)というパイプラインが主流。抑揚・速度などパラ言語的特徴も扱われ始めている |
| Motion | 高レベルのタスク計画をLLMが担い、低レベル制御は従来のロボティクス技術に任せる。目的達成型の「Functional motion」と、身振りなど伝達目的の「Expressive motion」に分かれる |
| Visual | 画面への情報提示、表情・ジェスチャーの生成、VLMによる視覚的状況把握など |
| Hybrid | テキスト・音声・身振りなど複数チャネルを統合する、最も高度な構成 |
| Tangible & Haptic | 直接的な身体接触によるガイド、タッチ入力など |
| Proximity | ユーザーとの距離という社会的シグナルを扱う |
モルフォロジー(身体の形態)
- Humanoid(Pepper・Nao・Furhat・QTrobot・ARI・Navel・Geminoid F・Mobiなど)が最も多く使われている
- Functional(TurtleBot・Segway・ロボットアームなど、タスク遂行重視)、Zoomorphic(動物型)、Desktop companion(Haruなど卓上型)、その他(車両ベースのエージェントなど)も研究されている
自律性のレベル
| レベル | 内容 |
|---|---|
| Teleoperation | 人間が直接制御。LLMは操作者の高レベル指示を低レベル動作に翻訳する役割 |
| Semi-Autonomy | システム障害・不適切な応答・物理的な安全リスクを軽減するため、人間の監督を残す。Wizard-of-Ozによる人間介入もここに含まれる |
| Full Autonomy | 人間の直接制御なしに、社会的に自然な振る舞いをエンドツーエンドで生成することを目指す |
研究手法と評価指標
研究手法
- Laboratory Experiment(統制されたラボ実験)、Field Deployments(実環境への長期展開)、Interviews(半構造化インタビュー)、Questionnaires(事前・事後アンケート)、Technical Evaluation(応答遅延・コード生成成功率などの技術評価)、その他(Wizard-of-Oz・ケーススタディ・シミュレーション・co-designワークショップ・ボディストーミング・think-aloud法)という6つに分類されている
評価指標
- 客観的評価: タスク完了時間・応答遅延・対話ターン数などの「Task Efficiency and Timing」、成功率・精度スコアなどの「Task Accuracy and Performance」、LLM自体の予測精度・生成品質を測る「LLM-Specific Performance」
- 主観的評価: 満足度・受容性・エンゲージメントなどの「User’s Perceptual and Relational Experience」、事実性・Theory of Mind・感情知能を含む「Perceived Intelligence」、「Anthropomorphism(擬人化)」、「Usability」、「Safety」、「Cognitive Load and Workload」
応用領域と11の課題
8つの応用領域
- Social and Conversational Systems、Healthcare and Wellbeing、Domestic and Everyday Use、Public Space Service、Industrial Manufacturing、AR/VR-enabled Interactions、Teaching and Education、Otherの8領域に分類されている
- SPRING: 高齢者介護施設における社会的ロボットの実証実験は、このうちHealthcare and Wellbeing(認知健康評価・感情的支援)とSocial and Conversational Systemsの両方にまたがる研究にあたる
11の課題
- Sense-Interaction-Alignmentの3段階に対応する形で、11の課題が整理されている
| 区分 | 課題 |
|---|---|
| Sense(1〜4) | 1. LLM駆動理解の信頼性、2. マルチモーダルな感情知能の知覚、3. マルチモーダル情報のセンシングと整合、4. 複数ユーザー間の公平なエンゲージメント |
| Interaction(5〜8) | 5. モルフォロジーに応じた社会的知性、6. 自律性と人間の監督のバランス、7. 信頼と過信のバランス、8. プライバシーの保護と安全リスクの緩和 |
| Alignment(9〜11) | 9. パーソナライゼーションと社会的整合の安定化、10. 長期的エンゲージメントの持続、11. 多様な文脈に応じたプロアクティブな修復 |
- 課題3「マルチモーダル情報のセンシングと整合」は、SPRING記事で扱ったPerson Manager(Mr. Potato algorithm)が、顔・身体・声という複数モダリティの情報を1人の人物として整合させる仕組みと直接対応する
- 課題1「LLM駆動理解の信頼性」は、NLIによるパラフレーズ対策の記事で扱った、パラフレーズによる意味ドリフトやハルシネーションのリスクとも重なる
- 課題11「プロアクティブな修復」は、SPRING記事で扱ったPetri-Net Plannerベースの行動修復(タスク実行・社会的インタラクション・倫理整合の3層)と対応する
まとめ
- このレビューは、LLM駆動HRI研究86本を対象に、Sense-Interaction-Alignmentという新しいフレームワークを提案し、研究分野全体を体系化したシステマティックレビュー
- Senseでは多感覚知覚と人間指向の理解、Interactionでは生成的・協調的・プロアクティブな相互作用、Alignmentでは長期的な個人適応と多層的な修復という、3段階で研究動向を整理している
- モダリティ・モルフォロジー・自律性という3つの設計軸、研究手法・評価指標の分類、8つの応用領域、3段階に対応する11の課題を、それぞれ体系的なタクソノミーとして提示している
- これまで読んできたROS4HRI・SPRING・IJIMAIパラフレーズ論文・NLI対策は、このフレームワークの中でそれぞれ知覚基盤・実証システム全体・生成的相互作用・信頼性課題への対応、という異なる位置づけにあることが整理できた
参考文献
- Wang, Y., Xu, Y., Nikolova, A., Wang, Y., Wang, J., Wang, C., & Tong, X. (2026). “How Do We Research Human-Robot Interaction in the Age of Large Language Models? A Systematic Review.” In Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI ‘26), Barcelona, Spain. (DOI:10.1145/3772318.3790920、PDF)
- ROS4HRIの仕組み
- SPRING: 高齢者介護施設における社会的ロボットの実証実験
- ロボット発話のパラフレーズが意味を壊す問題とNLIによる対策