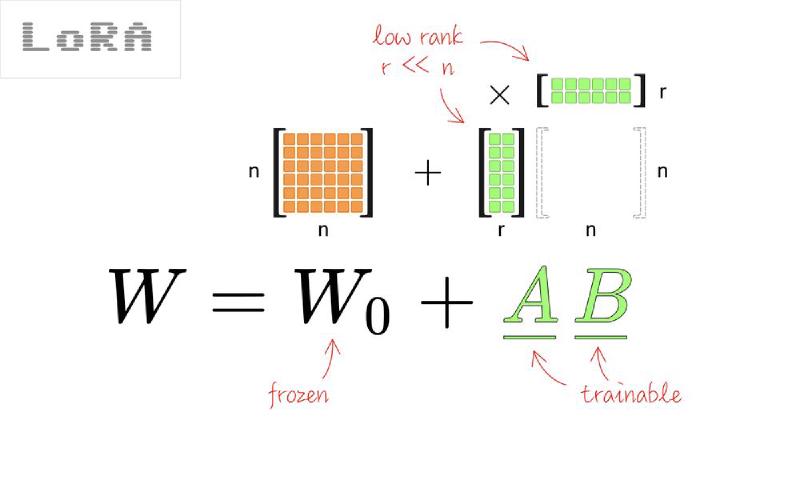
目次
背景
- 仕事で、LLMの挙動を完璧にするために、FTをしている
- そこで、実際にFine-tuningをするとして、どんな手法があるのかを整理しておく
- SFT・PEFT・DPO・それらを実装するためのライブラリという流れでまとめる
SFT(Supervised Fine-Tuning)
基本的な考え方
- 「入力(プロンプト)→望ましい出力(completion)」のペアを大量に用意し、通常の次トークン予測の損失で学習する
- 事前学習と学習方法自体は同じだが、対象データが「望ましい応答例」に絞られている点が異なる
- 新しい知識を教えるというより、既に持っている能力をどう引き出すか(フォーマット・口調・振る舞い)を教える用途に向いている
使いどころ
- 特定のフォーマットや口調を安定して守らせたい場合
- 望ましい出力例を人手で用意できる場合
- 弱点は、「何をしてほしいか」は教えられるが、「複数の候補のうちどちらがより良いか」という相対的な好みまでは教えにくい点
PEFT(Parameter-Efficient Fine-Tuning)
フルファインチューニングとの違い
- フルファインチューニングは、モデルの全パラメータを対象に、通常の学習と同じように勾配を計算して更新する
- 全パラメータ分の勾配に加えて、Adamのようなオプティマイザは各パラメータごとに複数の状態(モーメンタムなど)を保持するため、モデル本体の重みだけでなく、その数倍のメモリを追加で必要とする
- 数十億〜数百億パラメータのモデルでは、この必要メモリ量が非現実的になりやすい
- 更新できる範囲に制限が無いため、理論上はPEFTより高い性能の天井を狙えるが、その分、元のモデルが持っていた能力を上書きして失ってしまう破滅的忘却(catastrophic forgetting)のリスクもPEFTより高くなりやすい
- PEFTは、元のモデルの重みは凍結したまま、少数の追加パラメータだけを学習することで、フルファインチューニングに近い効果を低コストで狙う手法群の総称
- 元の重みを凍結している分、破滅的忘却も起きにくく、少ないデータ・少ない試行回数で何度も条件を変えて試したい場面(前述の多信頼度最適化のような運用)とも相性が良い
LoRA以前のPEFT手法
LoRAが登場する以前から、PEFTという発想自体はいくつかの形で提案されていた。
- Adapter Tuning(Houlsby et al., 2019): Transformerの各層の間に、ボトルネック型の小さな層(Adapter)を挿入し、そこだけを学習する
- Prefix-tuning(Li & Liang, 2021): 各層の入力に、学習可能な仮想トークン(連続値のベクトル)を追加する
- Prompt Tuning(Lester et al., 2021): Prefix-tuningを単純化し、入力層にだけ学習可能な埋め込みを追加する
- BitFit(Zaken et al., 2021): モデルのバイアス項だけを学習対象にする、極端にパラメータ数を絞った手法
- これらAdapter・Prefix・Prompt系の共通の弱点は、推論時にも追加の層・トークンを通す必要があり、推論コスト(レイテンシ)が増えること
- LoRAが広く使われるようになった理由の1つは、学習後に$BA$を$W$へマージでき、推論時には追加コストがゼロになる点にある
LoRA(Low-Rank Adaptation)
- 出発点になっている仮説は、「ファインチューニングで生じる重みの更新分$\Delta W$は、見かけの次元より小さい、低い"本質的なランク"に収まる」というもの
- 元の重み行列$W$はそのまま凍結し、$\Delta W$を低ランクの行列$A$・$B$の積で近似して、その部分だけを学習する
- $W \in \mathbb{R}^{d \times k}$に対して、$A \in \mathbb{R}^{r \times k}$、$B \in \mathbb{R}^{d \times r}$とし、ランク$r$を$d$や$k$よりずっと小さく取る($r=8$や$16$など)
- 元の$W$が$d \times k$個のパラメータを持つのに対し、追加分は$r \times (d + k)$個で済むため、$r$が小さいほど学習対象のパラメータ数を大幅に減らせる
- $A$はランダムな値で初期化し、$B$はゼロで初期化する。これにより学習開始時点では$BA=0$となり、ベースモデルと全く同じ出力から学習を始められる
- 主に注意機構のQuery・Valueの射影行列に適用されることが多いが、対象にする層は設定で選べる
- 推論時には$BA$を$W$に足し込める(マージできる)ため、推論速度への影響も小さい
QLoRA
QLoRAは、単に「ベースモデルを4bit量子化してLoRAを載せる」だけでなく、いくつかの技術的な工夫によってそれを実用的な精度で成立させている。
- NF4(4-bit NormalFloat): ニューラルネットの重みがおおむね正規分布に従うという性質に対して理論的に最適な4bitのデータ型で、単純な4bit整数量子化より情報の損失が少ない
- 二重量子化(Double Quantization): 量子化の際に生じる定数(スケール値)自体もさらに量子化することで、メモリ使用量を追加で削減する
- ページングオプティマイザ(Paged Optimizer): GPUメモリが一時的に不足した際、オプティマイザの状態をCPUメモリ側に退避させることで、勾配チェックポイントなどによる瞬間的なメモリ不足でクラッシュするのを防ぐ
- これらの工夫により、ベースモデルのメモリ使用量を大きく削減しつつ、フル精度でのLoRAに近い精度を維持できるとされている
LoRA以降の発展
LoRAが定番になった後も、その弱点を補う派生手法がいくつも提案されている。
- DoRA(Weight-Decomposed LoRA): 重みを大きさ(magnitude)と方向(direction)に分解し、それぞれ別々に学習することで、フルファインチューニングにより近い挙動を目指す
- AdaLoRA: 全ての層に一律のランク$r$を割り当てるのではなく、層ごとの重要度に応じてランクを動的に調整する
- SVD(特異値分解)を活用した派生手法群
- SVF(Singular Value Fine-tuning): 特異値そのものを直接調整する、LoRAよりさらにパラメータ効率の良い手法
- SVFT: SVFを拡張し、対角以外にも学習可能なパラメータを追加する
- PiSSA: 主要な(大きい)特異値だけを調整し、フルファインチューニングの近似を狙う
- MiLoRA: PiSSAとは逆に、小さい特異値だけを調整する
- LoRA-XS: PiSSAに近い発想で、さらに少ないパラメータでの学習を狙う
- どれも「LoRAの低ランク近似という発想を維持しつつ、どこにどれだけパラメータを割り当てるか」を工夫した手法群と位置づけられる
大まかな系譜を整理すると、以下のようになる。
| 手法 | 発想 | 位置づけ |
|---|---|---|
| Adapter / Prefix / Prompt Tuning | 層の間・入力に学習可能な要素を追加 | LoRA以前、推論コストが増える |
| BitFit | バイアス項だけ学習 | LoRA以前、極端に軽量 |
| LoRA | 重み更新分を低ランク行列で近似 | 定番、推論後にマージ可能 |
| QLoRA | LoRA+ベースモデルの4bit量子化 | LoRAの省メモリ版 |
| DoRA | 重みを大きさと方向に分解 | LoRAの精度改善 |
| AdaLoRA | 層ごとにランクを動的配分 | LoRAの配分最適化 |
| SVF / SVFT / PiSSA / MiLoRA / LoRA-XS | 特異値分解を活用 | LoRAよりパラメータ効率を追求 |
強化学習・選好学習という枠組み
SFTとの違い
- SFTは「入力に対して、この出力が正解」という単一の正解例から学習する
- 一方、強化学習・選好学習(Preference Learning)は「AとBという2つの候補のうち、Aの方が好ましい」という相対的な比較から学習する
- 単一の正解を書き下すのが難しいタスク(文章の質・安全性・好みなど、絶対的な正解が定まらないもの)でも、「どちらがマシか」という比較なら人間が判断しやすいことが多く、この違いが選好学習のモチベーションになっている
PPOベースのRLHF
- 人間の好みに合わせてモデルを調整する手法として、最初に主流になったのがPPO(Proximal Policy Optimization)を使うRLHF(Reinforcement Learning from Human Feedback)
- 大きく2段階で構成される
- 好みのペアデータ(chosen/rejected)から、出力の良さをスコア化する報酬モデルを別途学習する
- その報酬モデルをスコア関数として使い、強化学習(PPO)でLLM自体(ポリシー)を更新する
- 参照モデルから大きく逸脱しないよう、KLダイバージェンスによる制約も同時にかける
- 報酬モデルの学習とRLのループという2段階構成のため、実装が複雑で、学習も不安定になりやすいという課題があった
DPOという簡略化
- DPO(Direct Preference Optimization)は、報酬モデルの学習や強化学習のループを介さず、好みのペアデータから直接ポリシーを最適化する手法として提案された
- RLHFと同じ問題を、報酬モデルを明示的に学習せずに解けることを理論的に示した点が特徴
損失関数
DPOの損失は、以下のように定義される。
$$ \mathcal{L}_{\text{DPO}} = -\mathbb{E}_{(x, y_w, y_l) \sim D}\left[\log \sigma\left(\beta \log\frac{\pi_\theta(y_w \mid x)}{\pi_{\text{ref}}(y_w \mid x)} - \beta \log\frac{\pi_\theta(y_l \mid x)}{\pi_{\text{ref}}(y_l \mid x)}\right)\right] $$- $x$: 入力(プロンプト)
- $y_w$: 好ましい出力(chosen)
- $y_l$: 好ましくない出力(rejected)
- $\pi_\theta$: 学習対象のモデル、$\pi_{\text{ref}}$: 学習開始前の状態で固定した参照モデル
- $\beta$: 参照モデルからどれだけ離れることを許容するかを決める温度パラメータ
イメージ:
- 直感的には、「chosenの相対的な確率(参照モデル比)を上げ、rejectedの相対的な確率を下げる」ように学習する
- 報酬モデルを別に学習する必要が無く、SFTと同じような教師あり学習の枠組みで扱える分、実装・運用が比較的シンプル
chosen/rejectedペアの作り方
- DPOには、同じ入力に対する「良い出力(chosen)」と「悪い出力(rejected)」のペアが必要
- chosenは、人手で書いた正解や、実際にうまくいった出力から用意する
- rejectedは、ゼロから捏造する必要は無い。デバッグの過程で実際に得られた失敗出力が、そのままrejectedとして使える
- 例えば、前述の記事で扱ったような「直前のやり取りを無視する」失敗パターンが再現した際の実際の出力は、そのタスクにおける典型的な失敗例として、質の高いrejectedデータになる
- つまり、デバッグでtabula rasa法・pytest xfailなどを使って集めた再現ケースの出力ログが、そのままDPOの学習データの元になる
ライブラリ: TRL
概要
- Hugging Faceが提供するTRL(Transformer Reinforcement Learning)ライブラリは、SFT・DPO・PPOなど、この記事で扱った手法をまとめて実装できるライブラリ
SFTTrainer・DPOTrainer・PPOTrainerのように、手法ごとに専用のTrainerクラスが用意されている
実装の流れ
- SFTを行う場合は
SFTTrainerに、プロンプトとcompletionのペアを持つデータセットを渡す - DPOを行う場合は
DPOTrainerに、prompt・chosen・rejectedの3列を持つデータセットを渡す - PEFT(LoRA・QLoRA)と組み合わせる場合、
peft_config(LoRAのランクなどを指定した設定)を渡すだけで、Trainer側が凍結・低ランク行列の追加を面倒みてくれる - つまり、フルファインチューニング・PEFT・SFT・DPOの組み合わせを、同じライブラリの中で切り替えながら試せる
関連手法
- DPO以降も、ORPO(Reference-free方式でreferenceモデルを不要にする)・KTO(ペアではなく単一の良い/悪いラベルから学習する)のような派生手法が提案されており、TRLはこれらもサポートしている
- どれも「報酬モデル+強化学習」というRLHFの複雑さを避け、好み(または単一ラベル)から直接ポリシーを最適化するという発想は共通している
まとめ
- SFTは「何をしてほしいか」を教える手法で、DPOは「複数の候補のうちどちらが好ましいか」という相対的な好みを教える手法という違いがある
- LoRA・QLoRAのようなPEFT手法を使えば、フルファインチューニングより大幅に少ない計算資源でこれらを実行できる
- PEFTにはLoRA以前からAdapter・Prefix-tuning・Prompt Tuning・BitFitのような系譜があり、LoRAが広まった理由は学習後に重みへマージでき推論コストが増えない点にある。LoRA以降もDoRA・AdaLoRA・SVD系(SVF・SVFT・PiSSA・MiLoRA・LoRA-XSなど)の発展形が提案されている
- DPOのrejectedデータは、デバッグ中に実際に再現させた失敗出力をそのまま流用できるため、プロンプト側のデバッグ作業とFine-tuningのデータ作成が地続きになる
- TRLライブラリを使えば、SFT・DPO・PEFTの組み合わせを同じ枠組みで実装できる
参考文献
- Rafailov, R. et al. (2023). “Direct Preference Optimization: Your Language Model is Secretly a Reward Model” (arXiv:2305.18290)
- Houlsby, N. et al. (2019). “Parameter-Efficient Transfer Learning for NLP” (Adapter Tuning, arXiv:1902.00751)
- Li, X. L. & Liang, P. (2021). “Prefix-Tuning: Optimizing Continuous Prompts for Generation” (arXiv:2101.00190)
- Lester, B. et al. (2021). “The Power of Scale for Parameter-Efficient Prompt Tuning” (arXiv:2104.08691)
- Zaken, E. B. et al. (2021). “BitFit: Simple Parameter-efficient Fine-tuning for Transformer-based Masked Language-models” (arXiv:2106.10199)
- Hu, E. J. et al. (2021). “LoRA: Low-Rank Adaptation of Large Language Models” (arXiv:2106.09685)
- Dettmers, T. et al. (2023). “QLoRA: Efficient Finetuning of Quantized LLMs” (arXiv:2305.14314)
- Liu, S. et al. (2024). “DoRA: Weight-Decomposed Low-Rank Adaptation” (arXiv:2402.09353)
- Zhang, Q. et al. (2023). “AdaLoRA: Adaptive Budget Allocation for Parameter-Efficient Fine-Tuning” (arXiv:2303.10512)
- Ouyang, L. et al. (2022). “Training language models to follow instructions with human feedback” (InstructGPT/RLHF, arXiv:2203.02155)
- TRL - Transformer Reinforcement Learning - Hugging Face Docs
- PEFT - Hugging Face Docs
- Are You Still Using LoRA to Fine-Tune Your LLM? | Towards Data Science