目次
背景
- グー・チョキ・パーのように見た目が近いクラス(インナークラス、クラス内の多様性が低い)は正しく分類できるのに、人とペットボトルのように見た目が大きく異なるクラス(インタークラス)の方が、かえって分類に失敗することがあった
- 直感的には逆のはず。似ているクラスより、全く違うクラスの方が簡単に分けられると考えるのが自然
- 分類器の比較で埋め込み空間の構造を診断するでは、複数の分類器族の精度パターンから埋め込み空間の幾何構造を事後的に診断する方法を整理した
- 今回はこの逆転現象を説明するために、埋め込み空間の幾何構造を先に測定し、それに応じて使う分類方式そのものを動的に選ぶという設計を考える
- Embeddingベースの分類器を設計していて、特徴空間(Feature Space)上のクラス分布をどう評価するかを考える必要があった
- 最初は「狭い・広い」「ばらつきが多い・少ない」のような軸で考えていたが、これらはかなり重複していて、分類の難しさを説明しきれなかった
- そこで特徴空間を理解するための軸を洗い出し直し、最終的に「測った幾何構造に応じて分類方式そのものを動的に切り替える」という設計思想にたどり着いた
- ここではこれをGeometry-Aware Adaptive Classification(幾何構造を考慮した適応型分類)と呼ぶが、これは設計上の呼び方であって、既存の確立した単一手法を指すものではない
特徴空間を表現する8つの軸
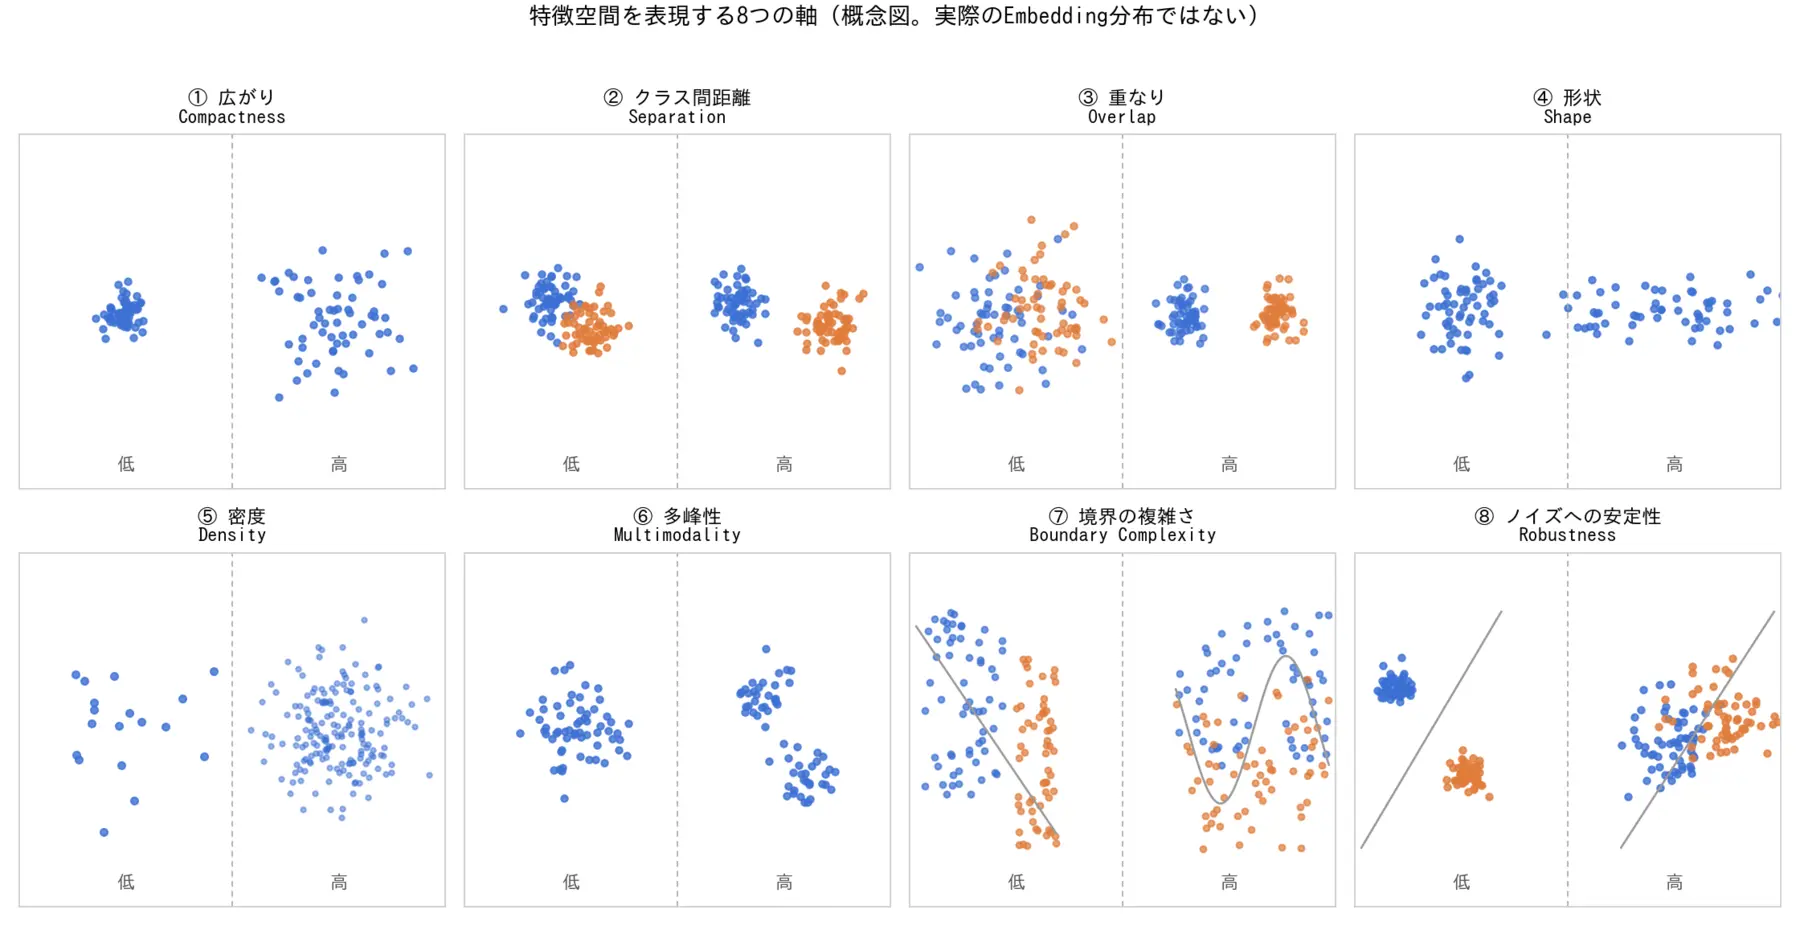
- 特徴空間を理解するには、大きさ・距離・重なり・形状・密度・境界・次元・安定性のような軸で整理すると見通しが良くなる
| 評価軸 | 確認したいこと | 代表的な指標 |
|---|---|---|
| ① 広がり(Compactness) | 1クラスがどれほど広いか | クラス内分散 |
| ② クラス間距離(Separation) | 異なるクラスがどれほど離れているか | 中心間距離 |
| ③ 重なり(Overlap) | 異なるクラスが混在しているか | k近傍の異クラス率 |
| ④ 形状(Shape) | 球状か、細長いか | 共分散行列の固有値 |
| ⑤ 密度(Density) | 点が密集しているか | k近傍距離 |
| ⑥ 多峰性(Multimodality) | 1クラス内に複数の集団があるか | クラスタリング |
| ⑦ 境界の複雑さ(Boundary Complexity) | 単純な境界で分離できるか | 線形分類器と非線形分類器の性能差 |
| ⑧ ノイズへの安定性(Robustness) | 入力の小さな変化で分類が変わるか | 摂動時の予測一致率 |
- 「ばらつき」は広がりだけでなく、形状や方向性も含めて考えられるので、共分散構造として別途評価する価値がある
Embeddingの分類器で重要になる3つの軸
- Embeddingモデルを使った分類器では、上の8軸に加えて次の3つが実用上重要になる
マージン(Margin)
- 正解クラスと、最も紛らわしい誤クラスとのスコア差
- これが小さいほど、分類が不安定になりやすい
クラスの分離可能性(Separability)
- 実際に分類器を使って、どれくらい分けられるかを確認する指標
- 例えば線形分類器では分離できないが、非線形分類器なら分離できるケースがある
- 単なる中心間距離より実用的な評価になる
データの代表性(Coverage)
- 用意したプロトタイプが、実際のクラスの多様な状態をどれほどカバーできているか
- 例えば「座っている」のプロトタイプが椅子に座る例しかなければ、床に座る人を誤分類する可能性がある
8+3の軸は独立ではない
- これらは完全に独立した軸ではなく、互いに影響し合う
- 広がりが大きいほど、他クラスと重なりやすい傾向がある
- 中心間距離が小さくても、分布が細長く異なる方向を向いていれば分離できることがある
- クラス内の分布が複数の集団に分かれていれば、単一の中心では表現しきれない
- マージンが小さくても、適切な非線形境界なら分類できる場合がある
- したがって、単純に「狭い・広い」「近い・遠い」だけでは分類難易度を完全には説明できない
まず測るべき5つの指標
- 11軸すべてを毎回測るのは非現実的なので、優先度をつけて絞り込む
| 優先度 | 指標 | 目的 |
|---|---|---|
| 1 | クラス内分散 | プロトタイプが1つで十分か |
| 2 | クラス間距離 | クラス同士が近いか |
| 3 | クラス間重複 | 誤分類が起こりやすいか |
| 4 | マージン分布 | 判定の曖昧さがどの程度あるか |
| 5 | 多峰性 | 複数プロトタイプが必要か |
- この5つを測定すれば、グー・チョキ・パーのような単純な分類と、立つ・座る・倒れるのような曖昧さを含む分類の違いを、かなり定量的に説明できる可能性がある
そこから生まれる研究仮説
- ここまでの整理から、次の仮説が立てられる
- これがGeometry-Aware Adaptive Classification(幾何構造を考慮した適応型分類)と呼べる設計思想
- クラス内分散が小さくクラス間距離が大きいなら、単純なFlat Softmaxで十分
- 多峰性が高ければ、1クラス1プロトタイプでは表現しきれないのでMulti-Prototypeが必要
- 重なりが大きくマージンが小さいクラスの組だけ、階層分類や専用分類器で個別に対処する、という使い分けが考えられる
- 繰り返しになるが、これは既存の確立した単一手法の名前ではなく、この整理から導かれた設計方針の呼び方
まとめ
Embedding空間のクラス分布は「狭い・広い」「近い・遠い」のような単純な軸では説明しきれず、広がり・クラス間距離・重なり・形状・密度・多峰性・境界の複雑さ・ノイズへの安定性という8軸と、マージン・分離可能性・データの代表性という3軸を合わせた11軸で見ると整理しやすい。これらは互いに独立ではなく、絡み合って分類の難しさを決めている。実用上はクラス内分散・クラス間距離・クラス間重複・マージン分布・多峰性の5つを優先的に測ることで、分類が簡単なケースと難しいケースを定量的に区別できる可能性がある。そこから導かれるのが、測定した幾何構造に応じて分類方式そのものを動的に切り替えるという設計思想、Geometry-Aware Adaptive Classification。