目次
背景
Transformerとは全く違う原理で動くというアーキテクチャ「Cadence」について知ったので、公開されているソースコードとドキュメントを読んで仕組みを整理した。Floating Pragma社(Bernd Müller氏)が開発しているオープンソースのPythonライブラリcadence-netで、現時点ではalpha版の研究用ソフトウェアという位置づけ。
Cadenceとは
目指しているもの
- 身体性を持つAGI(ロボットアーム・ゲーム環境など)を、バックプロパゲーションではなく「生きた経験からの継続学習」で実現しようとする研究プロジェクト
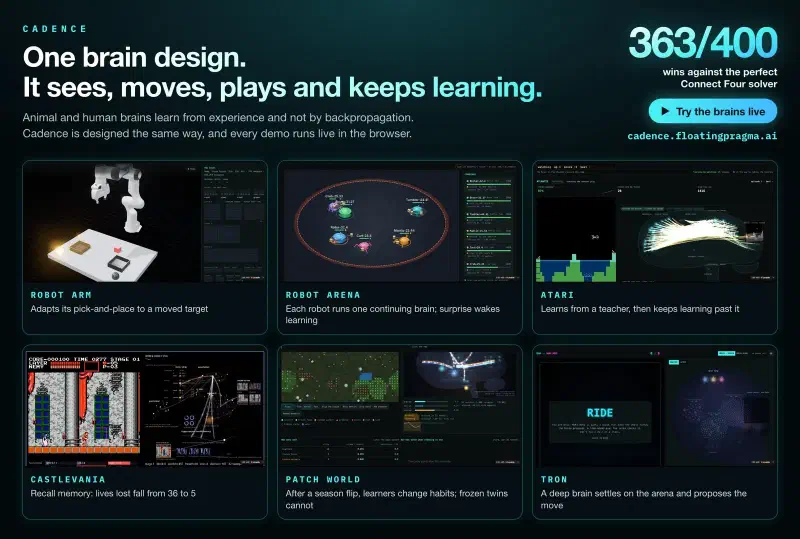
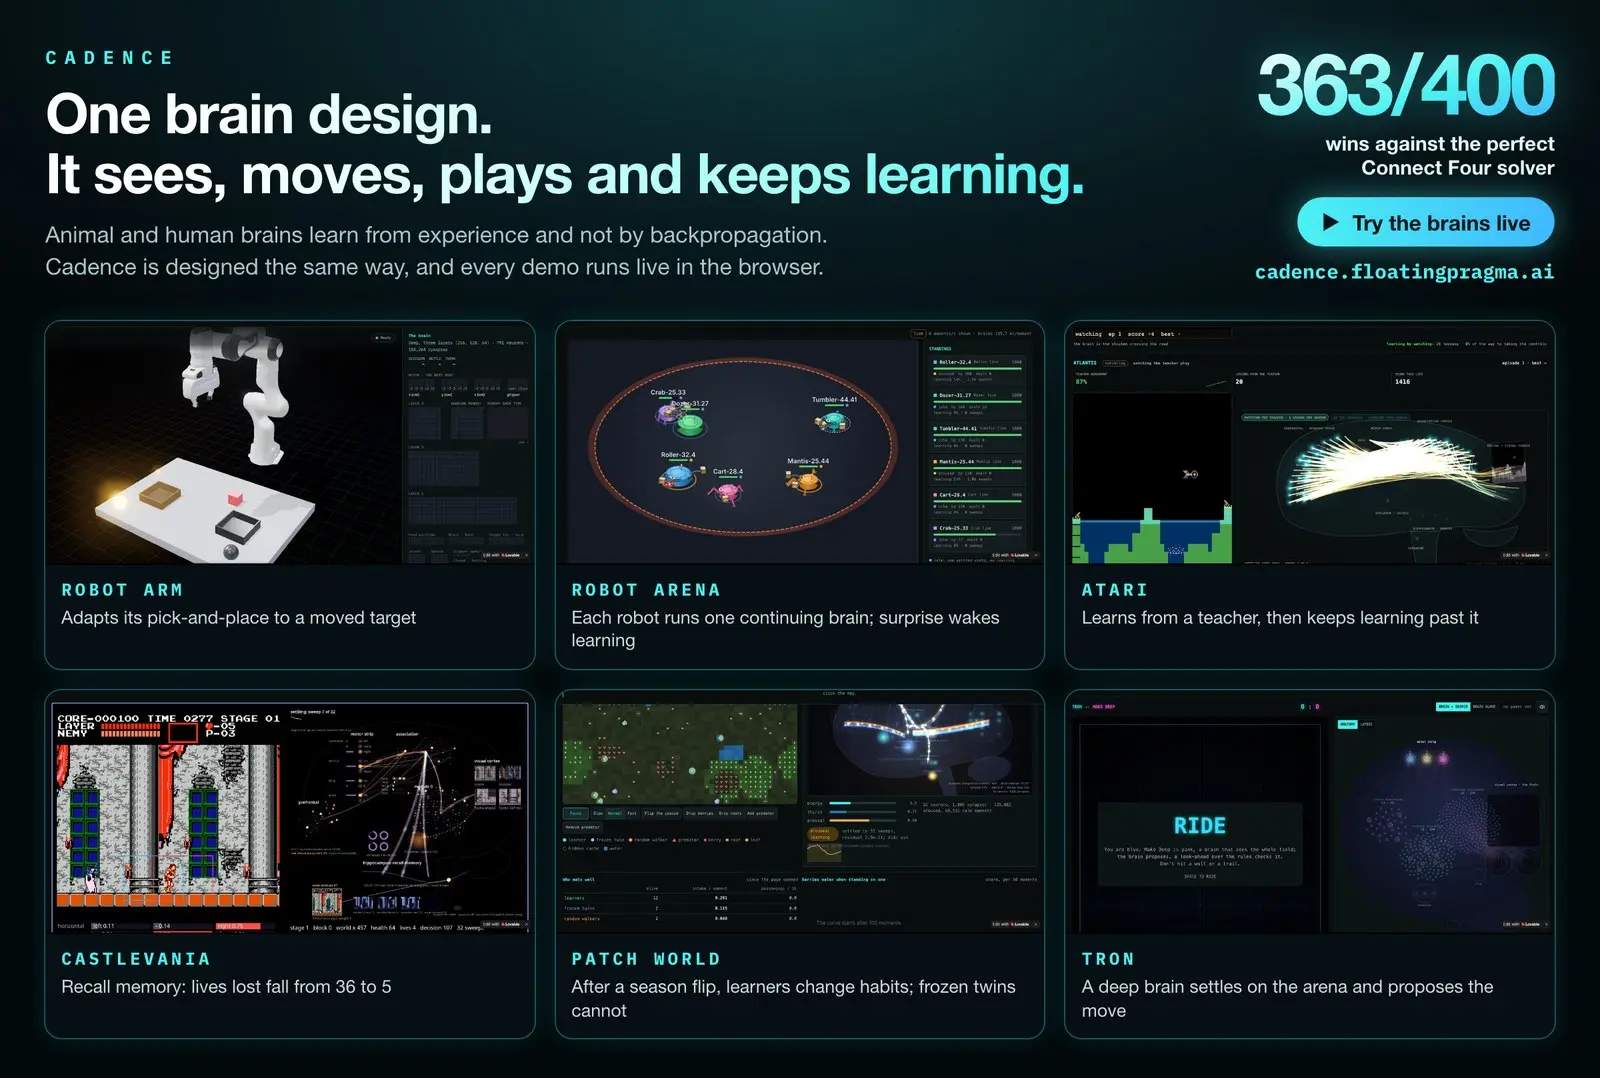
- 公式サイトのデモでは、ロボットアーム・マルチエージェントアリーナ・Atari・Castlevania・Patch World・Tronなど、同一のブレイン設計が複数の環境で動く様子を公開している
- Connect Fourの完全解法AIに対して400戦363勝という結果も示されている
Transformerとの位置づけの違い
| 観点 | Transformer | Cadence |
|---|---|---|
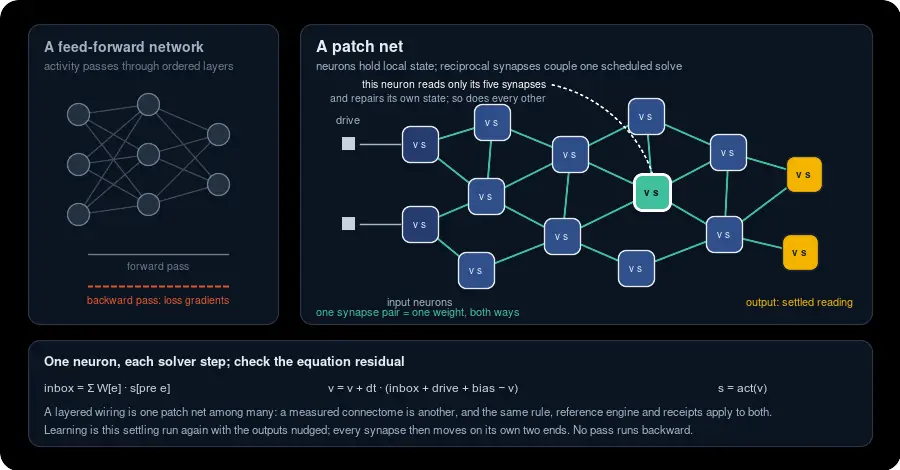
| 答えの出し方 | 層を順番に評価するフォワードパス | ニューロン群が平衡状態(equilibrium)に収束するまで繰り返し更新 |
| 学習方法 | 逆伝播(backprop)による勾配降下 | 自由なsettleと揺さぶったsettleの差分から局所的に更新(Equilibrium Propagation) |
| 推論と学習の切り替え | 訓練モードと推論モードが別 | 常に同じsettleという動作のみで、モードの切り替えがない |
| 文脈の持ち方 | KVキャッシュ・コンテキストウィンドウ | Working Trace(短期)と連想記憶・エピソード記憶(長期)として明示的に保持 |
全体のつながり
各仕組みがどう繋がっているかを図にすると以下のようになる。
flowchart LR
    Senses[感覚入力] --> Code[学習済みコード領域]
    Code --> Cortex[Cortex領域]
    Cortex <--> Assoc[連想野 Association]
    Assoc <--> Motor[運動野 Motor]
    Motor --> Action[行動]
    Trace[Working Trace<br>短期記憶] -. 直前の解釈を読み戻す .-> Assoc
    Assoc -. 書き込み .-> Trace
    Assoc --> Critic[Critic・ドパミン]
    Critic -. 報酬予測誤差 .-> Arousal[覚醒 Arousal]
    Arousal -. 学習・記憶書き込みをゲート .-> Assoc
    Recall[Recall Heads] -. 読み出し .-> Assoc
    Assoc -. クエリ .-> Recall
    Episodic[エピソード記憶] -. 投票 .-> Action
Action -. 結果を記録 .-> Episodic- 感覚入力からCortex・連想野・運動野までが1つの平衡(settle)の中で繋がっている点が最大の特徴で、Transformerのような層ごとの一方向の流れではない
- Working Traceは直前の解釈を次のsettleに戻すだけの単純な経路、Recall HeadsやCriticは連想野と相互に情報をやり取りしながら同じ平衡に参加する
仕組み1: 平衡状態への収束(Settling)
ニューロンの更新式
各ニューロン$i$は電位$v$と活性化$s$を持ち、毎ステップ以下の式で更新される。
$$ v_i \leftarrow v_i + dt \cdot (\mathrm{input}_i + \mathrm{drive}_i + \mathrm{bias}_i - v_i) $$$$ s_i = \mathrm{act}(v_i) $$- $\mathrm{input}_i$は、そのニューロンに届く全シナプスからの入力の重み付き和
- Transformerのように「層を1回通して終わり」ではなく、この更新を何十〜何百ステップも繰り返し、ニューロン群全体がそれ以上動かなくなる、つまり平衡状態に達するまで続ける
- この平衡状態そのものが「答え」になる。入力・連想・運動野(motor)に相当する領域の区別はなく、すべて同じ1つの平衡の中で解かれる
収束の保証
- 全ニューロンの「入ってくる有効重みの総和」が、活性化関数の最大傾き(Lipschitz定数)の逆数より小さいとき、1ステップの更新はBanachの不動点定理の意味で縮小写像になる
- これにより「平衡点がただ1つ存在し、有限ステップ後にそこへどれだけ近いか」を数式で保証できる(
cd.certificate(brain)として実装されている) - 「数値が収束したように見える」という経験則ではなく、理論的な収束保証を明示的に扱っている点が特徴
深い構成での工夫(Apical Compartment)
- 複数の領域を双方向につなげて積み重ねると、上位層からの信号(トップダウン)と下位層からの信号(ボトムアップ)が同じ入力として混ざり合い、ループの利得が重みとともに増大して発散に近づく
- 利得が高くなるにつれてsettleが遅くなり、各領域が入力の表現ではなく答えの残響(echo)を持つだけの状態になってしまい、領域を増やしても精度が上がらなくなる
- この対策として、大脳皮質の錐体細胞が基底樹状突起(ボトムアップ)と尖端樹状突起(トップダウン)を使い分ける構造を模した「Apical Compartment」を導入し、トップダウン入力の大きさをボトムアップ入力の一定割合以下に制限する
- この仕組みを入れたネットワークでは、領域を4つまで積み重ねても精度が上がり続け、2層の逆伝播ネットワーク(0.89)に迫る0.86まで到達したと報告されている(深さが効くタスクでの結果)
仕組み2: 逆伝播を使わない学習
Free PhaseとNudged Phase
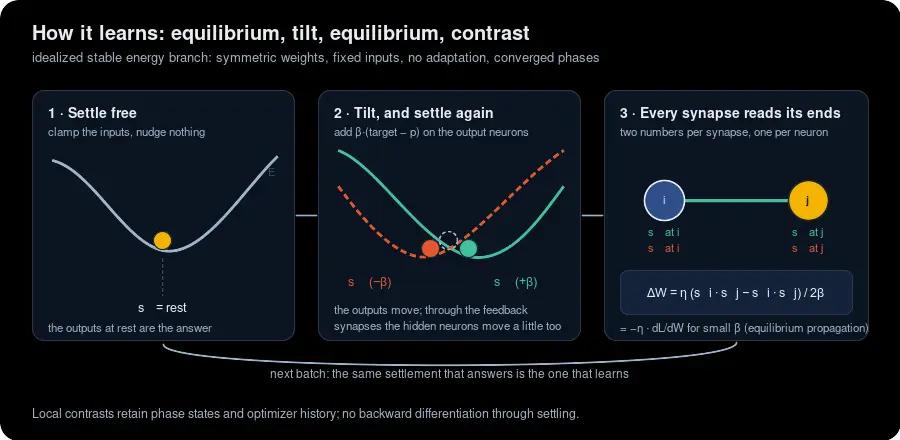
学習時は、同じネットワークに対して3回のsettleを行う。
- Free Phase: 入力だけを与えて平衡状態$s^0$に収束させる、これが素のままの答え
- Nudged Phase(正): 出力ニューロンに正解方向への弱い力$\beta \cdot (\mathrm{target} - s)$を加えて、もう一度平衡に収束させる($s^{+}$)
- Nudged Phase(負): 逆方向に同じ強さで力を加えて収束させる($s^{-}$)
更新式
各シナプス$e$は、2つのフェーズでの両端ニューロンの活性化の積の差分から、以下のように更新される。
$$ \Delta W_e = \eta \cdot \frac{s^{+}_{\mathrm{pre}} \cdot s^{+}_{\mathrm{post}} - s^{-}_{\mathrm{pre}} \cdot s^{-}_{\mathrm{post}}}{2\beta} $$- 重要なのは、この更新に使われているのが2回のsettleの結果だけで、誤差を逆向きに伝播させる計算が一切登場しない点
- 理論的には、平衡が滑らかで安定し、有効重みが対称に近く、$\beta \to 0$の極限を取ると、この差分は通常の勾配降下の勾配に収束することが示されている(Equilibrium Propagation、Scellier & Bengio, 2017)
- 有限の$\beta$では誤差が生じるため、Cadenceでは理論上の保証からどれだけ外れているかを明示的に計測・報告する仕組みを持っている
仕組み3: 報酬からの学習
- 教師ラベルの代わりに報酬だけで学習する場合は、Actor-Criticという別の仕組みが使われる
- 行動の実行に関与した全シナプスは、どれだけその行動に関与したかを示す適格度トレース(eligibility trace)を保持し続ける
- 報酬が得られると、Criticが予測していた価値との差分(TD誤差)が1つの数値として全シナプスに一斉配信され、ドパミンに見立てた信号として各シナプスのトレースを重み変化に変換する
適格度トレースと重みの更新式は以下のとおり。
$$ \mathrm{elig}_e \leftarrow \gamma \lambda \cdot \mathrm{elig}_e + \mathrm{contrast}_e $$$$ \delta = r + \gamma V(s') - V(s) $$$$ W_e \leftarrow W_e + \eta \cdot \delta \cdot \mathrm{elig}_e $$- 期待より良い結果になった行動は起こりやすく、悪い結果になった行動は起こりにくくするという発想で、誤差を逆伝播させる経路を必要としない
- 入力側の活性・出力側の活性・報酬信号の3つの積で重みが変わる「三要因則(three-factor rule)」という、神経科学由来の学習則に分類される仕組み
仕組み4: メモリ
Transformerのコンテキストウィンドウに相当する役割を、Cadenceでは複数の異なる仕組みに分けて持たせている。
| 仕組み | 役割 |
|---|---|
| Working Trace | 直前の解釈を次の瞬間に引き継ぐ短期記憶、RNNの隠れ状態に近い |
| Associative Store | 状況ごとの結果を記録する連想記憶、デルタ則による1回書き込みでsettleを介さず読み書きできる |
| Episodic Memory | 時間的な文脈つきで何がいつ起きたかを保持するオプションの記憶 |
| Recall Memory(学習済みコード+Recall Head) | 直近のモーメントをスロットとして保持し、Attentionに似た方法で呼び出すオプトインの仕組み |
- 既定ではTransformerのAttentionに相当する仕組みは使っておらず、連想記憶への読み書きで文脈を扱う
- オプションでRecall Memoryを有効化すると、Attentionに似た「学習済みの住所によるメモリ選択」が加わる、ただしこれはデフォルトの動作ではなくあくまで追加機能という位置づけ
Recall Head: Attentionに相当する部分
Cadenceの論文では、このRecall HeadをTransformerのAttention Headと項目ごとに対応づけて比較している。
| 観点 | Transformerの Attention Head | Cadenceの Recall Head |
|---|---|---|
| 保持するもの | 文脈内の全トークン、文脈が伸びるほど増え続けるキャッシュ | 直近C=64件のモーメントのみ、スロット数は固定 |
| Key | 各トークンの状態を学習済み行列で射影したもの | そのモーメントの学習済みコードと識別子を結合したもの、書き込み時に1回だけ決まる |
| Query | 現在の状態を学習済み行列で射影したもの | 現在の入力と直前の解釈(settleの結果)から作る |
| Value | 各トークンの状態を学習済み行列で射影したもの | そのモーメントの出来事と、その次に起きた出来事(successor) |
| 一致度の計算 | クエリとキーの内積をスケーリングしてsoftmax | クエリとキーの内積に、経過時間(age)の学習項を加えてsoftmax |
| 位置情報 | 距離ごとの学習済みバイアス項 | 経過モーメント数を対数的なバケツに分けた学習項、現在のモーメントから読み出す |
| 複数ヘッド | 出力を連結して1つの行列で射影 | 各ヘッドが自分の読み出し先を持ち、連想野がそれぞれをsettleの中で読む |
| 学習方法 | 訓練データ全体への逆伝播、学習後は固定 | 生きている間、局所的な規則で学習し続ける |
| 1ステップのコスト | 文脈が伸びるほど増加 | スロット数で固定 |
- 最大の違いは「値(Value)」の持たせ方で、Transformerは各トークンの状態そのものを読むのに対し、Cadenceは「出来事」と「その次に起きた出来事」をセットで持たせている
- これにより、Transformerなら2層必要な「Induction Head」(一度見たパターンの続きを予測する仕組み)を、Cadenceは1回の読み出しだけで再現できる。たとえば過去に"A"の次に"B"が来たことを記憶していれば、次に"A"が現れたとき、そのスロットのsuccessor(=“B”)をそのまま読み出せる
書き込みから読み出しまでの関係を図にすると以下のようになる。
flowchart LR
    subgraph M1["モーメント t-5: Aを観測"]
        S1["スロット書き込み<br>key=A, event=A"]
    end
    subgraph M2["モーメント t-4: Bを観測"]
        S2["1つ前のスロットの<br>successorにBを記録"]
    end
    subgraph M3["現在: 再びAを観測"]
        Q["クエリ生成"] --> Match["キーAと一致"]
        Match --> Read["successor Bを読み出し"]
    end
    S1 --> S2
S2 -. age経過後に一致 .-> Match- 経過時間の学習項(Position Term)は、T5のような相対位置表現と同様に、近い過去は1モーメント単位、遠い過去は対数的に粗いバケツで扱う
- 公式の評価では、このInduction Headに相当する読み出しは学習時の3〜5倍の長さまで精度1.00を維持しており、エピソード記憶を加えることである種のタスクの成功率が38%から99%まで上がった例も報告されている
System 1とSystem 2
- System 1(既定): 感覚野・連想野・運動野が1つの平衡に収束する基本構成、平常時は1回の貪欲なsettleで答えを返すだけで学習しない
- 誕生直後(最初の100モーメント)や、驚き・欲求による覚醒(arousal)が起きたときだけ学習する
- System 2(オプション): 同じ平衡の中に観測領域(observer)を追加し、ベースの状態を読み取って同じ平衡に影響を返す構成、自己観察・内省に相当する機構
- 慣れた状況は安く答え、驚きがあったときだけ高コストな再平衡・学習を行うという使い分けを「Routineは平衡」という設計思想として掲げている
現状の立ち位置
- GPL-3.0のオープンソースで、
pip install cadence-netで導入できるPython(NumPy)ライブラリ、現状はalpha版の研究用ソフトウェアという位置づけ - ロボットアーム・マルチエージェント・Atari・Castlevania等のデモで動作している
- 評価論文では、25,609個のニューロンからなる実在の神経回路(コネクトーム)を取り込み、唯一の平衡点を持つことの厳密な証明つきで動かした例も報告されている
- 一方で論文自身が「Cadenceの読み出しはTransformerのAttentionと等価ではない」「既存の学習手法に対する全般的な優位性は主張しない」と明記しており、誇張のない形で結果を提示している
- 公式ドキュメントも、統合された学習済み世界モデル・一貫した自然文の生成・学習された関連性選択などは未実証の目標であると明記している
- Mamba・RWKVのようなAttentionを使わずTransformerの延長線上にある系統とは異なり、バックプロパゲーションそのものからの脱却を狙う、かなり尖った立ち位置の研究
まとめ
Cadenceは、ニューロン群を平衡状態に収束させるSettlingという動作だけで推論と学習の両方を表現するアーキテクチャで、学習は2回の平衡状態の差分だけで重みを更新するEquilibrium Propagationという理論的裏付けを持った仕組みに基づいている。報酬からの学習は適格度トレースとドパミン的な一斉配信信号による三要因則、長期的な文脈は連想記憶・エピソード記憶という明示的なメモリ機構が担っており、いずれもTransformerの逆伝播・Attention・KVキャッシュとは異なる設計で同じ役割を果たそうとしている。まだ研究段階のソフトウェアだが、逆伝播を使わずに継続的に経験から学ぶ脳という目標に向けた、理論的に筋の通ったアプローチだと感じた。
論文「Settling Brains with Attention: Deep Neural Networks That Learn During Life」(Bernhard Mueller, Pragma Research, 2026)を直接読み込み、Recall Headの数式やApical Compartmentの仕組みはここから整理した。
Sources: