目次
背景
- Active Speaker Detection(ASD)は、映像に映っている複数の顔の中から、今音声を発している人物を特定するタスク
- 話者ダイアライゼーション・自動字幕生成・ビデオ会議でのフォーカシングなど、音声と映像を結びつける用途の土台になる
- 気になっているLight-ASD・LR-ASD・TS-TalkNetの3つを、それぞれの設計の狙いを比較しながら整理する
土台になっているTalkNet
- ここで扱う3つのモデルは、いずれもTalkNet(Tao et al., 2021)の構成をベースにしている
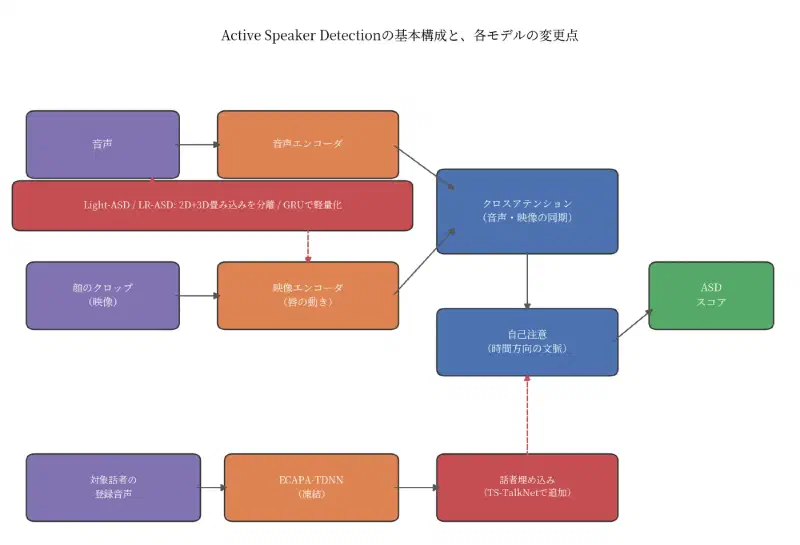
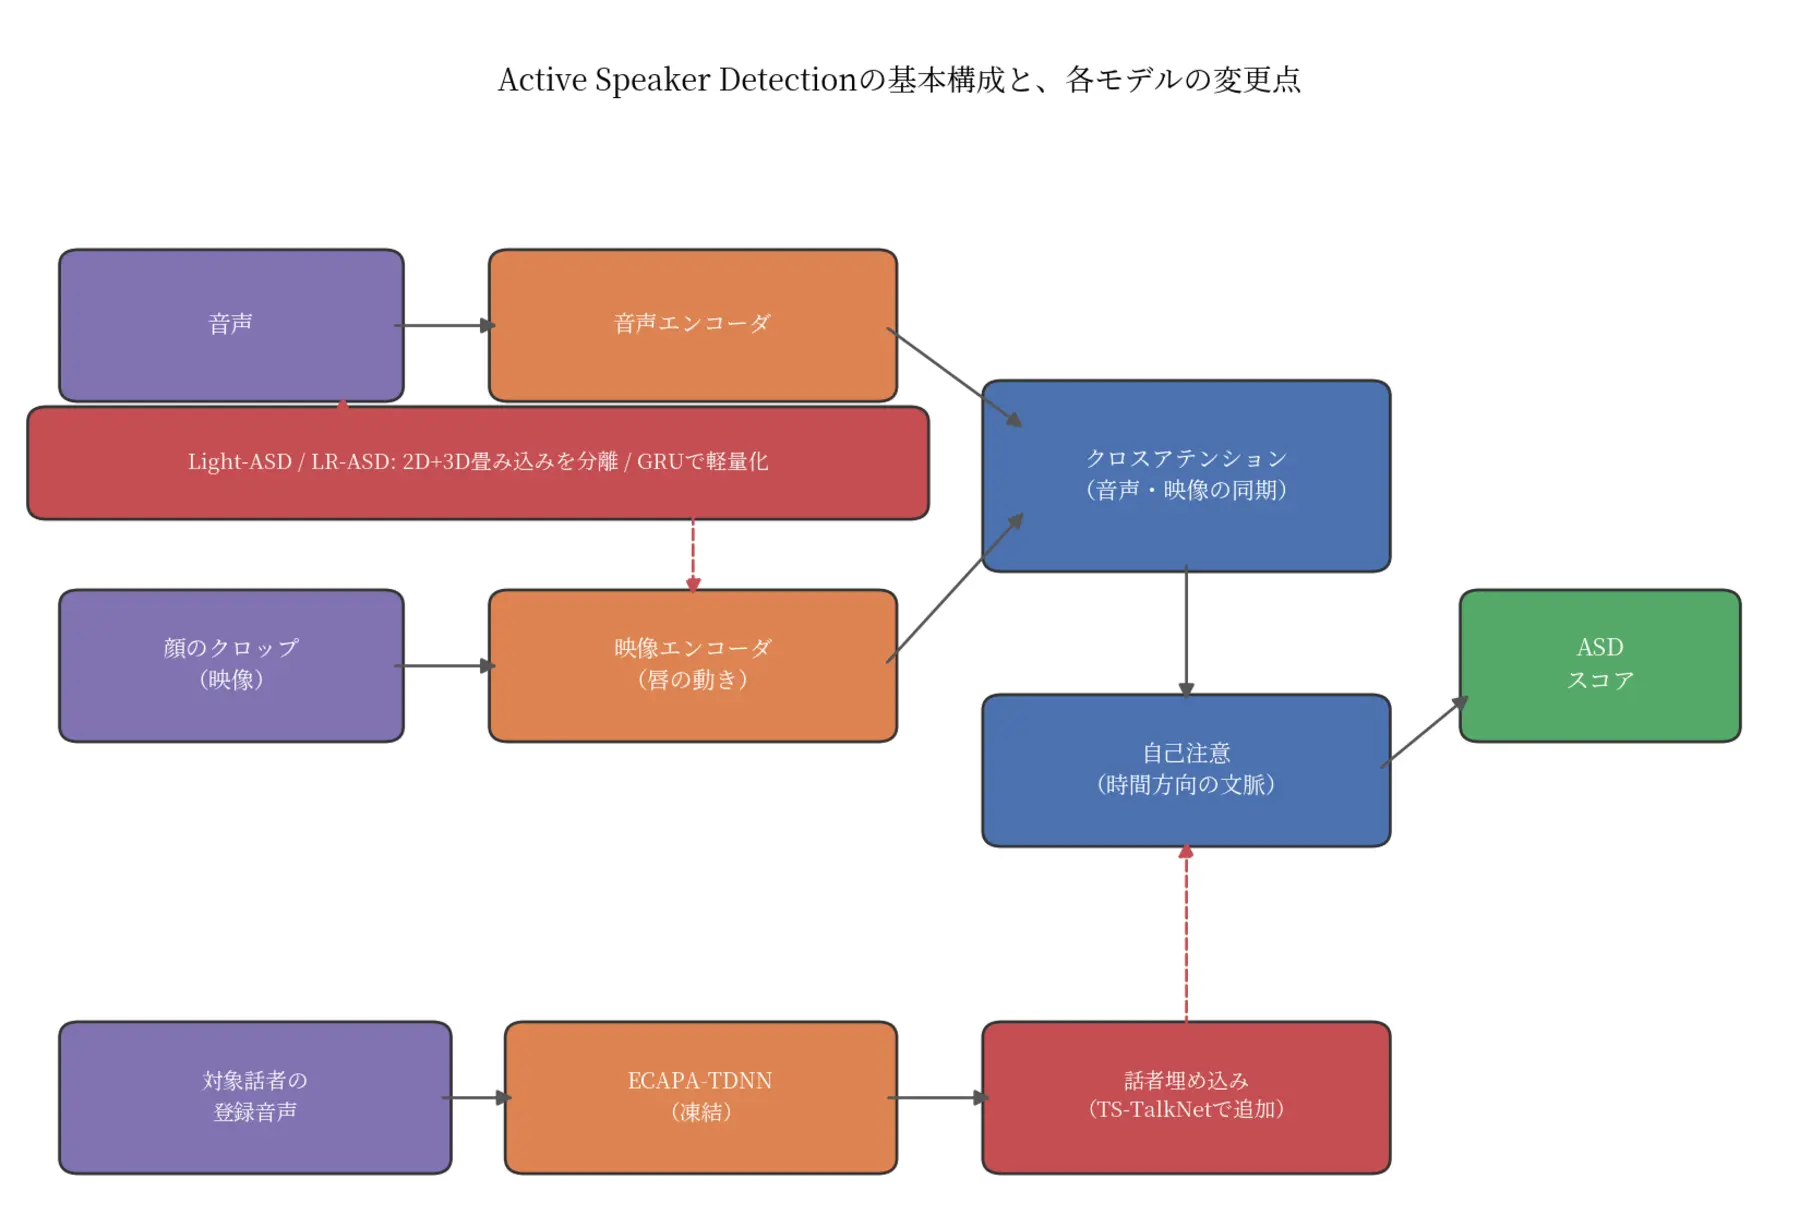
- 音声エンコーダと映像(唇の動き)エンコーダをそれぞれ時系列で処理し、クロスアテンションで音声と映像の同期を取り、自己注意で時間方向の文脈を統合する構成
- 「声と唇の動きが同期しているかどうか」を主な手がかりに、その人物が話しているかどうかを判定する
Light-ASD: 軽量化へのアプローチ
- Liao et al. (2023, CVPR)の"A Light Weight Model for Active Speaker Detection"が提案したモデル
- 既存手法はメモリ・計算量の要求が大きく、リソースの限られた環境への展開が難しいという問題意識から出発している
- 設計上の工夫は主に3つ
- 入力候補数を減らす
- 音声・映像特徴抽出で2D畳み込みと3D畳み込みを分離する
- クロスモーダルなモデリングに、計算量の小さいGRU(Gated Recurrent Unit)を使う
- 全体は特徴表現を作るフロントエンドと、話者検出を行うバックエンドという構成
- AVA-ActiveSpeakerベンチマークで94.1% mAPを達成し、当時の最良手法(94.2% mAP)とほぼ同等の精度を、パラメータ数1.0M(最良手法の22.5Mの約1/23)、0.6G FLOPs(2.6Gの約1/4)という大幅に小さい計算量で実現している
- Columbiaデータセットでも精度が落ちず、軽量化してもタスク間の汎化性が保たれることを確認している
LR-ASD: Light-ASDの拡張版
- Light-ASDの著者ら(Liao, Duanほか)による、2025年のIJCV(International Journal of Computer Vision)掲載の拡張版
- Light-ASDと同じ「軽量なフロントエンド+バックエンド」という設計思想を引き継ぎながら、精度や頑健性を改善した後継モデルという位置づけ
- コード・事前学習済み重みはGitHubのJunhua-Liao/LR-ASDで公開されている
TS-TalkNet: 「誰かが話しているか」ではなく「その人が話しているか」
- Jiang et al. (2023, INTERSPEECH)の"Target Active Speaker Detection with Audio-visual Cues"が提案したモデル
- 通常のASDは「画面内の誰かが話しているか」を判定するタスクだが、target-speaker ASD(TS-ASD)は、あらかじめ登録しておいた特定の人物が話しているかどうかを判定したい場合に対応する
- TalkNetをベースに、事前に登録した対象話者の音声から抽出した話者埋め込み(凍結したECAPA-TDNNで生成)を、音声・映像の同期の手がかりに加えて追加の手がかりとして使う
- 話者埋め込みと音声・映像の同期の手がかりは、クロスアテンションとフュージョンのモジュールで統合され、最終的に自己注意でASDスコアが予測される
- 対象話者の参照音声が得られない場合は、通常のTalkNetと同じ音声・映像同期の手がかりだけにフォールバックする
- AVA-ActiveSpeakerで93.9% mAP(TalkNet比+1.6pt)を達成し、話者照合用のASWテストセットでもAP・AUC・EERのいずれでも改善している
3つのモデルの位置づけを整理する
- Light-ASDとLR-ASDは「同じ精度をどれだけ小さいモデルで出せるか」という軽量化の軸の改良
- TS-TalkNetは「画面内の誰かではなく、特定の人物を追えるか」という、判定対象の絞り込みの軸の改良
- この2つの軸は独立しているので、原理的には軽量なtarget-speaker ASDのように組み合わせる余地もある
まとめ
Light-ASD・LR-ASD・TS-TalkNetは、いずれもTalkNetの「音声と映像の同期を手がかりにする」という基本設計を引き継ぎながら、異なる方向に改良したモデル。Light-ASDは入力候補の削減・2D/3D畳み込みの分離・GRUによる軽量なクロスモーダルモデリングで、ほぼ同等の精度をおよそ1/23のパラメータ数で実現し、その拡張版であるLR-ASDがさらに精度・頑健性を改善している。一方TS-TalkNetは、事前登録した話者埋め込みを追加の手がかりとして組み込むことで、画面内の誰かではなく特定の人物の発話を検出できるようにした。軽量化と判定対象の絞り込みは互いに独立した改良の軸であり、両方を組み合わせる余地が残っている。
参考文献
- Liao, J. et al. (2023). “A Light Weight Model for Active Speaker Detection” (CVPR)
- Liao, J., Duan, H. et al. (2025). LR-ASD (IJCV, Light-ASDの拡張版)
- Jiang, Y. et al. (2023). “Target Active Speaker Detection with Audio-visual Cues” (INTERSPEECH)
- Tao, R. et al. (2021). “Is Someone Speaking? Exploring Long-term Temporal Features for Audio-visual Active Speaker Detection” (TalkNet)