目次
背景
- 音声処理まわりの記事を書く機会が増えてきた
- その土台となる「音そのもの」の基礎を、ここで一度整理したメモ
音とは何か
音の正体(空気の振動)
- 音源が振動すると、その振動が空気の疎密波(縦波)として周囲に伝わっていく現象が音
- 音源から出た振動が、空気の分子を押したり引いたりしながら伝播していく
- 空気のような媒質が必要なので、真空中では音は伝わらない
波の基本要素
- 振幅(Amplitude): 波の大きさ。音の大きさ(音量)に対応する
- 周波数(Frequency): 1秒間に振動する回数。単位はHz(ヘルツ)。音の高さ(ピッチ)に対応する
- 波長(Wavelength): 1周期分の波の長さ。周波数と音速から決まる
- $\lambda$が波長、$v$が音速、$f$が周波数
- 位相(Phase): 波が今どの位置(山・谷のどこ)にいるかを表す
可聴域
- 人間が聞き取れる周波数は、おおよそ20Hz〜20,000Hz(20kHz)程度
- 年齢とともに、高音域が聞き取りにくくなっていく
- 会話音声の情報は、主に100Hz〜8kHzあたりに集中している
アナログからデジタルへ
サンプリング(標本化)
- 連続的なアナログ波形を、一定間隔で区切って数値の列に変換する処理
- サンプリング周波数(サンプルレート): 1秒間に何回サンプリングするか。8kHz・16kHz・44.1kHz(CD音質)・48kHzなどがよく使われる
- サンプリング定理(ナイキストの定理): 元の波形を正しく復元するには、含まれる最大周波数の2倍以上のサンプリング周波数が必要
- 例えば、20kHzまでの音を正しく扱うには、44.1kHz以上のサンプリングが必要(CD音質が44.1kHzなのはこれが理由)
- サンプリング周波数の半分の周波数をナイキスト周波数と呼び、それを超える周波数成分は正しく記録できない(エイリアシングという歪みの原因になる)
量子化
- サンプリングした各点の振幅を、有限のビット数の数値に変換する処理
- ビット深度: 16bit($-32768$〜$32767$)・24bit・32bit floatなどがよく使われる
- ビット深度が大きいほど、表現できる音量の分解能が高くなり、量子化誤差(量子化ノイズ)が小さくなる
PCM
- サンプリングと量子化だけで作られた、圧縮のない生のデジタル音声データ
- WAVファイルなどの基本フォーマットになっている
ADCとDAC
- ADC(Analog-to-Digital Converter、A/Dコンバータ): 前述のサンプリング・量子化を、実際にハードウェアとして行う部品
- マイクが拾った連続的な電気信号(アナログ)を、一定間隔で区切って数値化し、PCMのようなデジタルデータに変換する
- DAC(Digital-to-Analog Converter、D/Aコンバータ): ADCの逆で、デジタルデータ(PCMのサンプル列)を、連続的な電気信号(アナログ)に戻す部品
- この電気信号がスピーカーやヘッドホンを物理的に振動させ、実際の音になる
- 録音の流れ: マイク(音→電気信号)→ ADC(電気信号→デジタルデータ)→ PCMなどとして保存・処理
- 再生の流れ: PCMなどのデジタルデータ → DAC(デジタルデータ→電気信号)→ アンプ・スピーカー(電気信号→音)
- 後述のリングバッファは、ちょうどこのADC/DACと、CPU上で動くソフトウェアとの間をつなぐ役割を果たしている
- サウンドカードやオーディオインターフェースの性能でよく話題になる「ビット深度」「サンプリング周波数」「S/N比」なども、実質的にはこのADC/DACの変換精度に関する話
音の大きさを表す指標
RMSエネルギーとは
- 波形のエネルギー(音量)を表す、最も基本的な指標の1つ
- 一定区間の波形のサンプル値を2乗して平均し、平方根を取ったもの
- $x_i$がその区間の$i$番目のサンプル値、$N$がサンプル数
- 音量が大きいほど値も大きくなる、直感的にわかりやすい指標
- 後述のdBは、このRMS(やパワー、振幅)を対数スケールに変換したもの。「RMSを計算してから、dBに変換する」という流れになることが多い
デシベル(dB)とは
- 音の大きさ(パワーや振幅の比)を対数スケールで表す単位
- パワー比の場合、以下の式で表される
- $P$が測定対象のパワー、$P_{\text{ref}}$が基準となるパワー
- 人間の聴覚は、音の大きさを線形ではなく対数的に感じる(音のパワーが10倍になっても、感覚的には「少し大きくなった」程度にしか感じない)ため、dBのような対数スケールの方が感覚に合いやすい
dBFS(dB Full Scale)とは
- デジタル音声で使われる、基準の取り方が特殊なdB
- 基準$P_{\text{ref}}$を「そのビット深度で表現できる最大振幅(クリッピング直前の値)」に取る
- そのため、0dBFSが表現できる最大値で、実際の音声データはほぼ常にそれより小さい負の値(例: -20dBFS、-40dBFS)になる
- アナログの音圧レベル(dB SPL)のような絶対的な物理量ではなく、「そのデジタルシステムの上限からどれだけ離れているか」という相対値である点に注意
SNR(Signal-to-Noise Ratio)とは
- 欲しい信号(音声など)の強さと、それ以外のノイズの強さの比率
- 通常dBで表す
- 値が大きいほど、信号がノイズに対してクリアに聞こえる(SNRが高い=綺麗な音)
- 値が小さい、あるいはマイナスだと、ノイズに埋もれて聞き取りにくくなる
- 音声認識やVADの文脈では、マイクに近い目的話者ほど音量が大きくSNRが高くなりやすく、遠くの背景話者ほど音量が小さくSNRが低くなりやすい、という前提で距離のフィルタ代わりに使われることがある
ノイズとノイズフロア
ノイズとは
- 欲しい信号(音声など)に対して、不要に混ざり込む音や信号成分
- 種類の例
- 環境音: 暗騒音(部屋や屋外の背景の音)、空調音、風切り音など
- 電気的なノイズ: マイクやアンプなど、回路自体が生み出す熱雑音(サーマルノイズ)など
- 量子化ノイズ: 量子化の際に生じる誤差(後述)
- ホワイトノイズ: 全ての周波数帯域に渡って、均等なパワーを持つノイズ
- ピンクノイズ: 周波数が高くなるほどパワーが下がる(1/fの性質を持つ)ノイズ。自然界の音に近いとされる
ノイズフロアとは
- マイクや録音機材、伝送路などの系が常に持っている、最低限のノイズレベル
- 「フロア(床)」という名前の通り、それより下には信号を検出できない下限のライン、というイメージ
- ノイズフロアより小さい信号は、ノイズに埋もれてしまい、検出も区別もできなくなる
- 前述のSNRは、言い換えると「信号のレベルと、このノイズフロアとの差(比)」を表している指標
量子化ノイズフロア
- ビット深度によって生じる、量子化そのものに起因するノイズフロア
- ビット深度を$b$(ビット数)としたとき、理論上のダイナミックレンジ(表現できる最大音量と、量子化ノイズフロアとの比)は、以下の式でおおよそ求まる
- 例えば16bitなら、理論上のダイナミックレンジは約98dB
- ビット深度を上げるほど、量子化ノイズフロアが下がり、より小さい信号まで正しく表現できるようになる
ノイズ抑制・音声強調(Speech Enhancement)
- 録音した音声からノイズを取り除き、目的の音声だけをクリアにする技術
- 古典的な手法として、スペクトル減算(背景のノイズだけの区間からノイズのスペクトルを推定し、音声全体のスペクトルからそれを差し引く)などがある
- 近年はディープラーニングを使い、ノイズを含む音声からクリーンな音声への変換を直接学習する手法が主流になっている
- 前述のVAD(音声区間検出)や、複数の話者の声を分離する音源分離とも関連が深い技術領域
音声ファイルフォーマット
- 非圧縮: WAVなど。PCMのデータをそのままファイルに入れたもの
- 可逆圧縮: FLACなど。ファイルサイズは小さくなるが、展開すれば元のデータと完全に一致する
- 非可逆圧縮: MP3・AACなど。人間の聴覚特性を利用して、聞こえにくい成分を削ることで大きく圧縮する。一度削った情報は元に戻せない
周波数領域で見る
時間領域と周波数領域
- 波形をそのまま表示したもの(時間領域の表現)では、どんな高さの音がどれくらい混ざっているかが分かりにくい
- フーリエ変換を使うと、波形を「どの周波数の成分がどれだけ含まれているか」という周波数領域の表現に変換できる
FFT(高速フーリエ変換)
- 離散フーリエ変換(DFT)を高速に計算するアルゴリズム
- 音声処理では、一定区間(フレーム)ごとの周波数成分を計算するのに使われる
STFTとスペクトログラム
- 音声は時間とともに周波数成分が変化していくので、全体を一度にFFTするのではなく、短い時間窓(フレーム)に区切って、それぞれにFFTをかける
- この手法をSTFT(短時間フーリエ変換)と呼ぶ
- STFTの結果を、時間×周波数×パワーの2次元画像として可視化したものがスペクトログラム
- フレームを切り出す際は、端で波形が不連続にならないよう、窓関数(Hann窓など)をかけてから変換するのが一般的
フレームサイズとホップサイズ
- STFTでは、波形を切り出すフレームの長さ(フレームサイズ、窓長)と、次のフレームへどれだけずらすか(ホップサイズ、シフト幅)を決める必要がある
- フレームサイズが短いほど、いつ変化が起きたかを細かく捉えられる(時間分解能が高い)が、その分、周波数の細かい違いを見分けにくくなる(周波数分解能が低い)
- 逆にフレームサイズを長くすると、周波数分解能は上がるが、時間分解能が下がる
- この2つはトレードオフの関係にあり、両方を同時に高めることはできない
- 音声処理では、20〜30ms程度のフレームサイズが、声の性質が変化する速さとよく合うため、よく使われる
- ホップサイズは、フレームサイズの半分程度(50%オーバーラップ)にすることが多く、フレーム同士を重ねることで変化を滑らかに追えるようにする
具体的な計算例
例えば、サンプルレート16,000 Hz・フレーム長20 ms・サンプル幅16bit(2byte)という、音声処理でよく使われる設定を考える。
- 1フレームに含まれるサンプル数: $16000 \times 0.020 = 320$サンプル
- 1フレームのバイト数: $320 \times 2 = 640$byte(
FRAME_BYTES = 640 byte)
つまり、この設定では20msごとに640byteのデータを1フレームとして処理することになる。
位相の扱い
- STFTの結果は、各周波数成分について振幅(大きさ)と位相(波のタイミングのずれ)の両方の情報を持っている
- しかし、スペクトログラムやlog-melスペクトログラム、MFCCなど、多くの音声処理の入力表現では、振幅(パワー)の情報だけを使い、位相の情報は捨てることが多い
- 理由の一つは、人間の聴覚が位相のズレには比較的鈍感で、主に振幅(周波数ごとのエネルギー分布)で音を知覚しているとされるため
- ただし、音声を波形に「戻す」処理(音声合成、ボコーダーなど)では位相情報が必要になる。振幅だけから位相を推定し直すGriffin-Limアルゴリズムのような手法もある
メル尺度(Mel scale)とは
- 人間の聴覚は、低い周波数の変化には敏感だが、高い周波数になるほど変化を感じにくくなる
- この人間の知覚特性に合わせて周波数を変換した尺度がメル尺度で、以下のような式で変換する
- $f$が実際の周波数(Hz)、$m$がメル尺度上の値
- 低周波数では実周波数とほぼ線形の関係になり、高周波数になるほど圧縮されていく
- 700と2595という定数は、理論から導かれたものではなく、「1000Hzの音=1000mel」という基準点を通るように、心理音響実験のデータへ対数カーブをフィットさせた近似式のパラメータ
log-melスペクトログラムとは
- 音声をSTFTでスペクトログラムにした後、周波数軸をメル尺度に沿ったフィルタバンク(メルフィルタバンク、通常20〜80程度)でまとめ、さらにdB(対数)に変換したもの
- 音声認識・話者認識・音声合成など、ディープラーニングを使う音声モデルで、生波形の次によく使われる入力表現
MFCC(Mel-Frequency Cepstral Coefficients)とは
- log-melスペクトログラムに、さらにDCT(離散コサイン変換)をかけて得られる係数
- DCTによって、隣り合うメルバンド同士の相関(情報の重複)を取り除き、少ない次元(通常12〜13次元程度)に情報を圧縮できる
- 音声認識・話者認識で長年使われてきた定番の特徴量
- 近年はディープラーニングの発展により、DCTで圧縮する前のlog-melスペクトログラムをそのまま入力に使うケースも増えている
- 次元圧縮の仕方を人間が設計するより、ニューラルネットワーク自身に学習させた方が精度が良いことが多いため
モノラルとステレオ
- チャンネル数: 1本のマイクで録音したものがモノラル、2本(左右)で録音したものがステレオ
- 音声認識・VADなどの処理では、扱いを単純にするため、まずモノラルに変換してから処理することが多い
リアルタイム音声処理とバッファ
なぜバッファが必要か
- オーディオのハードウェア(前述のDAC・ADC)は、決まった一定のクロックで動いていて、待ってくれない
- 例えば48kHzなら、1秒間に48000回、絶対に休まず一定間隔でサンプルを出し入れし続ける
- 一方、ソフトウェア(アプリ、OS)はCPUのスケジューリングで断続的にしか動けない
- 他のプロセスに割り込まれたり、処理に時間がかかったりする
- この「常に一定で待たないハードウェア」と「断続的にしか動けないソフトウェア」のギャップを埋める緩衝材が、バッファ
リングバッファの仕組み
- バッファの実態は、「リングバッファ(円環状の配列)」というデータ構造になっていることが多い
- 一定サイズのメモリ領域に、「書き込み位置(write pointer)」と「読み込み位置(read pointer)」という2つのポインタを置き、端まで行ったら先頭に戻る
再生(出力)の場合は、以下のような流れになる。
- アプリが計算した音のサンプルを、バッファの書き込み位置に順番に詰めていく
- ハードウェアのクロックが「次のサンプルをくれ」というタイミングで、バッファの読み込み位置からサンプルを取り出し、スピーカーへ物理的に出力する
- 読み込み位置が書き込み位置に追いついてしまう(アプリがまだ次のデータを用意できていないのに、ハードウェアがデータを要求してくる)と、渡せるデータがなくなる。これが後述のunderrun
- そのため、書き込み位置は読み込み位置より少し「先」を進めておく必要があり、この先行分がそのまま遅延(レイテンシ)になる
録音(入力)の場合は、この逆になる。
- ハードウェア(マイク)が一定クロックでサンプルを取り込み、バッファの書き込み位置に詰めていく
- アプリが定期的に読み込み位置からデータを取り出して処理する
- アプリの処理が遅れて、書き込み位置(ハードウェア)が読み込み位置(アプリ)に追いついてしまうと、まだ読んでいない古いデータが上書きされて消える。これが後述のoverrun
Linuxの音声システム
PulseAudio
- Linuxで長く標準的に使われてきたサウンドサーバー
- ALSA(カーネルレベルのオーディオドライバ)とアプリケーションの間に入り、複数アプリの音をミキシングしたり、アプリごとの音量調整、ネットワーク越しの音声出力などの機能を提供する
- 「どのアプリの音を、どのスピーカー/マイクに出し入れするか」をOSレベルでルーティングする役割を持つ
PipeWire
- PulseAudio(コンシューマ向け)とJACK(プロ向けの低遅延オーディオ)の両方を置き換えることを目指した、より新しいサウンドサーバー
- Fedora、Ubuntu(22.10以降)など主要ディストリビューションで標準になりつつある
- PulseAudio互換レイヤーを持っているため、既存のアプリはそのまま動くことが多い
- 低遅延が求められる音楽制作や、後述のリアルタイム処理の要件にも対応できるよう設計されている
xrun(アンダーラン・オーバーラン)
- 前述のリングバッファで、読み込み位置と書き込み位置の関係が崩れ、音が途切れたり、プチプチというノイズが乗ったりする現象
- underrun: 再生時、読み込み位置が書き込み位置に追いついてしまい、渡せるデータがなくなる状態
- overrun: 録音時、書き込み位置が読み込み位置に追いついてしまい、未読のデータが上書きされて失われる状態
- CPU負荷が高い、バッファサイズが小さすぎる、スレッドの優先度設定が適切でない、などが主な原因
クオンタム(Quantum)
- PipeWireやJACKで、1回の処理サイクルで扱うサンプル数(バッファサイズ)のこと
- クオンタムが小さいほど遅延(レイテンシ)は小さくなるが、その分処理が間に合わなくなりやすく、前述のxrunが起きやすくなる
- 逆にクオンタムを大きくすると、遅延は増える代わりに安定して処理できる
- レイテンシは、おおよそ以下の関係になる
声の音響的な仕組み
周期波・基音・倍音
- 声のような周期的な音(周期波)は、単一の周波数の波ではなく、複数の周波数成分が重なり合ってできている
- そのうち、最も低い周波数の成分を基音(fundamental tone)と呼ぶ
- 基音の整数倍の周波数を持つ成分を倍音(harmonic/overtone)と呼ぶ
- $f_0$が基音の周波数、$f_n$が$n$番目の成分の周波数
- $n=1$が基音そのもの、$n \geq 2$の成分を倍音と呼ぶ
- 用語の注意点: 英語の"harmonic"には基音自体を含めて数える流儀(1st harmonic=基音そのもの)もあるが、日本語の「倍音」は基音を含めず、その上に乗る成分だけを指すことが多い。この記事では後者に合わせ、基音と倍音を別のものとして扱う
例えば、基音が200Hzの場合、以下のようになる。
- 基音: 200Hz
- 倍音: 400Hz、600Hz、800Hz…
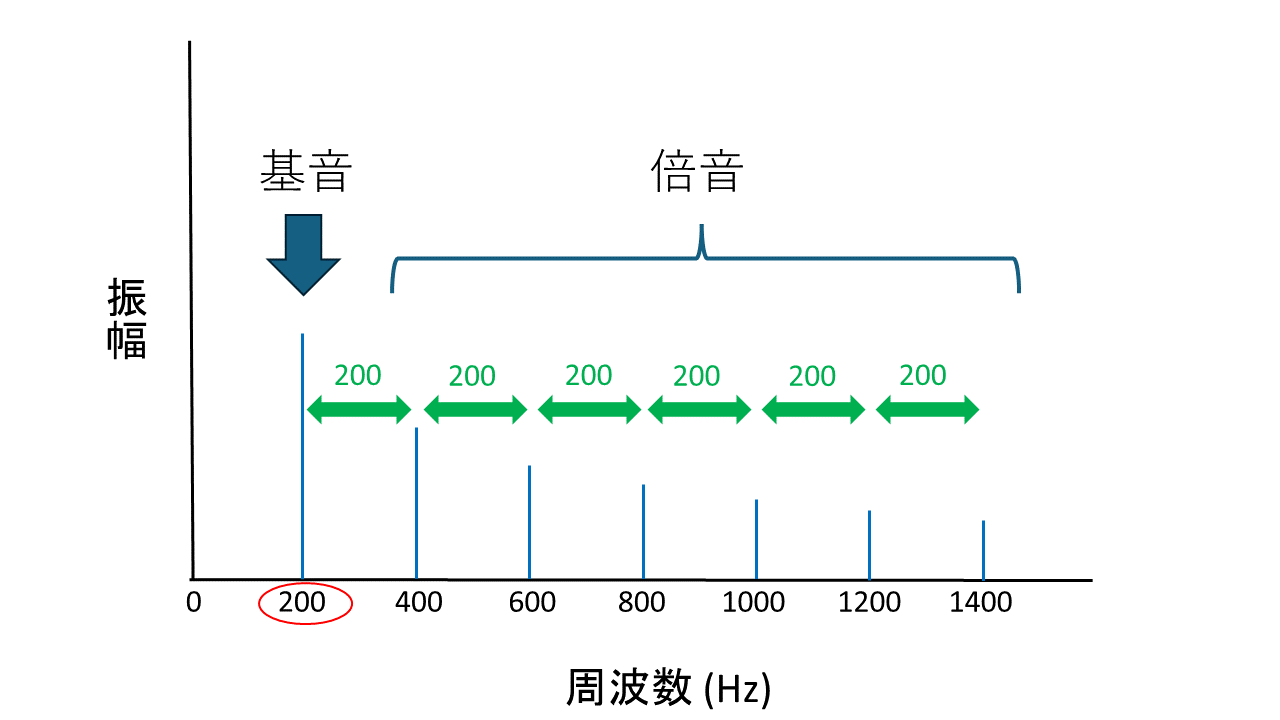
倍音は必ず基音の整数倍になるので、隣り合う成分同士の周波数の間隔は、常に基音の周波数と等しくなる。
| |
基本周波数(F0)
- 声帯が1秒間に振動する回数が、そのまま基音の周波数=基本周波数(F0)になる
- 例えば、声帯が1秒間に100回振動していれば、F0は100Hz
- F0が高いほど「高い声」、低いほど「低い声」に感じる
- 実際の声には、F0(基音)だけでなく、その整数倍の倍音も同時に含まれている(前述の周期波の構造そのもの)
- F0は、声の「音程・ピッチ」に強く関係する要素
有声音・無声音
- 声帯を振動させて出す音を有声音(voiced sound)、声帯を振動させずに出す音を無声音(unvoiced sound)と呼ぶ
- 母音(あ・い・う・え・お等)は基本的に有声音で、周期的な波形になり、F0(基本周波数)を持つ
- 子音には、有声のもの(例: 日本語の「が」「だ」「ば」行など)と、無声のもの(例: 日本語の「さ」「た」行や「か」行の一部など)がある
- 無声音では声帯が振動しないため、口や喉の狭めを通る空気の乱流に近い、ノイズのような波形になる。周期性がなく、F0を持たない
- この違いは、前述のZCR(無声音でZCRが高くなりやすい)や、F0が検出できるかどうかを使って、機械的に判定できる
共鳴と声道
- 共鳴(きょうめい): 同じ振動数を持つ別の物体がその影響を受けて一緒に揺れ動き、音が大きくなる現象。物体固有の振動数(固有振動数)で発生する
- 声道(せいどう): 声帯から口唇(くちびる)や鼻孔に至るまでの空気の通り道(空洞部分)
- 共鳴は、この声道の形状によってもたらされる。例えば「ア」と「イ」では、声道の形状が大きく異なる
- 「ア」を高い声・低い声で出し分けるのは、声道の形(共鳴のしかた)はそのままに、音源(声帯振動=F0)の周波数だけを変えているということ
フォルマント
- 基音・倍音を含む声の周波数成分のうち、声道の共鳴によって特に強められた周波数帯を、フォルマント(formant)と呼ぶ
- フォルマントは、低い方から順に第一フォルマント(F1)、第二フォルマント(F2)…と呼ばれる
- 母音は声道の形(=共鳴のしかた)によって特徴づけられるため、フォルマントは声の「母音・声質」を強く反映する
- F0が「音程・ピッチ」に対応するのに対し、フォルマント(F1、F2…)は「どの母音か・どんな声質か」に対応する
- 音響分析では特にF1とF2の2つに注目することが多く、多くの言語で母音の音響的特徴はこの2変数でおおよそ捉えられる
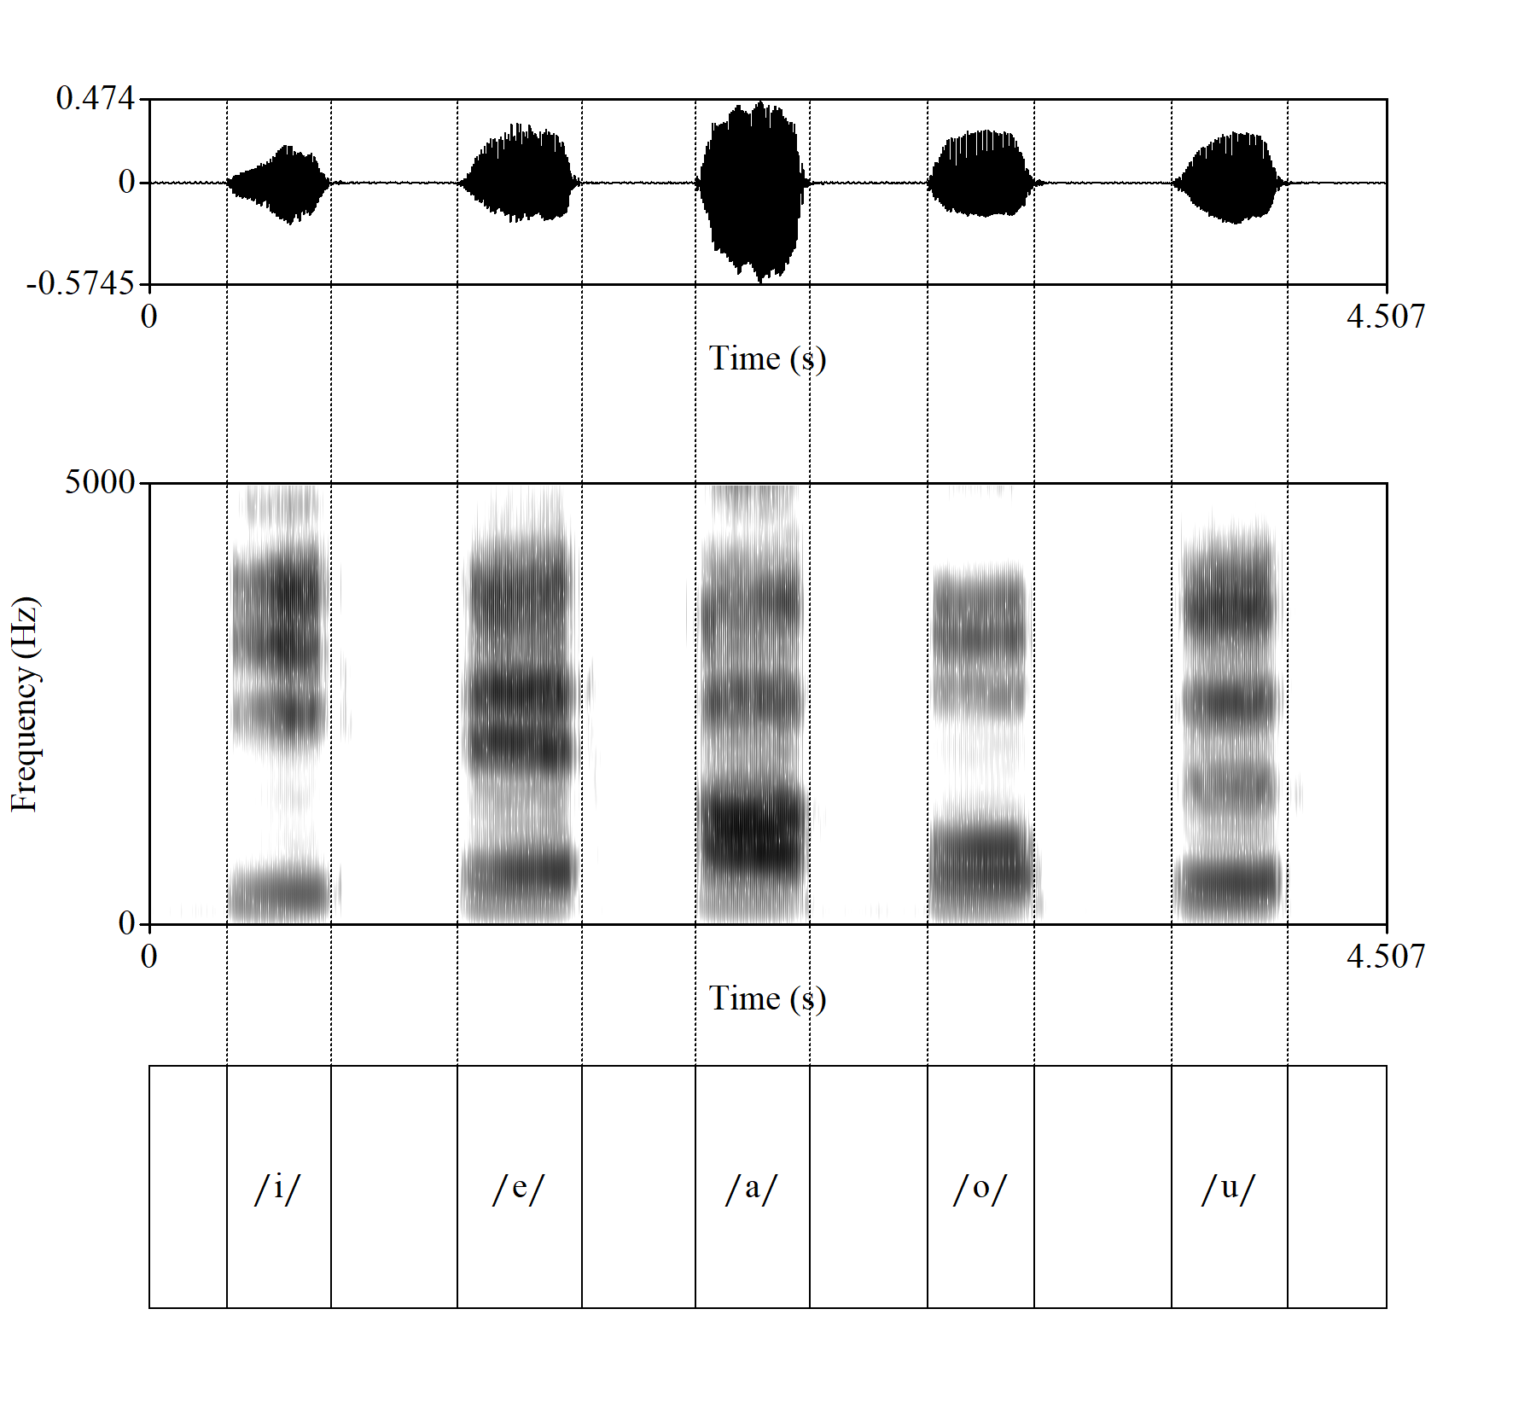
- 横長の黒い帯のように見えるのが、フォルマント。母音によって異なる周波数に現れる
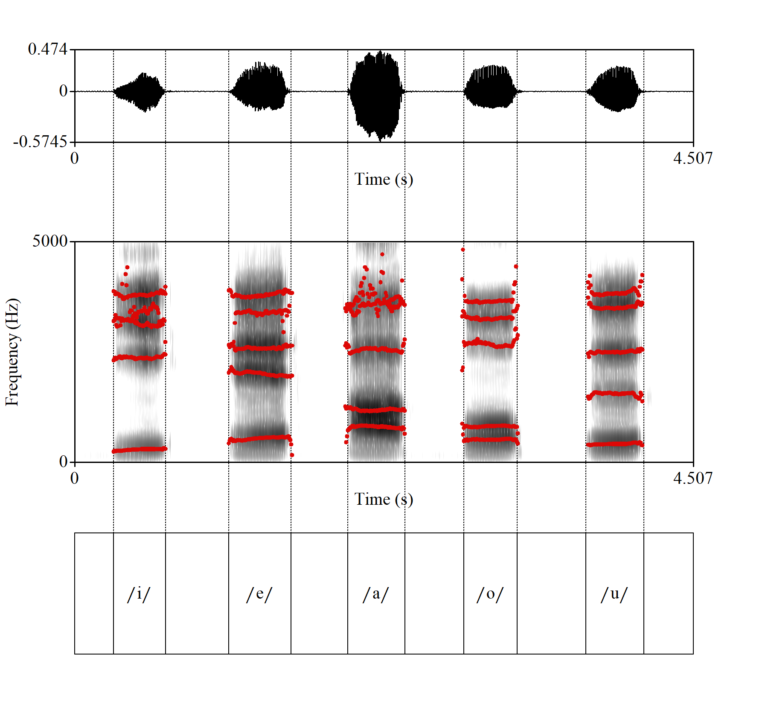
- Praatでフォルマントのピークを自動検出し、赤いドットでプロットしたもの
- 各母音において、一番下の赤線が第一フォルマント(F1)、下から2番目の赤線が第二フォルマント(F2)
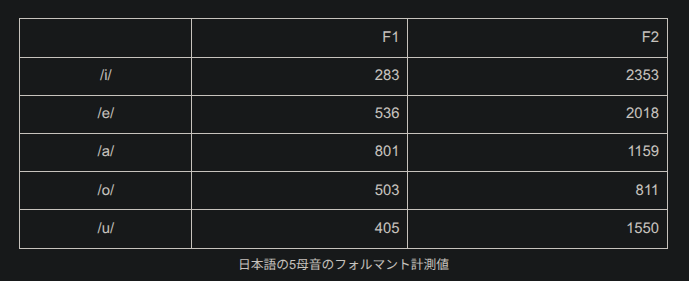
- 各母音の時間軸上の中央における第一フォルマント(F1)と第二フォルマント(F2)を計測し、表にまとめたもの
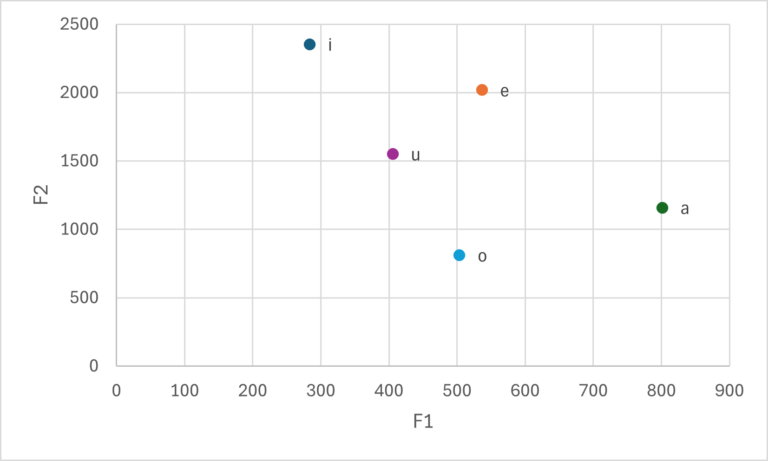
- それを散布図にしたもの
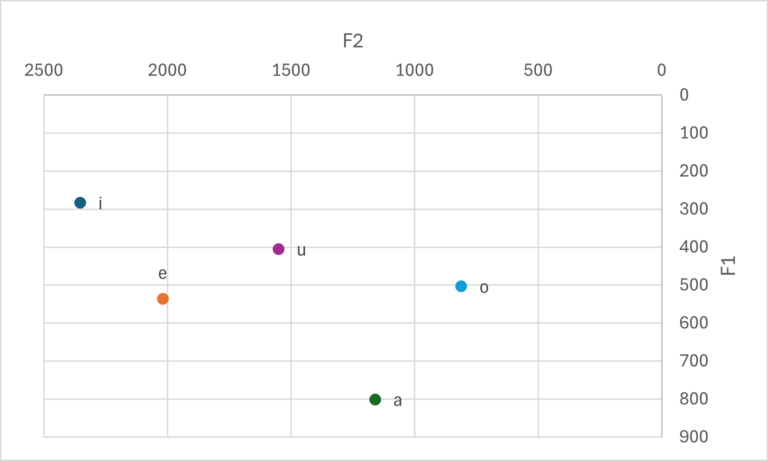
- 軸を入れ替えたもの
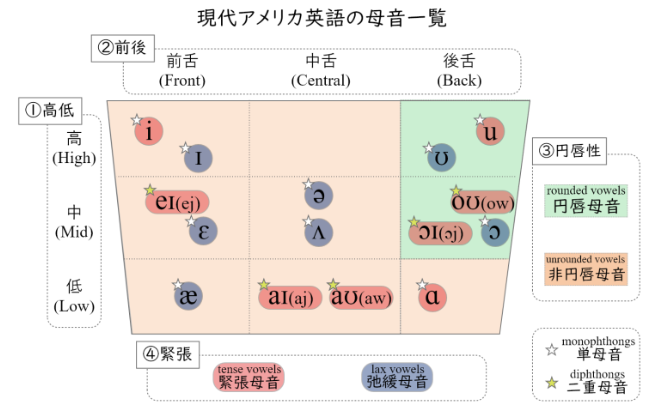
- IPA(国際音声記号)の母音チャートと、ほぼ同じ配置になる
音声処理でよく使われる特徴量
ゼロ交差率(Zero-Crossing Rate, ZCR)とは
- 波形が正から負、または負から正に切り替わる回数を、一定区間内で数えた指標
- 以下のような式で表される
- $\text{sign}(x)$は、$x$の符号(正なら1、負なら-1)を返す関数
- 隣り合うサンプルの符号が変わるたびに差の絶対値が2になるので、それを$2(N-1)$で割ることで「切り替わった割合」になる
- 高い周波数成分が多いほどZCRは大きくなる傾向がある
- 無声子音(s、shなど、声帯を震わせずに出す音)はノイズに近い波形になりやすく、ZCRが高くなる
- 逆に母音のような有声音は、周期的な波形になりやすく、ZCRは低くなる傾向がある
- 古典的なVADでは、エネルギー(音量が小さい=無音)だけでなく、ZCR(ノイズっぽい波形かどうか)も組み合わせて判定に使うことがある
基本周波数(F0・ピッチ)を特徴量として使う
- F0の定義そのものは、前述の「声の音響的な仕組み」を参照
- 有声音(母音など、声帯が振動する音)にはF0が存在し、無声音(子音の一部など、声帯が振動しない音)にはF0が存在しない
- F0が検出できるかどうかは、有声音/無声音の判定や、話者の特定(声の高さの特徴)に使われる
- 抽出方法としては、自己相関関数を使う方法、YINアルゴリズム、CREPEのようなディープラーニングベースの手法などがある
スペクトル重心・スペクトル平坦度とは
- どちらも、周波数スペクトル(音をどの周波数がどれだけ含むかに分解したもの)の形状を要約する指標
- スペクトル重心(Spectral Centroid)は、スペクトルの「重心」にあたる周波数
- $f_k$が周波数、$S(f_k)$がその周波数のパワー
- 値が高いほど高周波成分が多く「明るい」音、低いほど「こもった」音という印象になる
- スペクトル平坦度(Spectral Flatness)は、スペクトルがノイズのように平坦か、特定の周波数に偏っているかを表す指標
- 幾何平均と算術平均の比で計算され、1に近いほどホワイトノイズのような平坦なスペクトル、0に近いほど特定の周波数(ピッチなど)に偏ったスペクトルになる
音源定位(GCC-PHAT)
- 複数のマイク(マイクアレイ)を使って、音がどの方向から来たかを推定する技術を音源定位(Sound Source Localization)と呼ぶ
- GCC-PHAT(Generalized Cross-Correlation with PHAse Transform)は、その代表的な古典的手法の1つ
- 基本的な考え方は、2つのマイクに音が届くタイミングのズレ(到達時間差、TDOA: Time Difference of Arrival)を、相互相関(クロスコリレーション)を使って推定するというもの
- 通常の相互相関は振幅の大きさに影響されやすいため、GCC-PHATでは周波数領域で振幅成分を正規化し、位相情報だけを使って相互相関を計算する。これが「PHAT(Phase Transform)」という名前の由来
- マイク間の距離と、推定した到達時間差から、音源がどの方向にあるかを計算できる
- 複数マイクを使ったビームフォーミングや、話者の方向推定の前段としてよく使われる
まとめ
- 音は空気の振動で、振幅(音量)・周波数(音の高さ)・位相という要素で表される
- デジタル化は、サンプリング(時間方向の離散化)と量子化(振幅方向の離散化)の2段階で行われ、その生データがPCM。これを実際のハードウェアとして行うのがADC(録音)とDAC(再生)
- サンプリング定理により、記録したい最大周波数の2倍以上のサンプリング周波数が必要になる
- 音声ファイルには、非圧縮(WAV)・可逆圧縮(FLAC)・非可逆圧縮(MP3など)がある
- FFT・STFTを使うと、波形を周波数領域(スペクトログラム)に変換して、音の中身を分析できる。フレームサイズとホップサイズの選び方には、時間分解能と周波数分解能のトレードオフがある
- 多くの音声処理は振幅(パワー)の情報だけを使い、位相の情報は捨てることが多い
- RMS・dB・dBFS・SNRは、音の大きさやノイズとの関係を表すための一連の指標
- ノイズフロアは、系が持つ最低限のノイズレベルで、それより小さい信号は検出できない。ビット深度が生む量子化ノイズフロアもその一種。ノイズを除去する技術がノイズ抑制・音声強調
- メル尺度は人間の聴覚特性に合わせた周波数の圧縮で、log-melスペクトログラムやMFCCの土台になっている
- 声は基音(F0)とその整数倍の倍音からなる周期波で、声道の共鳴が特定の周波数帯(フォルマント)を強める。F0は音程、フォルマント(F1・F2)は母音・声質に対応する
- 声帯が振動する有声音と、振動しない無声音の違いは、F0の有無やZCRで機械的に判定できる
- ZCR・F0・スペクトル重心/平坦度は、VADや音声分類などで昔からよく使われてきた古典的な特徴量
- ハードウェアの一定クロックとソフトウェアの断続的な処理のギャップを、リングバッファが埋めている。読み込み位置が書き込み位置に追いつくとunderrun、その逆でoverrunが起きる
- Linuxでは、PulseAudioやPipeWireのようなサウンドサーバーがアプリとハードウェアの間の音声ルーティングを担う。クオンタム(処理単位のサンプル数)が小さいほど低遅延だが、xrunが起きやすくなる
- 複数マイクを使った音源定位には、位相情報を使うGCC-PHATのような手法がある
参考文献
- 音の3要素とは何?音楽の理解に欠かせない基礎知識│er-theory
- [1分でわかる]Speech Enhancementってなんだ?音源分離との違いと、その概念編 #音声AI - Qiita
- Energy-Efficient Hardware Acceleration of Whisper ASR on a CGLA
- Azure OpenAI で音声とオーディオに GPT Realtime API を使用する - Microsoft Foundry | Microsoft Learn
- 音声認識AIモデル ZipFormer - Convergence Lab.
- 音響特徴量「メルスペクトル」と「MFCC(メル周波数ケプストラム係数)」の解説と実例紹介|お知らせ/ブログ|「FAST-D」AI異音検知ソリューション | Hmcomm株式会社
- 音声認識の仕組みをざっくり解説! - AmiVoice Techblog
- エントロピーの再発明 | 圧縮と知能 Part 1 - YouTube
- 共鳴と母音のフォルマント | 音声学入門 | 発音と音声学の資料室
- 【音声学】英語の母音の種類/分類、IPAチャートをわかりやすく解説