目次
背景
- 京大の統計の「統計の入門」イントロダクションのPDFを見ていたらいい事が書いてあった
- そこで、AIで記述統計から検定・回帰・因果推論まで、基本的な用語と考え方を一覧化した
- また、統計検定も好きでやっているので、それの不足している知識も残した
確率と統計の違い
以下の違いがある。
- 確率
- 「モデルから起こりうる事象の確率を計算する」学問
- 統計
- 「手元のデータから逆にモデルや母集団の性質を推測する」学問
統計学の分類
記述統計と推測統計
統計学は大きく2つに分かれる。
- 記述統計(Descriptive statistics)
- 手元にあるデータそのものの特徴を、要約・可視化してわかりやすくすること
- 例: クラス40人の身長を測って、平均や分布を出す
- 推測統計(Inferential statistics)
- 手元のデータ(標本)から、その背後にある母集団の性質を推測すること
- 例: そのクラス40人の身長から、日本全体の同学年の平均身長を推測する
手元のデータを「見やすくする」のが記述統計、手元のデータから「見えていないものを推測する」のが推測統計。
頻度主義統計とベイズ主義統計
推測統計はさらに、確率をどう解釈するかという立場によって2つに分かれる。
- 頻度主義統計(Frequentist statistics)
- 確率を「試行を繰り返した時の相対頻度」として解釈する
- 母数は未知だが固定された値とみなし、標本から点推定・区間推定(信頼区間)や仮説検定(p値)で迫る
- ベイズ主義統計(Bayesian statistics)
- 確率を「信念の度合い」として解釈する
- 母数自体を確率変数とみなし、事前分布に観測データを反映して事後分布を更新する(ベイズの定理)
- 区間推定に対応するのが信用区間(credible interval)
記述統計か推測統計か、推測統計であれば頻度主義かベイズ主義か、という2段階の分類。
推測統計の方法(仮説検定と推定)
推測統計はさらに2つの方法に分かれる。
- 仮説検定(Hypothesis testing)
- 標本をもとに、母集団に関する仮説の真偽を調べる方法
- 推定(Estimation)
- 標本をもとに、母集団の未知のパラメータ(母数)の値を推定する方法
JIS・ISOでの統計用語の定義
統計用語には日本産業規格(JIS)による正式な定義があり、中心になるのがJIS Z 8101「統計-用語及び記号」シリーズ。
- JIS Z 8101-1:一般統計用語及び確率で用いられる用語
- JIS Z 8101-2:統計の応用
- JIS Z 8101-3:実験計画法
- JIS Z 8101-4:標本調査法
日本独自の規格ではなく、国際規格ISO 3534シリーズと一致(IDT)しており、例えばJIS Z 8101-1:2015はISO 3534-1:2006と一致している。
例えば標本(サンプル)は「一つ以上のサンプリング単位からなる母集団の部分集合」と定義されており、統計用語として正式な日本語が何かを調べる際の強い拠り所になる。
統計の計画
PPDACサイクル
- 統計的な問題解決の進め方を5つのステップに整理したフレームワーク
- Problem(問題)・Plan(計画)・Data(データ)・Analysis(分析)・Conclusion(結論)の頭文字
- 各ステップの内容
- Problem: 何を明らかにしたいか、問題を明確にする
- Plan: どうやって調べるか、調査方法やデータの集め方を計画する
- Data: 計画に沿ってデータを収集・整理する
- Analysis: データを分析し、パターンや傾向を見出す
- Conclusion: 分析結果から結論を導き、Problemに立ち返って答える
- Conclusionの結果、新たな疑問が生まれた場合は、それを次のProblemとしてサイクルを繰り返す
- 統計は計算そのものより、このサイクル全体を意識することが大切
観察研究と実験研究
PPDACの「Plan」段階で、まず決めるべきことの1つが、観察研究と実験研究のどちらで進めるか。
- 観察研究(Observational study)
- 研究者は介入せず、起きている事象をそのまま観察・記録する方法
- 例: コホート研究(集団を追跡して比較する)、ケースコントロール研究(症例群と対照群を比較する)
- 手軽に実施できるが、交絡因子を完全には排除できないため、因果関係の主張が弱くなりやすい(後述の「見せかけの相関」も参照)
- 実験研究(Experimental study)
- 研究者が能動的に介入・割り付けを行う方法
- 例: RCT(ランダム化比較試験、詳細は後述の「因果推論」を参照)
- 交絡因子の影響をランダム化によって均等化できるため、観察研究より強い因果関係の主張ができる
例:勉強時間と学力の関係
「勉強時間と学力の関係」を調べたい場合、観察研究と実験研究では、以下のようにアプローチが変わる。
- 観察研究の場合
- 生徒たちの実際の勉強時間を調査し、「1日3時間以上勉強するグループ」と「3時間未満のグループ」に分けて、学力テストの点数を比較する
- 生徒自身がどれだけ勉強するかを選んでいるため、仮に3時間以上のグループの方が高得点だったとしても、それが本当に勉強時間の効果なのか、「もともと学習意欲が高い」「家庭の教育環境が良い」といった別の要因(交絡因子)による差なのかを区別できない
- 実験研究の場合
- 生徒をランダムに2グループ(A・B)に分け、Aには1日3時間未満、Bには3時間以上勉強するよう割り当て、その後の学力テストの点数を比較する
- ランダムに割り振っているため、学習意欲や家庭環境などの交絡因子は、平均的には両グループで同じくらいになる(前述のRCTと同じ考え方)
- そのため、点数差が出れば、それは勉強時間の違いによるものだとより強く主張できる
- ただし、生徒に勉強時間を強制するのは倫理的・現実的に難しいことも多く、実験研究が実施できず観察研究しかできない場面も多い
ようは条件に介入するのかしないのかの違い。
実験計画法(Design of Experiments, DOE)
実験研究をどう設計すれば、効率よく妥当な結論を導けるかを体系化した分野。
フィッシャー(Ronald Fisher)が農業実験の中で確立した、以下の3原則が基本になる。
- 無作為化(Randomization)
- 前述のRCTと同じ考え方で、条件をランダムに割り付けることで交絡因子を均等化する
- 反復(Replication)
- 同じ条件で複数回実施すること
- 誤差そのもののばらつきを評価できるようになり、偶然による結果を見分けやすくなる
- 局所管理(Local control / Blocking):
- 実験全体をいくつかの「ブロック」に分け、ブロック内では注目したい要因以外の条件をできるだけ揃える
- 例:農地の実験で、同じ畑でも場所によって日当たりや土壌が違う場合、近い区画同士をブロックにまとめて比較する
要因実験:
- DOEでは、複数の要因を同時に調べる要因実験(Factorial experiment、要因計画/Factorial design)もよく使われる
- 最も基本的な実験計画で、要因の組み合わせを総当たりで実験する
- 例: 「勉強時間」と「睡眠時間」の2つの要因を、それぞれ2水準(多い/少ない)で組み合わせた、計4パターンの実験を同時に行う
- そのことで、各要因の効果に加えて、要因同士の交互作用(勉強時間の効果が睡眠時間によって変わるか、など)も調べられる
- 1つの要因ずつ順番に調べる一因子実験と異なり、交互作用の影響まで調べられるのがメリット
- その一方、要因や水準が増えると必要な実験数が急増するのが難点
データの種類と尺度水準
統計データは大きく2種類に分かれる。
- 質的データ(Qualitative data)
- 血液型や好き嫌いのように、記号・カテゴリを値としてとるデータ
- 量的データ(Quantitative data)
- 身長や気温のように、数値を値としてとるデータ
さらに、データがどんな演算を許すかで4つの尺度水準に分けられる。
| 尺度 | 意味 | 許される演算 | 例 |
|---|---|---|---|
| 名義尺度(Nominal scale) | 値がただのラベル | 一致/不一致の判定のみ | 血液型・性別 |
| 順序尺度(Ordinal scale) | 順序に意味がある | 大小比較まで | 満足度アンケート(良い/普通/悪い) |
| 間隔尺度(Interval scale) | 間隔(差)に意味があるが原点は任意 | 加減算まで | 気温(摂氏) |
| 比率尺度(Ratio scale) | 原点(0)にも意味がある | 加減乗除すべて | 体重・身長・金額 |
尺度水準を間違えると、平均を取ってはいけないデータの平均を取ってしまうような誤りにつながる。例えば、アンケートの「良い=3、普通=2、悪い=1」を単純平均するのは、間隔が本当に等しいとは限らないので本来は注意が必要。
間隔尺度と比例尺度の違い
間隔尺度と比率尺度はどちらも数値で、加減算もできるため混同しやすいが、決定的な違いが1つある。比(倍率)に意味があるかどうか。
- 比率尺度: 原点(0)が「本当に無い状態」を表すため、比に意味がある。体重20kgは体重10kgの「2倍」と言ってよい
- 間隔尺度: 原点が恣意的に決められているだけなので、比に意味がない
具体的に、気温(摂氏)で確認する。20℃は10℃の「2倍暑い」と言えるだろうか。
- 10℃ = 50℉
- 20℃ = 68℉
摂氏での比は$20/10=2$だが、同じ2点を華氏に変換すると、比は$68/50=1.36$になる。単位を変えただけで比の値が変わってしまうということは、その「2倍」という関係は温度そのものの性質ではなく、摂氏という尺度の選び方に依存した、実体のない比較だったことになる。
これは、摂氏の0℃が「水が凍る温度」という人間が決めた基準点に過ぎず、「熱が全く無い状態」を表していないために起こる。原点が恣意的である以上、そこからの比は意味を持たない。
対照的に、体重の例で同じ検算をすると比は保たれる。
- 10kg ≈ 22.05lb
- 20kg ≈ 44.1lb
ポンドでの比も$44.1/22.05=2$となり、摂氏の場合とは違って、単位を変えても比が保たれる。体重の0kgは「質量が本当に無い状態」を表す、恣意的でない原点だから、比に意味がある。
なお、同じ温度でもケルビンは比率尺度になる。ケルビンの0K(絶対零度)は、熱運動が理論上完全に止まる、恣意的でない物理的な原点のため、「20Kは10Kの2倍の熱エネルギー」という言い方は、摂氏とは違って意味を持つ。
データの整理と確認
ヒストグラムまでの流れ
生データから度数分布表・ヒストグラムを作るまでは、大まかに以下の流れになる。
- 生データを集める
- データをソートする
- 階級を決める(後述の「階級の決め方」を参照)
- 階級ごとにデータを振り分ける(量子化)
- 度数をカウントする
- 相対度数を計算する(度数を全体件数で割る)
- 累積相対度数を計算する(積み上げる)
- 度数分布表(相対度数分布表・累積度数分布表も)にまとめる
- ヒストグラムにする
ざっくり10 stepぐらい。
量子化(Quantization)
- 量的データは、測定の精度によって際限なく細かい値を取りうるため、生のままでは種類が多すぎて分布をつかみにくい
- そこで、値が取りうる範囲をあらかじめいくつかの区間(階級)に区切っておき、観測された値をどの階級に入るかで置き換えて集計することを量子化と呼ぶ
- 階級は英語でbin(ビン)とも呼ばれ、量子化は「連続的な値をbin単位の有限個の値にまとめ直す」処理といえる
- 例: 体重を1kg刻みの階級に量子化する場合、52.3kgも52.7kgも「52kg台」という同じ階級にまとめられる
データ・階級・度数
データ・階級・度数を、それぞれ記号で表すと以下のようになる。
- データ(Data)
- $n$個のデータを$X = \{x_1, x_2, \ldots, x_n\}$とする
- 階級(Class)
- 値の範囲を$k$個の区間に分け、$j$番目の階級を$I_j = [a_j,\ a_{j+1})$とする
- つまり、下限を含み上限を含まない、など境界の扱いはあらかじめ決めておく
- 度数(Frequency)
- 階級$I_j$に入るデータの個数を$f_j$とする
- つまり$x_i \in I_j$を満たす$x_i$の個数
この記号からも、度数$f_j$がデータ$X$と階級$I_j$の両方に依存して決まる値であることがわかる。
累積度数・相対度数・累積相対度数
度数だけだと全体に対する割合がわかりにくい。そこで、以下のような指標もあわせて使う。
- 総度数(Total frequency)
- 全ての階級の度数を合計したもの。通常$N$や$n$で表す
- 相対度数(Relative frequency)
- 度数を総度数で割ったもの
- 全ての階級で足し合わせるとちょうど1(100%)になる
- 累積度数(Cumulative frequency)
- $j$番目の階級までの度数を足し合わせたもの
- 累積相対度数(Cumulative relative frequency)
- 累積度数を総度数$n$で割ったもの($F_j / n$)
- 例: テストの点数を階級ごとに集計したとき、「60点未満の階級までの累積相対度数」を見れば、そのテストで60点未満だった人が全体の何割いたかが一目でわかる
度数分布表とヒストグラム
各階級に入るデータの個数(度数)を数え、それを表・グラフにしたもの。
- 度数分布表(Frequency distribution table)
- 各階級の度数を表にまとめたもの
- 相対度数分布表(Relative frequency distribution table)
- 各階級を、度数の代わりに前述の相対度数(割合)でまとめた表
- 全体の件数が違うデータ同士を比較したいときは、件数そのものより割合で見た方が比較しやすい
- 累積度数分布表(Cumulative frequency distribution table)
- 各階級を、度数の代わりに前述の累積度数でまとめた表
- 「ある階級までに何件あるか」を知りたいときに使う
- ヒストグラム(Histogram)
- 度数分布表をグラフにしたもの
パレート図(Pareto chart)
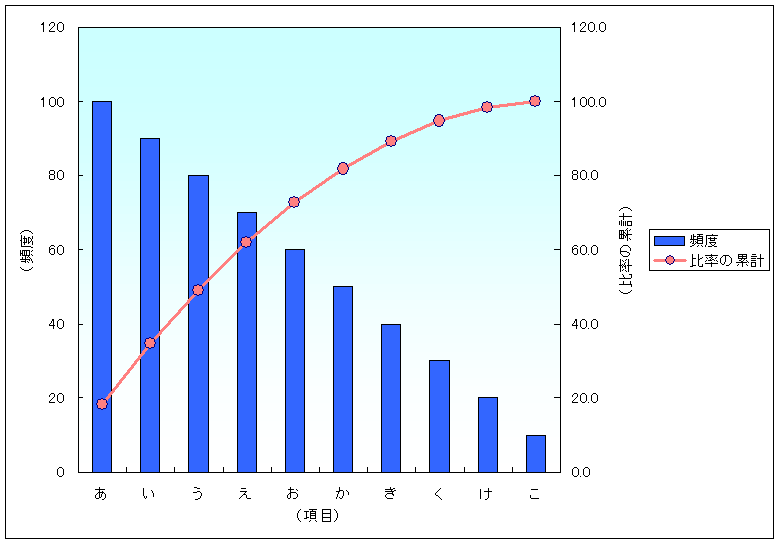
- 度数の大きい順に階級(カテゴリ)を並べ替えた棒グラフに、累積相対度数の折れ線を重ねたグラフ
- ヒストグラムは値の大きさの順に並べるのに対し、パレート図は度数の多い順に並べる点が異なる
- 主に、質的データ(カテゴリ)の集計や、品質管理での不良原因の分析に使われる
- 「全体の結果の大部分は、ごく一部の要因が生み出している」という経験則(パレートの法則、80:20の法則)を確認するのに向いている
- 例: 製品の不良原因を件数の多い順に並べ、上位いくつの原因で不良全体の何割を占めるかを、累積相対度数の折れ線で確認する
階級の決め方
- 階級の幅を細かくしすぎるとデータがまばらになって分布が読み取りにくく、粗くしすぎると情報が潰れてしまう
- ちょうどよい階級の数を決める目安として、スタージェスの公式(Sturges’ rule)がよく使われる
- $n$はデータの個数、$k$は階級の数の目安(実際には四捨五入して使う)
- データの個数が多いほど階級数を増やしてよいが、対数なので増え方は緩やか(データが2倍になっても階級を1つ増やす程度)
- あくまで目安であり、データの分布の形に応じて調整してよい
データの要約
最小値・最大値・範囲
データを小さい順に並べたときの端の値と、その幅を表す指標。
- 最小値(Minimum)
- 一番小さい値
- 最大値(Maximum)
- 一番大きい値
- 範囲(レンジ、Range)
- 最大値から最小値を引いたもの
- データ全体がどれくらいの幅に収まっているかを表す最も単純な散らばりの指標
- 外れ値が1つ混ざるだけで大きく変わってしまうので、外れ値に弱いという欠点がある
四分位数
中央値と同じ考え方を応用したものが四分位数(Quartile)。
- 第1四分位数(Q1)
- 小さい方から数えて全体の25%の位置にくる値
- 第2四分位数(Q2)
- ちょうど中央値のこと(50%の位置)
- 第3四分位数(Q3)
- 小さい方から数えて全体の75%の位置にくる値
- 四分位範囲(Interquartile range, IQR)
- 第1四分位数から第3四分位数までの幅
- データの真ん中50%がどれくらいの幅に収まっているかがわかる
5数要約(Five-number summary)
データを小さい順に並べたときの代表的な5つの値をまとめたもの。
| 値 | パーセンタイル |
|---|---|
| 最小値(Minimum) | 0パーセンタイル |
| 第1四分位数(Q1) | 25パーセンタイル |
| 第2四分位数(Q2、中央値) | 50パーセンタイル |
| 第3四分位数(Q3) | 75パーセンタイル |
| 最大値(Maximum) | 100パーセンタイル |
1次元の数値軸上に5つの値をブロック図として配置すると、以下のようになる。
| |
- 後述の箱ひげ図は、この5数要約をそのまま図示したもの
- 四分位数(Q1・Q2・Q3)自体は3つしかなく、データを4つのグループに分ける境界線に過ぎない。そこに両端の最小値・最大値を加えてはじめて、5つの値になる
- $n$個のグループに分けるには$n-1$個の境界点で足りるが、全体の範囲まで示すには両端の2点を加えた$n+1$個の値が必要になる。「四分位数」という名前から4つの値を連想しがちだが、実際の四分位数は3つ、5数要約は5つという、よくある数え間違いのパターン
- 逆から見ると、5つの値の間には4つの区間(最小値〜Q1、Q1〜Q2、Q2〜Q3、Q3〜最大値)ができ、それぞれが全体のだいたい25%ずつを含む。「点が5つ、区間が4つ」という、同じフェンスポストの関係を逆側から見た形
パーセンタイル(Percentile)
- 四分位数と同じく、データを小さい順に並べたときの位置を表す値だが、区切りが100等分になったもの
- $p$パーセンタイルは、データを小さい順に並べたとき、下から$p$%の位置にくる値
- 四分位数は、パーセンタイルの特殊ケースにあたる
- 第1四分位数 = 25パーセンタイル
- 第2四分位数(中央値) = 50パーセンタイル
- 第3四分位数 = 75パーセンタイル
- 同様に、10等分した区切りは十分位数(decile)と呼ばれる
- 例: モデルの推論時間を計測して「99パーセンタイルが500ms」と言う場合、全体の99%の推論が500ms以内に収まっている、という意味になる
パーセンタイルの2通りの計算方法
四分位数・パーセンタイルの求め方は、生データを持っているかどうかで2通りに分かれる。どちらも単独で完結する方法で、ややこしいので整理しておく。
- 点を求める
- 生データ(個々のデータ)を使う
- ソート済みの生データから、目標の順位(例: 第3四分位数なら$\frac{3n}{4}$番目)の値を直接取り出す
- 階級は一切経由しない、最も基本的な方法
- 区間(階級)を求める
- 度数分布表(階級+度数)を使う
- 累積度数を使って、目標の順位がどの階級に入るかを特定し、その階級の中で線形補間する
- 注意:階級が10個あるからといって、第3四分位数を単純に「6番目と7番目の階級の中間」とするのは誤り
代表値(Measure of central tendency)
データ全体を1つの値で代表させたものを代表値と呼ぶ。
- 平均値(Mean)
- 全データの合計をデータ数で割ったもの
- 外れ値の影響を強く受ける
- 中央値(Median)
- データを小さい順に並べたとき、ちょうど真ん中にくる値
- 最頻値(Mode)
- 最も出現頻度が高い値
例えば、社員9人の年収がだいたい400万円台に集まっている会社に、年収1億円の社長が1人加わると、平均年収は一気に跳ね上がるが、中央値はほとんど動かない。「平均的な年収」を知りたいなら、こういう場面では中央値の方が実態に近いことが多い。
度数分布表からの平均の近似
- 生データが手元になく、度数分布表(階級+度数)しかない場合、平均は階級値(各階級の中央の値)を使って近似する
- $m_i$: 各階級の階級値
- $f_i$: 各階級の度数
- $N$: 総度数($\sum_i f_i$)
- 階級分けした時点で各データの正確な値は失われ、「その階級の中にある」という情報しか残っていないため、便宜上すべてのデータがその階級の階級値に集まっていると仮定して計算する
- そのため、生データで直接計算する平均(合計をデータ数で割ったもの)とは違い、情報の一部が失われた状態での近似値になる
偏差・偏差平方和・分散・標準偏差・変動係数
- 代表値だけでは「データがどれくらいばらついているか」がわからない
- 平均値が同じでも、全員がほぼ同じ値のデータと、大きくばらついているデータでは意味が違う
- 前述の範囲(レンジ)も、最小値と最大値だけを使った最も単純な散らばりの指標だった(外れ値に弱い点に注意)
- 偏差(Deviation): 各データ点と平均の差$x_i - \bar{x}$。正負両方の値を取り、単純に平均するとちょうど0になってしまうため、そのままでは散らばりの指標として使えない
- 偏差平方和(Sum of Squares, SS): 各データ点の偏差を2乗してから合計したもの。平均を取る前の、分散の分子にあたる量
- 分散(Variance)は、この偏差平方和をデータ数$n$で割って平均したもの。つまり、偏差の2乗の平均=分散
- 2乗しているため単位がもとのデータと変わってしまうので、その平方根を取った標準偏差(Standard deviation)がよく使われる
- 標準偏差は、ばらつきの絶対的な大きさを表す指標だが、単位や平均の大きさが違うデータ同士は、そのままでは比較しにくい
- 例えば「身長のばらつき(cm)」と「体重のばらつき(kg)」は単位が違うので直接比較できない。同じ単位でも、平均が大きく違う集団同士では、同じ標準偏差でも相対的なばらつきの大きさは変わってくる
- そこで、標準偏差を平均で割った変動係数(Coefficient of Variation, CV)を使うと、単位やスケールの影響を取り除いた「相対的なばらつき」として比較できる
- 通常は100をかけて%で表すことが多い
- 平均が0に近い、または0をまたぐデータには使えない(分母がゼロに近づき値が発散するため)
変動係数が必要な理由
同じ尺度・同じ平均水準のデータを比べるだけなら標準偏差で十分だが、平均の水準が大きく違うデータ同士を比べる場合、標準偏差だけでは誤った印象を持ちやすい。
| データ | 平均 | 標準偏差 | 変動係数 |
|---|---|---|---|
| A | 100 | 10 | 10% |
| B | 10 | 5 | 50% |
- 標準偏差だけ見ると、Aの方が10>5なので「Aの方がバラついている」と見える
- しかし平均との比で見ると、Aは平均100に対して±10(10%)なのに対し、Bは平均10に対して±5(50%)で、Bの方が相対的にはるかにバラついている
- つまり標準偏差の大小が、相対的なばらつきの大小と逆転することがある。これが、平均の水準が異なるデータ同士を比較する際に変動係数が必要になる理由
箱ひげ図(Box plot)
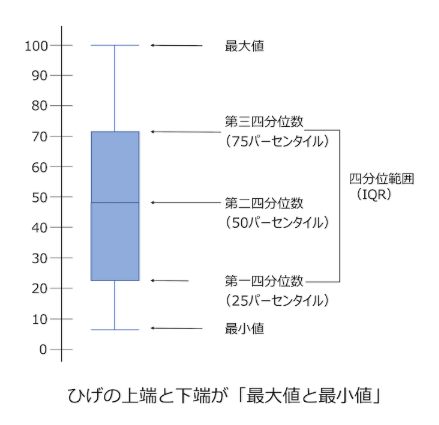
- 最小値・第1四分位数・中央値(第2四分位数)・第3四分位数・最大値の5つを、まとめて1つの図に表したもの
- 箱の下端が第1四分位数、上端が第3四分位数、箱の中の線が中央値
- 箱から伸びるひげが、最小値と最大値の方向を示す
- 複数のグループのデータを並べて箱ひげ図にすると、ヒストグラムを並べるより一覧性が高く、グループ間のばらつきや中心の違いを比較しやすい
外れ値(Outlier)
- 他の観測値から大きく外れた値のこと
- 四分位範囲(IQR)を使った判定方法が代表的(Tukeyの基準)
- この範囲の外側にある値を外れ値とみなす
- 上限の基準点はQ3、下限の基準点はQ1で、そこからそれぞれ1.5×IQR分だけ外側にずらした位置がフェンス(下限・上限)になる。最小値・最大値はこの計算に一切使われない
- 「IQRが真ん中50%を含む」というのは順位(パーセンタイル)の話で、IQRの実際の値の大きさと最大値・最小値との間には決まった関係はない。そのため、健全なデータ(外れ値が1つもない場合)でも、フェンスは実際の最小値・最大値より外側に位置するのが普通
- 箱ひげ図のひげは、本来この範囲内に収まる最小値・最大値までを指し、それより外側の値は個別の点として描かれることが多い
- 他に、平均から標準偏差の2〜3倍以上離れた値を外れ値とする、Zスコアによる判定方法もある(ただし平均・標準偏差自体が外れ値の影響を受けやすいため、IQRの方が頑健とされる)
外れ値を見つけたときにまず考えるべきは、それが機械的に対処してよいものかどうか。
- 入力ミス・測定機器の故障・単位の誤りなど、明らかな誤りであれば、修正するか除外する
- 一方で、実際に起きた極端な事象(大口の注文、まれな症例など)であれば、それ自体が重要な情報を持っている可能性がある
- 後者を安易に除外すると、モデルや分析が本来捉えるべき極端なケースを見失うことになる
- つまり外れ値は「ノイズとして消すもの」と決めつけず、まず何が起きてその値になったのかを確認するのが先
欠損値(Missing Value)
- 本来あるはずの値が記録されていない状態
- 欠損の起き方は、大きく3つのパターンに分類される
- MCAR(Missing Completely At Random): 欠損が完全にランダムに起きている。例えば、アンケート用紙の一部が輸送中に紛失した場合
- MAR(Missing At Random): 欠損の起きやすさが、観測されている他の変数に依存する。例えば、若い回答者ほど年収欄を空欄にしやすい、という場合
- MNAR(Missing Not At Random): 欠損の起きやすさが、欠損した値そのものに依存する。例えば、年収が高い人ほど年収を答えたがらない、という場合
- MNARが最も厄介で、欠損のパターン自体に情報があるため、単純に無視すると結果が偏る
欠損値への対処方法もいくつかある。
リストワイズ削除: 欠損を含む行をまるごと除外する。単純だが、MCARでない場合にサンプルが偏りやすく、サンプルサイズも減る
補完(Imputation): 平均値・中央値・最頻値で埋める、回帰モデルで予測して埋める、多重代入法で複数パターンの補完値を作り結果の不確実性ごと扱う、など
欠損そのものをカテゴリとして扱う: 「欠損している」という情報自体に意味がある場合(MNARに近いケース)、欠損フラグを新しい変数として追加する
どの方法が適切かは、欠損がMCAR・MAR・MNARのどれに近いかによって変わるため、対処する前に欠損のパターンを確認する価値がある
変数変換
なぜ変数変換をするのか
- 手元のデータの分布や形を、扱いやすい形に変換してから分析することがある。これを変数変換と呼ぶ
- 主な目的は以下の通り
- 分布の形を整える: 多くの統計手法は、データが正規分布に近いことを前提にしているため、大きく歪んだ分布を対称に近づけたい
- ばらつきを安定させる: 値が大きいデータほどばらつきも大きくなる、といった不均一分散を抑えたい
- 関係を直線に近づける: 回帰分析などで、変数同士の関係が直線的になるよう整えたい
- 掛け算の関係を足し算の関係に変える: 対数を取ると、積が和になる(前述の「関数の線型性」の記事も参照)
対数変換(Log transformation)
- $x$を$\log x$に置き換える変換($x>0$が前提)
- 所得・人口・ウェブサイトのアクセス数のように、右に裾が長く伸びた分布(少数の大きな値が全体を引っ張る分布)を、対称に近い分布に整えるのによく使われる
- 値の差ではなく、値の比率(何倍か)に意味があるデータとも相性がよい
平方根変換(Square root transformation)
- $x$を$\sqrt{x}$に置き換える変換($x\geq0$が前提)
- 対数変換よりは緩やかな変換で、件数・回数のようなカウントデータ(値が大きいほどばらつきも大きくなりやすいデータ)によく使われる
ロジット変換(Logit transformation)
- 0〜1の範囲に収まる割合・確率$p$を、$-\infty$から$\infty$まで取りうる値に変換する
- $\frac{p}{1-p}$はオッズ(あることが起こる確率と起こらない確率の比)と呼ばれ、ロジット変換はそのオッズの対数
- 割合・確率のデータをそのまま線形回帰にかけると、予測値が0〜1の範囲をはみ出すことがあるが、ロジット変換した上で扱えばこの問題を避けられる(ロジスティック回帰の考え方の土台でもある)
Box-Cox変換
- 対数変換・平方根変換などを、1つの式で統一的に扱えるようにした変換
- パラメータ$\lambda$を変えることで、平方根変換($\lambda=0.5$)・対数変換($\lambda=0$)・変換なし($\lambda=1$)など、様々な変換を1つの式で表現できる
- $\lambda$は、変換後のデータが最も正規分布に近くなるように、データから自動的に推定することが多い
- $y>0$が前提のため、負の値を含むデータには使えない(負の値も許容する拡張として、Yeo-Johnson変換がある)
標本調査と推定
母集団と標本(Population and sample)
- 母集団(Population)
- 調査の対象となる集団全体
- 全数調査(Census)
- 母集団のすべてを漏れなく調べる方法
- 標本(Sample)
- 母集団の一部だけを抜き出したもの
- 標本調査(Sample survey)
- 標本を使って母集団の性質を推測する調査
全数調査はコストや時間の面で難しいことが多いため、標本調査が使われることが多い。
標本調査の方法(Sampling methods)
標本の選び方には大きく2種類ある。
- 無作為抽出(Random sampling)
- 母集団の各要素が等しい確率で選ばれるように、偶然に任せて抽出する方法
- 有意抽出(Purposive sampling)
- 調べる側の都合や意図で対象を選ぶ方法
さらに、無作為抽出には主に5種類の方法がある。
- 単純無作為抽出(Simple random sampling)
- 母集団全体に通し番号を振り、くじや乱数を使って必要な数をそのまま選ぶ、最も基本的な方法
- 系統抽出(Systematic sampling)
- 母集団の名簿に番号を振り、一定の間隔ごとに標本を選ぶ方法
- 多段抽出(Multi-stage sampling)
- 抽出を複数の段階に分けて行う方法
- 例: 全国調査で、まず都道府県を無作為に選び、その中から市区町村を選び、さらにその中から対象者を選ぶ
- 層化抽出(Stratified sampling)
- 母集団の構成(性別や年代の割合など)があらかじめ分かっている場合に、その構成比に合わせて各層から抽出する方法
- 集落抽出(Cluster sampling)
- あらかじめ母集団をいくつかのグループ(集落)に分けておき、グループ単位で無作為に選び、選ばれたグループ内は全員を調査する方法
有意抽出は手軽だが、選ばれ方に偏りが生まれやすい。
- 選択バイアス(Selection bias)
- 標本の選ばれ方が偏っていることで、標本が母集団を正しく代表しなくなること
- 例: 「駅前で道行く人にアンケートを取る」方法は、平日昼間に駅前を歩ける人に偏ってしまい、働き方や年齢層に偏りが出やすい
母集団全体について何かを言いたいなら、無作為抽出が原則望ましい。
推定(Estimation)
標本から母集団の値(母数)を推測することを推定と呼ぶ。
推定の方法(点推定と区間推定)
推定には大きく2種類の方法がある。
- 点推定(Point estimation)
- 母数を1つの値でズバリ言い当てる推定
- 例: 標本平均を、母平均の推定値としてそのまま使う
- 区間推定(Interval estimation)
- 母数がこの範囲に入っているだろう、という幅(区間)で推定する
- 「95%信頼区間(Confidence interval)」のように、どれくらいの確からしさで区間を示しているかをセットで表す
点推定は分かりやすいが、標本を変えるたびに値がずれるので、そのズレ(誤差)の大きさまでは分からない。区間推定は、その誤差の大きさまで含めて表現できるので、より情報量が多い。
仮説検定(Hypothesis testing)
帰無仮説と有意水準
仮説検定は、「差がない」「関係がない」という仮説が、データと矛盾するかどうかを確率的に判断する方法。
- 帰無仮説(Null hypothesis)
- 「差がない」「効果がない」のように、否定したい前提として立てる仮説
- 対立仮説(Alternative hypothesis)
- 帰無仮説が正しくなかった場合に採用する、本来主張したい仮説
- 有意水準(Significance level)
- 帰無仮説を誤って棄却してしまう確率の上限として、あらかじめ決めておく基準(よく5%や1%が使われる)
検定の考え方は、いきなり「差がある」ことを直接証明するのではなく、まず「差がない」と仮定して、それとデータが矛盾するかどうかを調べる、という間接的な進め方をする。具体的には、帰無仮説が正しいと仮定したときに、実際に観測された標本(またはそれ以上に極端な標本)が得られる確率を計算し、その確率が有意水準より小さければ「帰無仮説のもとでは起こりにくすぎる」とみなして帰無仮説を棄却する。
検定の前提条件(正規性・等分散性)
- t検定・分散分析(ANOVA)・線形回帰など、多くの検定手法(パラメトリック検定)は、背景にいくつかの前提を置いている
- 正規性(Normality)
- データ(または回帰の残差)が正規分布に従っている、という前提
- 確認方法として、ヒストグラムや正規Q-Qプロットで目視する方法、シャピロ・ウィルク検定(Shapiro-Wilk test)のような統計的検定を使う方法がある
- 等分散性(Homoscedasticity)
- 比較する複数のグループ間で、分散(ばらつきの大きさ)が等しい、という前提
- 確認方法として、ルビーン検定(Levene’s test)やバートレット検定(Bartlett’s test)がある
- これらの前提が崩れていると、検定結果(p値など)の信頼性が下がる
- 前提を満たせない場合の対処法は、主に2通りある
- 前述の変数変換(対数変換など)で、分布の形やばらつきを整えてから検定する
- その前提を必要としないノンパラメトリック検定(Non-parametric test)に切り替える
主な検定の種類(適合度の検定と独立性の検定)
限られた標本から母集団の性質を検定したいとき、よく使われる検定は主に2つある。
- 適合度の検定(Goodness-of-fit test)
- 母集団の分布が、ある理論値と差があるとみなせるかどうかを調べる検定
- 独立性の検定(Test of independence)
- 2つの事象の間に関係があるとみなせるかどうかを調べる検定
いずれも「差がある」「関係がある」と言えるかどうかを、カイ二乗統計量を使って判断する点は共通している。
適合度の検定(Goodness-of-fit test)
- 観測された度数の分布が、理論的に想定される分布と一致しているかを調べる検定
- 例: サイコロを600回振って、1〜6の目がそれぞれ均等(各100回程度)に出るはずのところ、実際の出目の分布が理論値からどれくらいズレているかを調べる
- 観測度数と期待度数のズレを、次のような統計量にまとめる(カイ二乗統計量、Chi-square statistic)
- $O_i$は実際に観測された度数、$E_i$は理論上期待される度数
- このズレが偶然の範囲では説明しにくいほど大きければ、「理論値通りではない(サイコロが歪んでいる等)」と判断する
独立性の検定(Test of independence)
- 2つの質的データの間に関係があるかどうかを調べる検定
- データをクロス集計表(分割表、Contingency table)に整理し、「もし2つの変数が独立だったら、理論的にはどんな表になるはずか」という期待度数を計算する
- 実際のクロス集計表と、独立を仮定した場合の期待度数のズレが大きいほど、2つの変数の間に何らかの関連があると判断できる
- 計算方法自体は適合度の検定と同じカイ二乗統計量を使う
- 例: 「コーヒーを毎日飲むかどうか」と「よく眠れているかどうか」を集計して、両者に関連があるかを調べる、といった使い方をする
相関と回帰
共分散(Covariance)
2つの量的データ$X$・$Y$が、どれくらい同じ方向に動くかを表す指標。
$$ \text{Cov}(X,Y) = \frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y}) $$- 分散と違い、二乗する代わりに、$(x-\bar{x})$と$(y-\bar{y})$をかける
- 正の値: $X$が平均より大きいとき、$Y$も平均より大きくなりやすい(同じ方向に動く)
- 負の値: $X$が平均より大きいとき、$Y$は平均より小さくなりやすい(逆方向に動く)
- 0に近い: 直線的な関係が弱い
- 前述の分散(Variance)は、共分散の特殊ケースにあたる($\text{Cov}(X,X) = \text{Var}(X)$)
- 弱点として、共分散の値そのものは$X$・$Y$の単位に依存するため、大きさの解釈がしづらい(例: 身長(cm)と体重(kg)の共分散の値だけを見ても、関係の強さを直感的に判断しにくい)
- そこで、共分散を$X$・$Y$それぞれの標準偏差で割って正規化したものが、次の相関係数
相関係数(Correlation coefficient)
- 2つの量的データの間に、直線的な関係がどれくらい強いかを表す指標が相関係数
- $-1$から$1$までの値を取り、$1$に近いほど強い正の相関、$-1$に近いほど強い負の相関、$0$に近いほど直線的な関係が弱いことを表す
散布図を描いて、実際の点の散らばり方を目で確認することも重要
相関係数だけを見ていると、直線的でない関係(例えばU字型の関係)を見落としてしまうことがある
相関係数は、2つの変数をそれぞれ基準化(平均0・標準偏差1に揃える変換)した上で共分散を計算したものとも一致する。証明は別記事「関数の線型性」の「共分散の双線形性」を参照
範囲の制限(Restriction of Range)
- サンプルの取り方によって、変数同士の本当の関係が変わらなくても、相関係数の見かけの値は大きく変わることがある
- 例えば身長と体重の関係を調べる際、身長が似たような人だけを集めると、相関係数は低くなる
- 理由は、相関係数が「2変数が一緒に動く度合い」を、変数自身のばらつきで正規化した指標だから。身長のばらつきを無くすと、身長で説明できる体重の変動も一緒に消えてしまい、相関係数の分母(身長の標準偏差)だけが先に小さくなる
- $Y=a+bX+\varepsilon$($\varepsilon$は$X$と無関係なノイズ)というモデルで考えると、相関係数の2乗は以下の形になる
- $X$の分散$\text{Var}(X)$を小さくするほど、$r^2$は0に近づく。$X$と$Y$の本当の関係(傾き$b$)は何も変わっていないのに、見かけの相関係数だけが下がる
- シミュレーションで確認すると、身長と体重の関係(傾き)を固定したまま、身長の標準偏差だけを変えると、相関係数は以下のように変化する
| 身長の標準偏差 | 相関係数 |
|---|---|
| 10cm(通常のばらつき) | 約0.87 |
| 1cm(かなり絞る) | 約0.16 |
| 0.3cm(ほぼ同じ身長の人だけ) | 約0.07 |
- つまり相関係数は、変数同士の関係の強さだけでなく、サンプルがどれだけの範囲を含むかにも強く依存する。見せかけの相関(Spurious correlation)とは逆に、本当は関係があるにもかかわらず、サンプルの取り方によって相関が見えなくなるケースにあたる
SHAP(SHapley Additive exPlanations)
機械学習モデルの予測に対して、各特徴量がどれだけ貢献しているかを説明する手法の1つにSHAPがある。
- Lundberg & Leeが2017年に提案した手法(
A Unified Approach to Interpreting Model Predictions, NeurIPS 2017, arXiv:1705.07874) - 協力ゲーム理論のShapley value(Lloyd Shapley, 1953)を、機械学習モデルの予測説明に応用したもの
- ある特徴量を含めた場合と含めなかった場合とで、モデルの予測値がどれだけ変化するかを、特徴量の全ての組み合わせ順序について平均することで計算する
- 各特徴量のSHAP値の合計が、ベースライン(平均的な予測値)と実際の予測値の差に一致するという加法性を持つ
相関係数がデータ全体の統計的な関連を表す指標であるのに対し、SHAPは学習済みモデルの個々の予測に対する特徴量の貢献度を表す指標。
相関とSHAPの違い
相関係数とSHAPは、どちらも変数と結果の関係を数値化する指標だが、何に基づいて計算されるかが異なる。
- 相関係数
- データの分散・共分散に基づく指標
- モデルを介さず、2変数間の統計的な関連の強さを表す
- データ全体を対象とし、個々のデータ点に対する値ではない
- SHAP
- 学習済みモデルの予測変化量に基づく指標
- 特定のモデルの予測結果を対象とし、モデルなしでは計算できない
- 個々のデータ点(1件の予測)ごとに値が出る
相関係数はデータそのものの関係を、SHAPは学習済みモデルがその関係をどう使っているかを表す、という違いがある。
相関と因果の違い
- 相関関係(Correlation)
- $X$が大きい(小さい)ほど$Y$も大きい(小さい)という、両者が連動する関係
- $X$と$Y$のどちらが原因でどちらが結果かは問わない、対称的な関係
- 因果関係(Causality)
- $X$の変化や差によって$Y$の変化や差が生じるという、一方向の関係
相関関係があるからといって、必ずしも因果関係があるとは限らない。
見せかけの相関(Spurious correlation)
- 見せかけの相関(Spurious correlation)
- 2つの変数の間に直接の因果関係がないにもかかわらず、統計的には相関が観測されてしまう現象
- 交絡因子(Confounding factor)
- 2つの変数の両方に影響を与えることで、見せかけの相関を生み出している別の要因
例えば、「アイスクリームの売り上げ」と「水難事故の件数」には正の相関があるが、アイスクリームが水難事故を引き起こしているわけではない。実際には「気温が高い」という共通の原因が、両方を同時に押し上げているだけである。相関関係を見つけたときは、両者を同時に動かしている交絡因子がないかを疑う必要がある。
因果関係の3条件
$X$が$Y$の原因であると言うためには、次の3条件をすべて満たす必要がある。
- 時間的先行性(Temporal precedence)
- 原因となる$X$の変化が、結果となる$Y$の変化より時間的に先に起きていること
- 共変関係(Covariation)
- $X$が変動すると、それに伴って$Y$も変動すること(相関関係があること)
- 他の説明の排除(No confounding)
- $X$と$Y$の両方に影響を与えるような別の要因(交絡因子)が存在しないか、その影響が取り除かれていること
3つ目の条件が特に満たしにくく、交絡因子を完全に排除できたと言い切るのは難しい。そこで、次に説明するランダム化比較試験のような手法で、この条件を実験的に近づけるアプローチが取られる。
単回帰分析(Simple regression)
- 1つの量的データ$x$から、別の量的データ$y$を予測する直線を求める方法
- 求める直線は次のような式で表される
- $a$は切片、$b$は傾き
- データ全体と直線とのズレ(残差、Residual)の2乗和が最小になるように、$a$と$b$を決める方法を最小二乗法(Least squares method)と呼ぶ
- 回帰分析はあくまで相関関係の延長にすぎず、$x$が$y$の原因であることまでは保証しない
因果推論(Causal inference)
相関だけでは因果関係を主張できないので、因果関係そのものを調べるための手法もある。
処理群と対照群
- 処理群(Treatment group)
- 調べたい処理・介入を受けるグループ。介入群(Intervention group)、実験群(Experimental group)とも呼ばれる
- 対照群(Control group)
- 処理・介入を受けないグループ。統制群とも呼ばれる。比較の基準(ベースライン)として使う
- 対照群を置く理由は、処理群だけを観察しても、変化が処理によるものなのか、放っておいても起きていた変化(自然治癒、平均への回帰、時間経過による変化など)なのかを区別できないから
- 対照群と比較して初めて、「処理を受けたグループと受けなかったグループの差」として、処理の効果を切り出せる
- 2つの群は、処理の有無以外のあらゆる点でできるだけ似ている必要がある。ここで群分けに偏りがあると、処理の効果なのか元々の group差なのかが区別できなくなる。この偏りを避けるための代表的な方法が、後述のランダム化比較試験
医薬品の臨床試験では、対照群の扱いにもう一工夫加えることが多い。
- プラセボ(Placebo、偽薬)
- 対照群に、有効成分を含まない見た目だけそっくりな薬を与えること
- 「治療を受けている」という期待感自体が症状を改善させてしまうプラセボ効果を、処理群・対照群の両方に等しく発生させ、相殺するのが狙い
- 盲検化(Blinding)
- 被験者が自分がどちらの群か分からないようにする単盲検(single-blind)
- 被験者だけでなく、評価する研究者側もどちらの群か分からないようにする二重盲検(double-blind)
- どちらも、期待や思い込みが結果の判定に影響するのを防ぐための工夫
ランダム化比較試験(RCT)
- 前述の「観察研究と実験研究」で触れた実験研究の代表例
- 対象を処理群と対照群にランダムに振り分けて、結果を比較する方法
- ランダムに振り分けることで、年齢や生活習慣などのあらゆる交絡因子が、平均的には両群で同じくらいになることが期待できる
- 交絡因子を意図的にそろえるのではなく、ランダム化によって「均等にばらけさせる」のがポイント
- 新薬の効果を調べる臨床試験などで使われる代表的な方法
操作変数法(Instrumental variable method)
- RCTのようにランダムな割り付けができない場面で、因果関係に迫るための手法の1つ
- 「結果には直接影響しないが、原因となる変数にだけ影響する」ような第三の変数(操作変数)を探し、それを手がかりに間接的に因果効果を推定する
- 適切な操作変数を見つけること自体が難しく、実務ではここが一番の勘所になる
その他
月はカテゴリカル変数
- 1月〜12月を「月の区分」として扱う場合はカテゴリカル変数
- 月は周期的で、12月と1月は隣り合っているため、単純な数値として扱うのは適切でないことが多い
- 一方、「2024年1月 => 2024年2月 => …」のように時間の経過を表す場合は、年月を量的変数として扱える
- つまり、月がややこしい理由は月が2つの意味を持つから
- 3月 = March(時点・カテゴリ) => カテゴリカル変数
- 3か月 = 3 months(期間・量) => 量的変数
- まあ、「郵便番号」は数字だけど、カテゴリカル変数というのと同じ
クロス集計表の切り方
クロス表の分母も結構間違えがち。
例: ワクチンの有効性を説明するにはどう比較すればいいか?
| - | 感染した | 感染しなかった | 合計 |
|---|---|---|---|
| ワクチン未接種 | 100人 | 900人 | 1000人 |
| ワクチン接種済み | 450人 | 8550人 | 9000人 |
| 合計 | 550人 | 9450人 | 10000人 |
2つの見方がある。
| 見方 | 計算 | 何がわかる? |
|---|---|---|
| A | (100/550)、(450/550) | 感染した人の中で、接種・未接種がどれくらいいるか |
| B | (100/1000)、(450/9000) | 接種した人・していない人の中で、どれくらい感染したか |
- この場合は、適切なのは、AではなくBとなる
- 理由は、Aだと、そもそも論、ワクチン接種者の方が多い可能性があり、ワクチン自体の有効性を示せないから
- Bはワクチンを摂取した人の中で、という事になっている
言い換えると次になる:
- A: 感染者のワクチンを接種したしていない人の“確率”を見る
- B: ワクチンを接種した人と接種していない人の感染する“確率”を見る
Aだと、何人ワクチンを接種していたのかが加味されていないため、ワクチンの有効性を示す上では不適切ということ。
まとめ
- 記述統計(データを要約する)と推測統計(母集団を推測する)の違いを整理した
- PPDACサイクルで統計の進め方を、観察研究と実験研究で研究デザインの選び方を整理した。実験研究をさらに体系化した実験計画法(無作為化・反復・局所管理、要因計画)にも触れた
- データの尺度水準・代表値・散らばりの指標など、データを正しく要約するための基本用語をまとめた
- 分布の形やばらつきを整えるための変数変換(対数変換・平方根変換・ロジット変換・Box-Cox変換)も整理した
- 推定・仮説検定・カイ二乗検定・感度特異度など、標本から判断を下すための道具を確認した。多くの検定が前提とする正規性・等分散性と、その確認方法・対処法も整理した
- 共分散(2変数が同じ方向に動くかを表す指標)を単位に依存しない形に正規化したものが相関係数、という関係も整理した
- 相関係数がデータの分散・共分散に基づく指標であるのに対し、SHAPは学習済みモデルの予測変化量に基づく指標であるという違いも整理した
- 相関と回帰、因果推論についても、相関と因果を混同しないことを軸にまとめた
- どの道具も「何のためにその計算をしているのか」を見失うと使い方を誤りやすいので、目的に立ち返って使うことを意識したい
参考文献
- Tableau – 箱ひげ図(ボックス プロット)の作り方 | ST-Brain
- 「統計の入門」イントロダクションPDF
- 統計学と機械学習、「二つの接点」とは - Speaker Deck
- JIS Z 8101-1:2015 統計―用語及び記号―第1部:一般統計用語及び確率で用いられる用語
- JIS Z 8101-2:2015 統計―用語及び記号―第2部:統計の応用
- JISZ8101-3:2006 統計-用語と記号-第3部:実験計画法
- Lundberg, S.M., Lee, S. (2017). “A Unified Approach to Interpreting Model Predictions.” NeurIPS 2017. arXiv:1705.07874