目次
背景
- Interpretable Machine Learningについて気になって調べた事のまとめ
- 次の記事が特に参考になった
- 機械学習では、Ablationなどは時々するが、SHAP値について理解していなかったの
- そこで、Permutation Importance、Ablation、SHAP、Partial Dependence Plotについて調べたログ
Permutation Importance
考え方
- ある特徴量の値をランダムにシャッフルし、モデルの予測精度がどれだけ悪化するかを見ることで、その特徴量の重要度を測る
- シャッフルしても精度がほとんど落ちないなら、その特徴量はモデルにとって重要ではない
- モデルの再学習は不要で、学習済みモデルに対してすぐに計算できるのが利点
重要度の2つの定義
シャッフル前後の誤差を比較する方法には、次の2つがある:
- 比($e_{perm}/e_{orig}$)
- 差($e_{perm}-e_{orig}$)
どちらも「シャッフルでどれだけ誤差が悪化したか」を表す点は同じで、どちらを使うかは慣習や実装によって異なる。
概念フロー
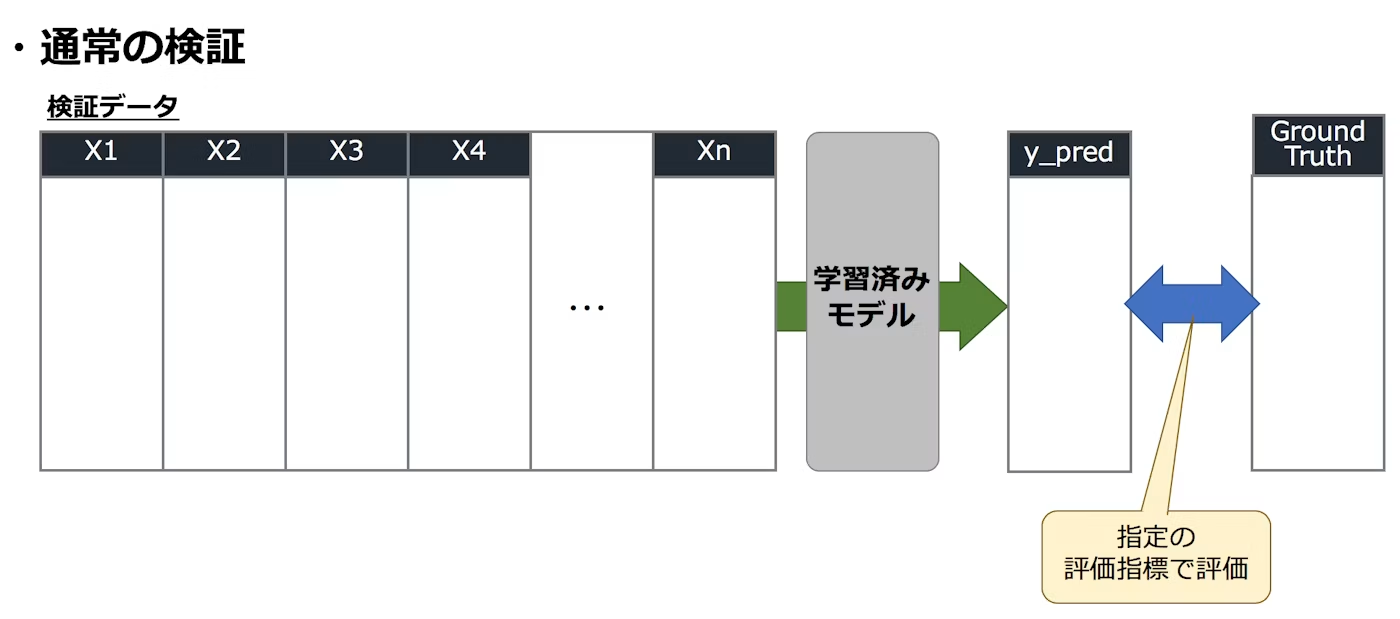
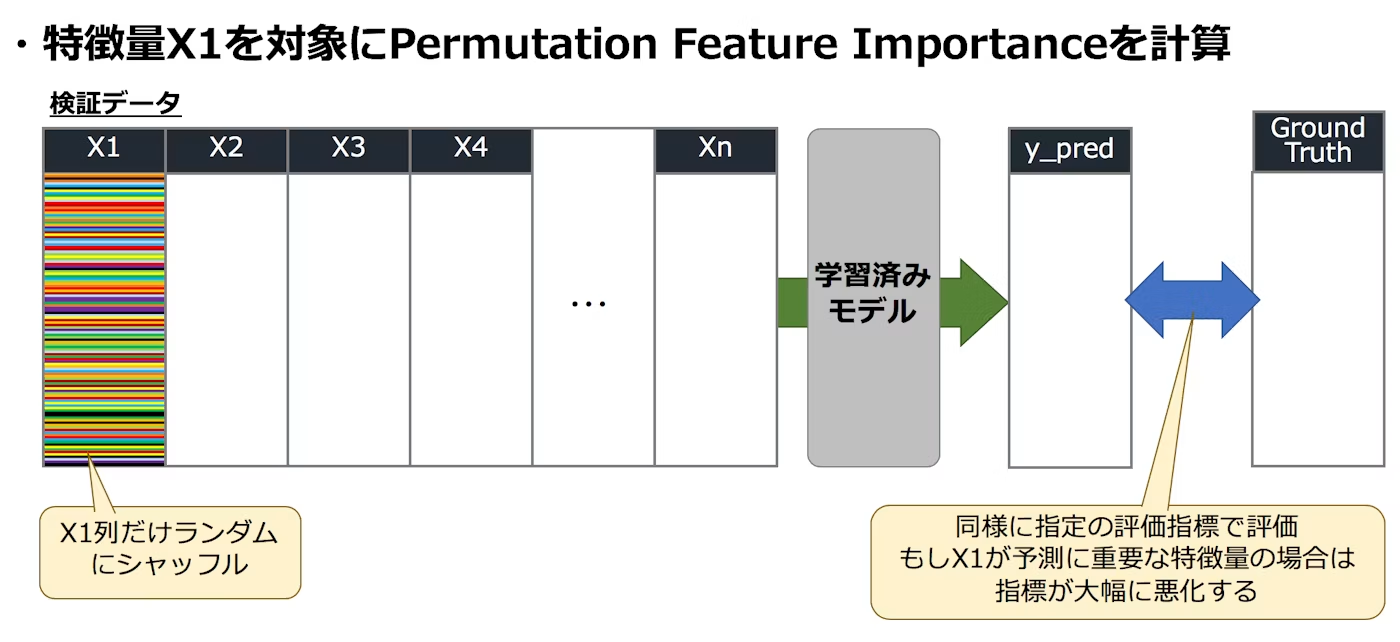
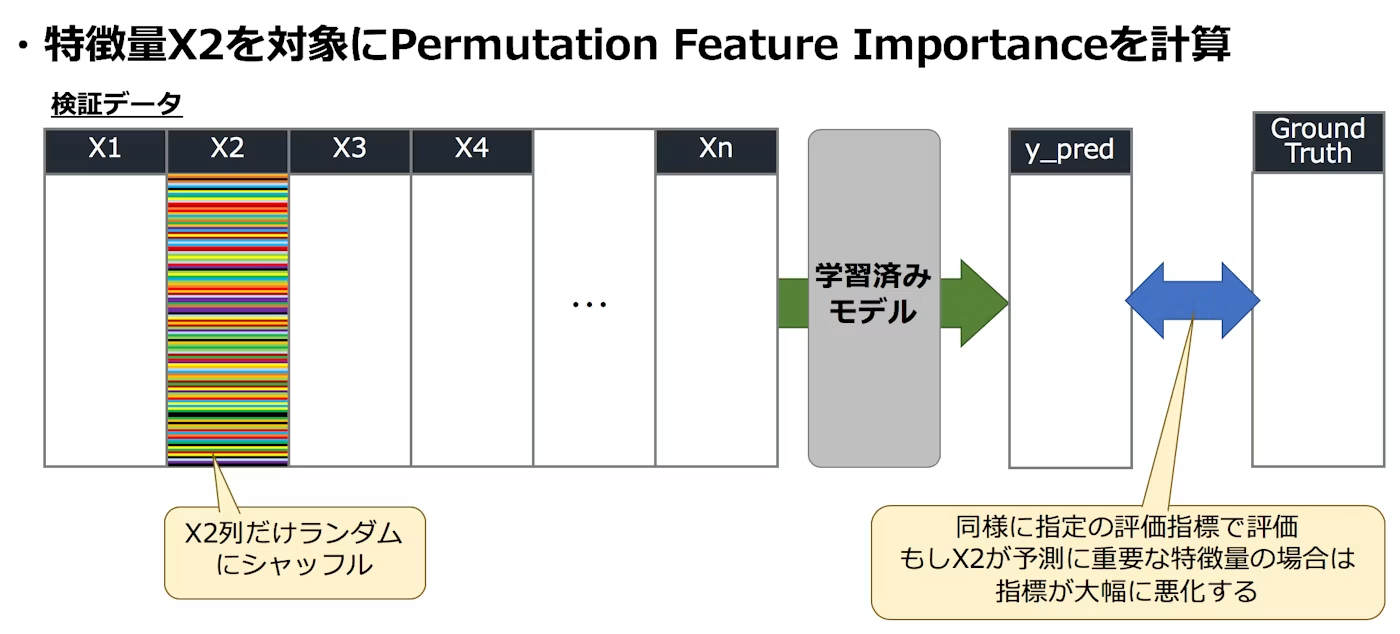
この画像が1番わかりやすかった。
- 通常の検証
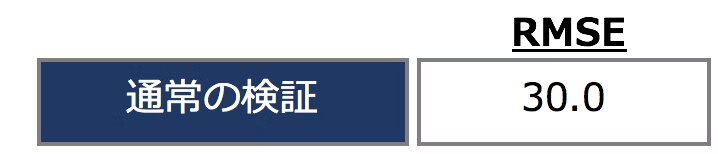
- 通常の検証結果
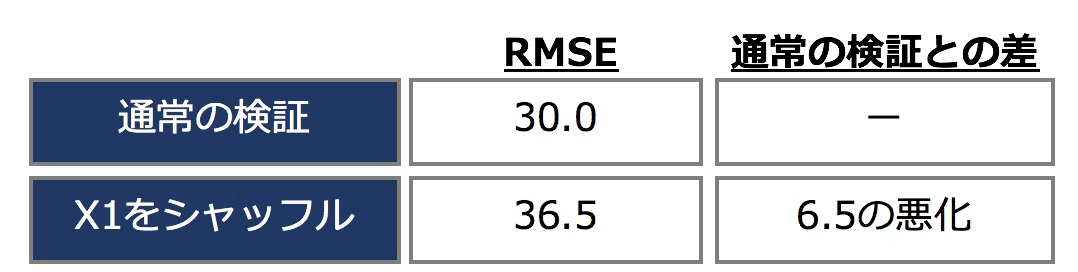
- X1だけシャッフル検証
- X1だけシャッフル検証の結果
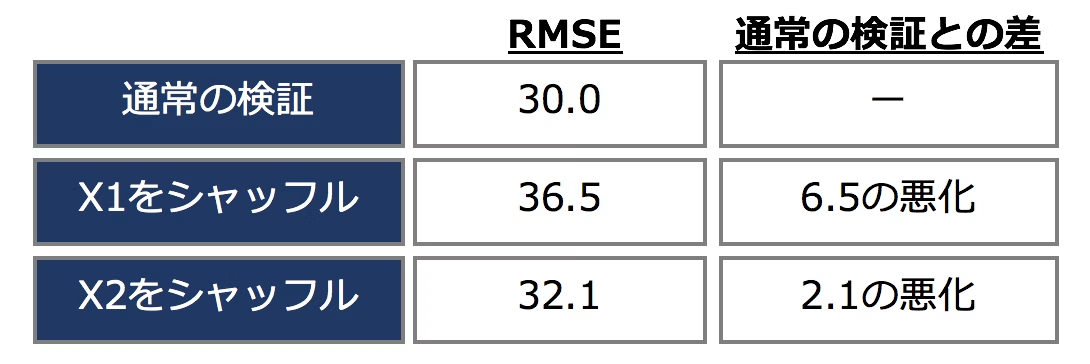
- X2だけシャッフル検証
- X2だけシャッフル検証の結果
- 最終的なまとめ
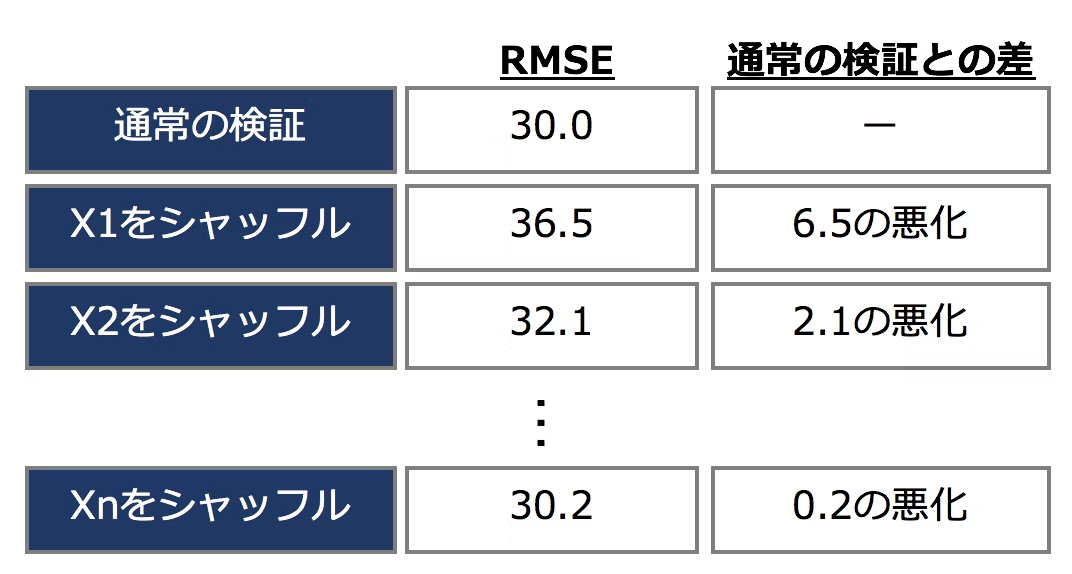
画像の通り、特徴ごとにバラバラにした時の性能の低下を測る方法
注意点
相関・交互作用による過小評価
- 2つの特徴量が強く相関している場合、片方をシャッフルしても、モデルはもう片方から同じ情報を得られるため、性能はほとんど落ちない
- 結果として、実際には重要なペアの特徴量それぞれが「重要度が低い」と判定されてしまう、過小評価が起こりうる
- さらにPermutation Importance特有の問題として、片方だけをシャッフルすると、非現実的な組み合わせが評価に使われてしまい、結果自体が歪む可能性もある
- 学習時には存在しなかった「シャッフルされたA×実際のB」という特徴が生まれるから
- これは単純に1つの特徴量を抜く・崩すという操作全般に共通する、よく知られた弱点
相関特徴量を追加すると重要度が分散する
- 過小評価とは逆方向の、もう一つの相関がらみの落とし穴がある
- ある特徴量が最も重要だったとしても、それと強く相関する特徴量を新たに追加すると、両者の間で重要度が「分け合われ」、どちらも中程度の重要度に下がって見えることがある
- 例えば、気温という特徴量が最も重要だったとして、それと相関する別時刻の気温を追加すると、両方とも重要度が下がり、上位から気温そのものが外れてしまうことがある
- 実務上、上位の重要な特徴量だけを見て測定誤差などをチェックする運用をしていると、この分散によって本来チェックすべき特徴量を見逃す恐れがある
Ablation
Ablationとは
- 機械学習の Ablation(切除実験)とは、モデルの一部を取り除いたり変更したりして、その要素が性能にどれだけ貢献しているかを調べる方法
- たとえば、モデルが以下の要素で構成されている時、以下などを行い学習モデルを作り精度の劣化を検証する
- データ拡張
- Attention機構
- 特別な損失関数
- イメージ的にはモデルの構造の削減などで使われるイメージ
- 例えば、2つのエンコーダーを組み合わせている時に、片方ずつ削って性能をチェックするなど
- 一言でいうと、「その部品を外したら、モデルがどれだけ困るか」を調べる実験
Permutation ImportanceとAblationの違い
違い:
- Permutaion Importance:
- 推論(特徴シャッフルして)して行う
- 特徴をシャッフルして検証するイメージ
- Ablation:
- 学習時に行う
- 構造(部品)を削減して検証するイメージ
Partial Dependence Plot(PDP)
考え方
- ある1つの特徴量の値を意図的に動かしながら、他の特徴量は実際のデータの値のまま固定し、モデルの予測がどう変化するかを平均的に見る手法
- Permutation Importanceが「重要かどうか」を教えるのに対し、PDPは「どのように影響するか」という形状を教えてくれる
概念フロー
対象の特徴量$x_S$を変化させ、それ以外の特徴量$x_C$について平均を取る。
$$ \hat{f}_S(x_S) = \frac{1}{n} \sum_{i=1}^{n} \hat{f}(x_S, x_C^{(i)}) $$これらの画像がわかりやすかった。
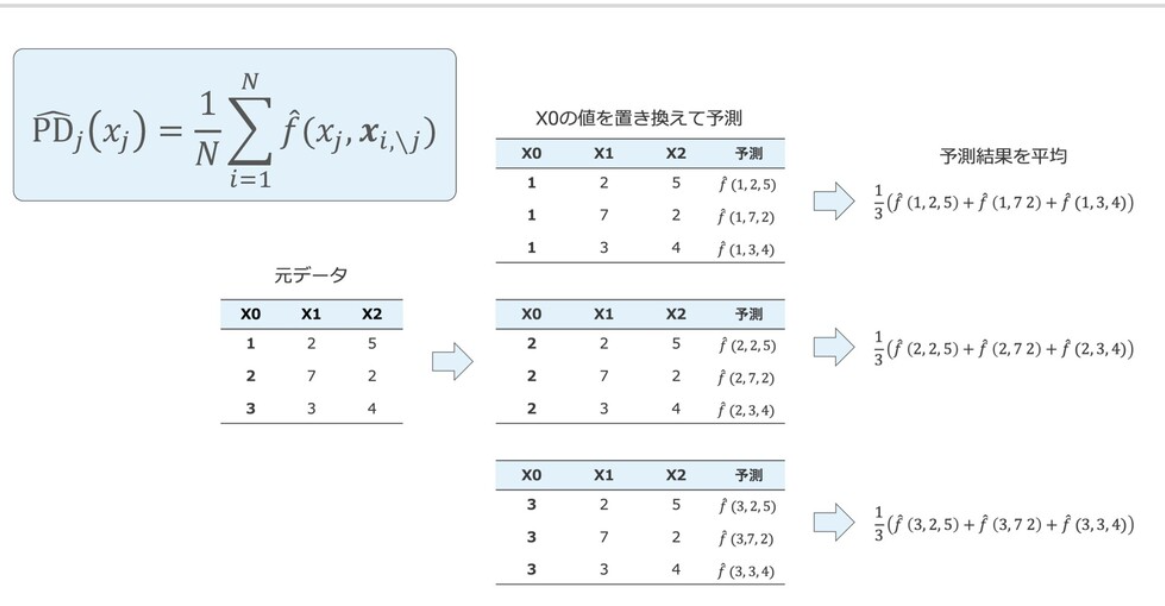
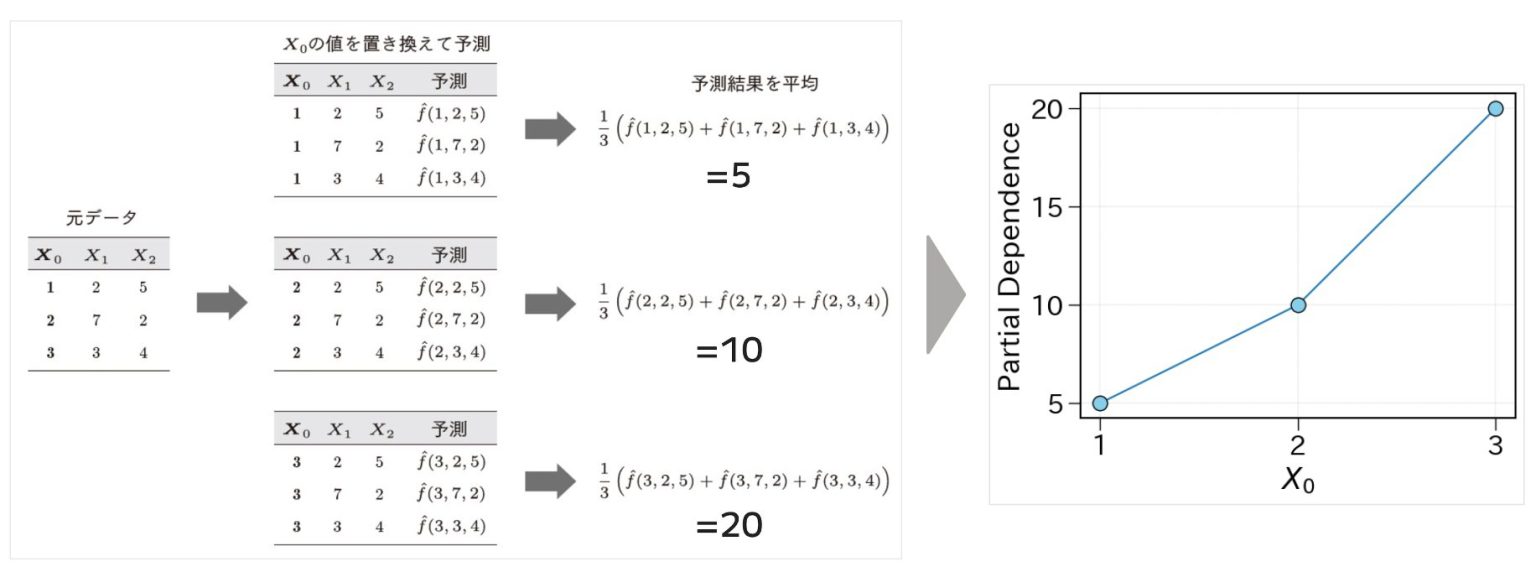
- 軸
- 横軸:対象となる特徴量の値
- 縦軸:モデルの平均予測値
- 変化量の関係
- 上昇:特徴量が大きくなるほど予測値が上がる傾向
- 下降:予測値が下がる傾向
- 曲線:非線形な影響
PDPの等高線
- 1つの特徴量についてのPDPだけでなく、2つの特徴量を同時に動かした2次元のPDP(等高線プロット)を使うと、2つの特徴量間の交互作用を視覚的に確認できる
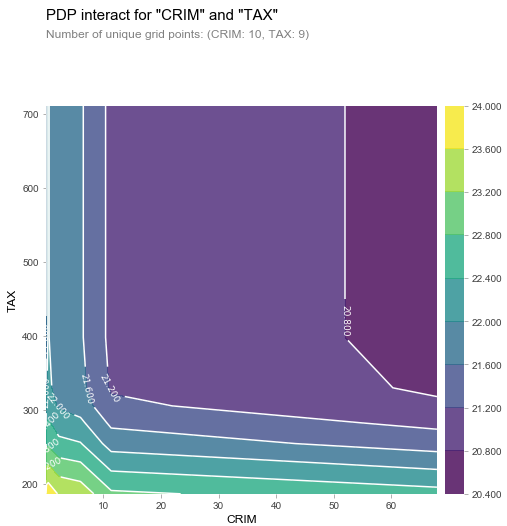
- 上図はScikitLearnのボストン住宅価格データセットでのPDPの等高線
- 軸
- 横軸 CRIM:町ごとの人口当たり犯罪率
- 縦軸 TAX:固定資産税率(その地域で不動産価値に対して何%課税するかという税率)
- 等高線の色の意味
- 薄い(黄色っぽい): 住宅価格が高い
- 濃い(紫っぽい): 住宅価格が安い
- わかること
- 固定資産税率が350を超えたあたりから住宅価格にあまり影響がなくなっている
- 当然だが、どのTaxを固定しても、犯罪率が高いところよりも低いところの方が住宅価格が高い
具体例: 位置特徴量のU字形PDP
- 乗車地点の経度についてPDPを描くと、U字型の形状になった
- これは、都市の中心から東西どちらに離れても、移動距離自体が長くなりやすいという、地理的な構造を反映していると考えられる
- 同じ理由で、他の位置特徴量についても同様の形状が予想でき、実際に確認するとおおむね一致していた
注意点
急な傾きについて
- 2つの特徴量のうち、PDPの傾きが急な方が必ずしもPermutation Importanceが高いとは限らない
- Permutation Importanceは、PDPの傾き(感度)だけでなく、その特徴量が実際のデータの中でどれだけ変動しているか(分散)にも左右されるため
- 逆に、ある特徴量のPDPがほぼ平坦(=平均的には予測に影響しないように見える)であっても、その特徴量が別の特徴量との交互作用を通じて強く予測に影響し、結果としてPermutation Importanceが高くなるケースもありうる
相関がある場合の問題
- PDPは「関心のある特徴量以外は実データの値のまま」として計算するため、特徴量同士に相関がある場合、現実には存在しない組み合わせを平均に含めてしまう
- 例えば、身長と体重に強い相関があるデータで身長200cmのPDPを計算すると、体重の周辺分布全体(50kg以下のような、2mの人にはまずありえない値も含む)を平均してしまう
- この場合のPDPは、実際には起こりえない仮想的な人物像に対する予測を含んだ、信頼性の低いものになる
- 解決策として、周辺分布の代わりに条件付き分布を使うALE(Accumulated Local Effects)プロットが提案されている
不均一な効果が相殺される問題
- PDPは全データ点の予測を平均するため、ある特徴量がデータの半分では予測を押し上げ、残り半分では押し下げるという不均一な効果を持つ場合、平均するとちょうど打ち消し合い、「この特徴量は影響が無い」ように見えてしまうことがある
- 実際には強い効果があるのに、平均によって隠れてしまうという意味で、PDPだけを見て「影響が無い」と判断するのは危険
- 個々のデータ点ごとの予測変化を1本ずつ描くICE(Individual Conditional Expectation)曲線を併用すると、こうした平均に隠れた不均一性を確認できる
SHAP
ゲーム理論のShapley値
Shapley値とは
- Shapley値は、ゲーム理論でいう「みんなで作った成果を、各参加者の貢献度に応じて公平に分配する方法」
- たとえば3人 A・B・C が協力して100万円の利益を生んだとする
- でも、A単独では10万円、B単独では20万円、AとBなら60万円のように、「誰と組むか」で価値が変わることがある
- そこでShapley値では、各人がチームに参加する順番を全部考える
- そして、「その人が参加した瞬間に、チーム全体の価値をどれだけ増やしたか」を計算し、あらゆる参加順序について平均する
価値の計算例
以下は「Aが加わることで、どれだけ価値が増えたか」を表す。
$$ v(\{A\})-v(\emptyset) $$これを分解すると:
- $v$ :「そのメンバー構成で得られる価値」を返す関数
- $\{A\}$ :Aだけがいるチーム
- $\emptyset$ :誰もいないチーム
- $v(\{A\})$ :Aだけで作れる価値
- $v(\emptyset)$ :誰もいないときの価値
Shapley値の計算フロー
たとえば A → B → C という順なら、Aの貢献は
$$ v(\{A\})-v(\emptyset) $$Bの貢献は
$$ v(\{A,B\})-v(\{A\}) $$Cの貢献は
$$ v(\{A,B,C\})-v(\{A,B\}) $$順番を B→C→A、C→A→B……と全部変えて、それぞれの人の「追加した価値」を平均したものがShapley値。
数式では、プレイヤー $i$ のShapley値は以下となる。
$$ \phi_i = \sum_{S\subseteq N\setminus\{i\}} \frac{|S|!(n-|S|-1)!}{n!} \left[ v(S\cup\{i\})-v(S) \right] $$ただし本質は式より、「その人が、いろいろな状況で参加したときに追加する価値を平均する」と覚えるとかなり分かりやすい。
SHAPにおけるShapley値
SHAPはこの考え方を機械学習に持ち込んだもの。
- ゲームの「プレイヤー」
- 特徴量
- チームの価値
- モデルの予測値
- Shapley値
- 各特徴量が予測にどれだけ貢献したか
という対応。
考え方
- SHAP(SHapley Additive exPlanations)
- ゲーム理論のShapley値を応用し、個々の予測に対して各特徴量がどれだけ・どちらの方向に寄与したかを分解する手法
- ベースライン(何も情報が無い場合の期待予測値)に、各特徴量のSHAP値を足し合わせると、実際の予測値に一致するという性質を持つ
- $f(x)$:データ$x$に対するモデルの予測値
- $\phi_0$:ベースライン。背景データに対するモデル出力の期待値
- $\phi_i$:特徴量$i$のSHAP値
- $M$:特徴量の数
Permutation ImportanceやPDPがモデル全体の傾向(model-level)を見るのに対し、SHAP値は個別の予測(prediction-level)を説明する点が異なる。
IRISでのSHAPの例
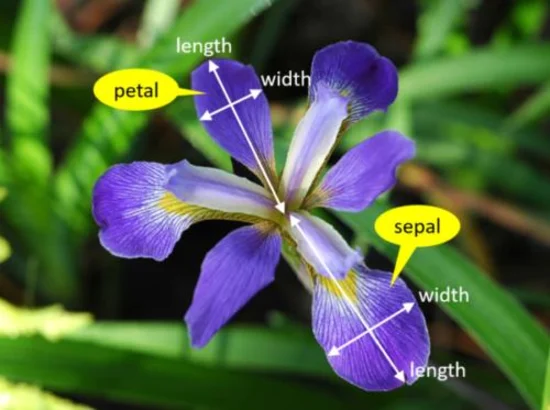
IRISデータセットについて
IRISのターゲットは、アヤメの品種の分類に関するデータセット。
ターゲットクラス:
| クラス | 品種 |
|---|---|
| 0 | setosa |
| 1 | versicolor |
| 2 | virginica |
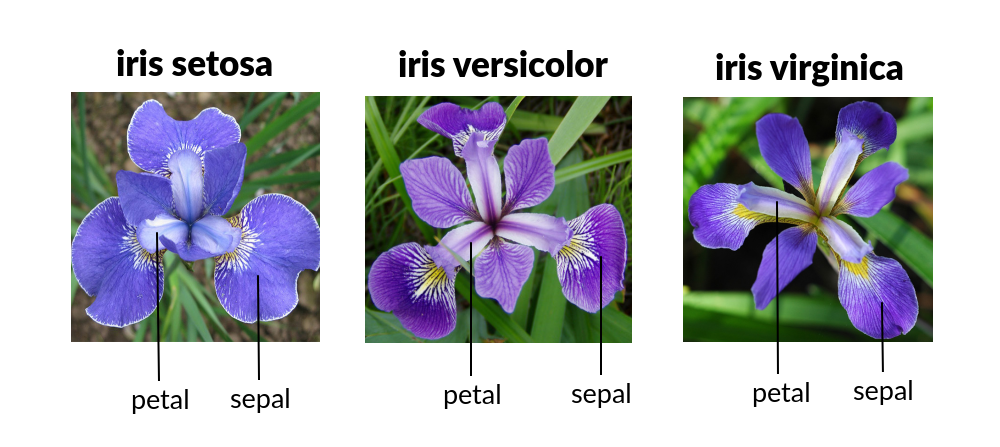
特徴:
- Sepal.Length(がく片の長さ)
- Sepal.Width(がく片の幅)
- Petal.Length(花弁の長さ)
- Petal.Width(花弁の幅)
Waterfall plot
この画像はデータセットの中の一つの実サンプルに対する分析結果の画像。
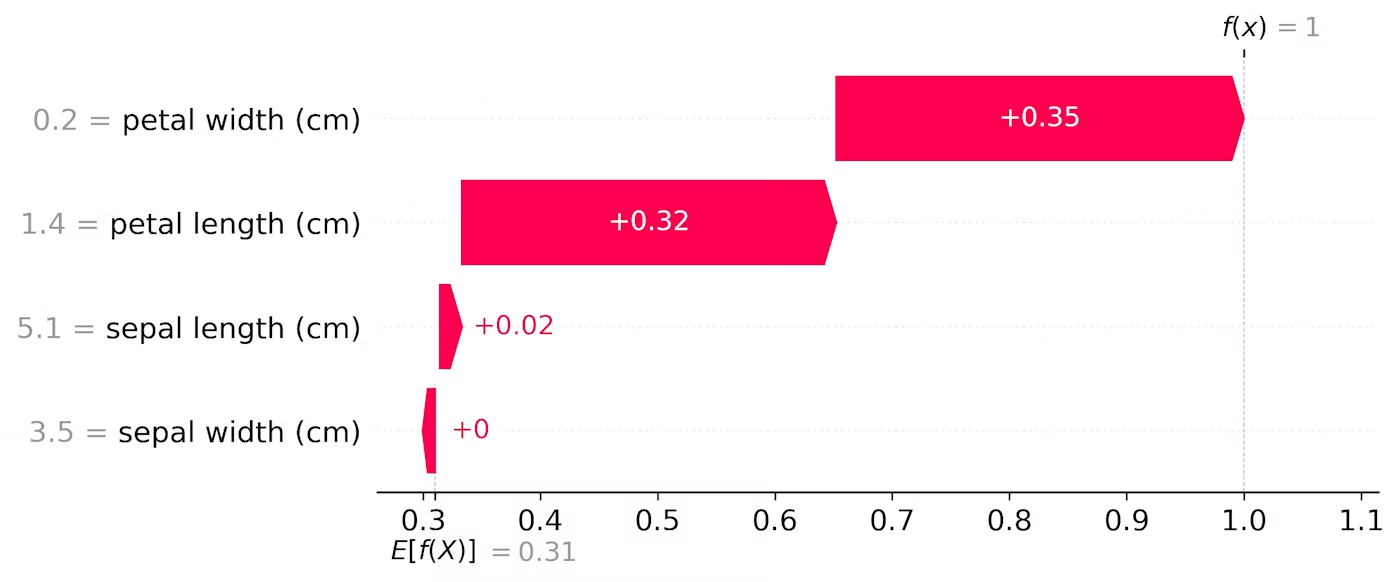
- $E[f(X)] = 0.31$が何も個別情報を見ていないときのモデルの平均的な出力結果(ベースライン)
- また、0.2 や 1.4などは元データの実測値
それぞれの特徴量は以下となっている。
| 特徴量 | 入力値 | SHAP値(予測への寄与) |
|---|---|---|
| sepal width | 3.5 | 約 +0 |
| sepal length | 5.1 | +0.02 |
| petal length | 1.4 | +0.32 |
| petal width | 0.2 | +0.35 |
そして積み上げて1となっている。
$$ 0.31 + 0 + 0.02 + 0.32 + 0.35 \approx 1.00 = f(x) $$この図で最も重要なのは:
- petal width(花びらの幅)と petal length(花びらの長さ)が、この予測を大きく押し上げていること
- 逆に、sepal lengthやsepal width はほぼ予測に影響していないこと
Bar Plot
この画像はターゲットクラスへのマクロでの分析結果の画像。
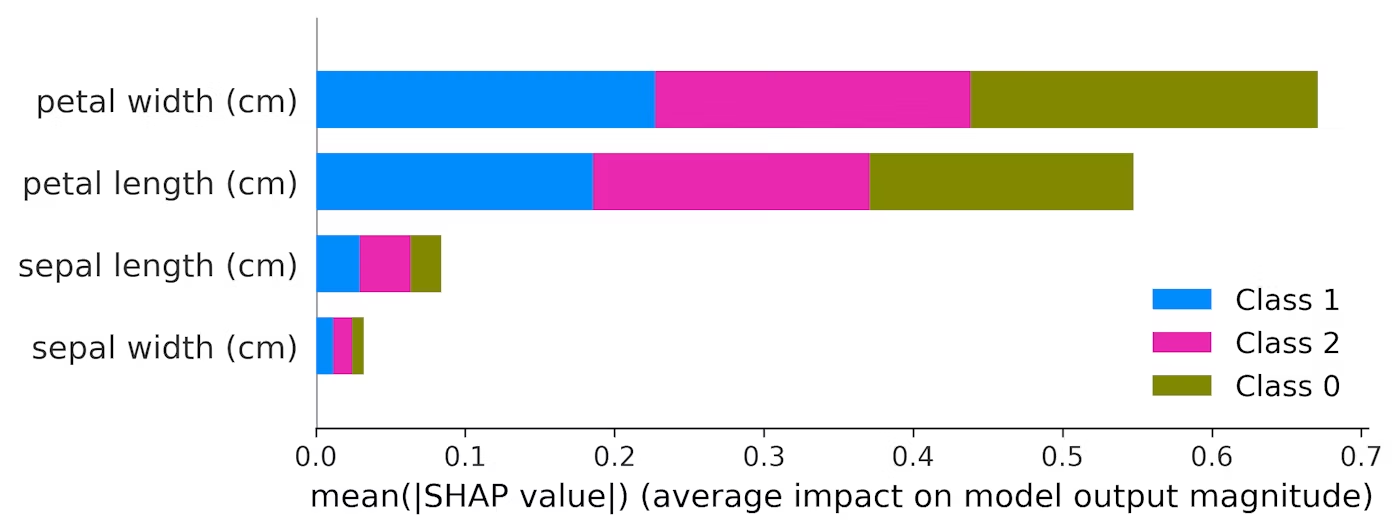
わかること:
- petal lengthとpetal widthは非常に大きい影響力を持っている
- sepal widthとsepal lengthは影響力が小さいこと
結果、先程と同じように、petal lengthとpetal widthが分類に重要な特徴量とわかる。
Summary Plot
- 3つのクラスごとの特徴量の寄与についてのグラフ
- 特徴量の多寡によってどれだけ分類に寄与したかを表している
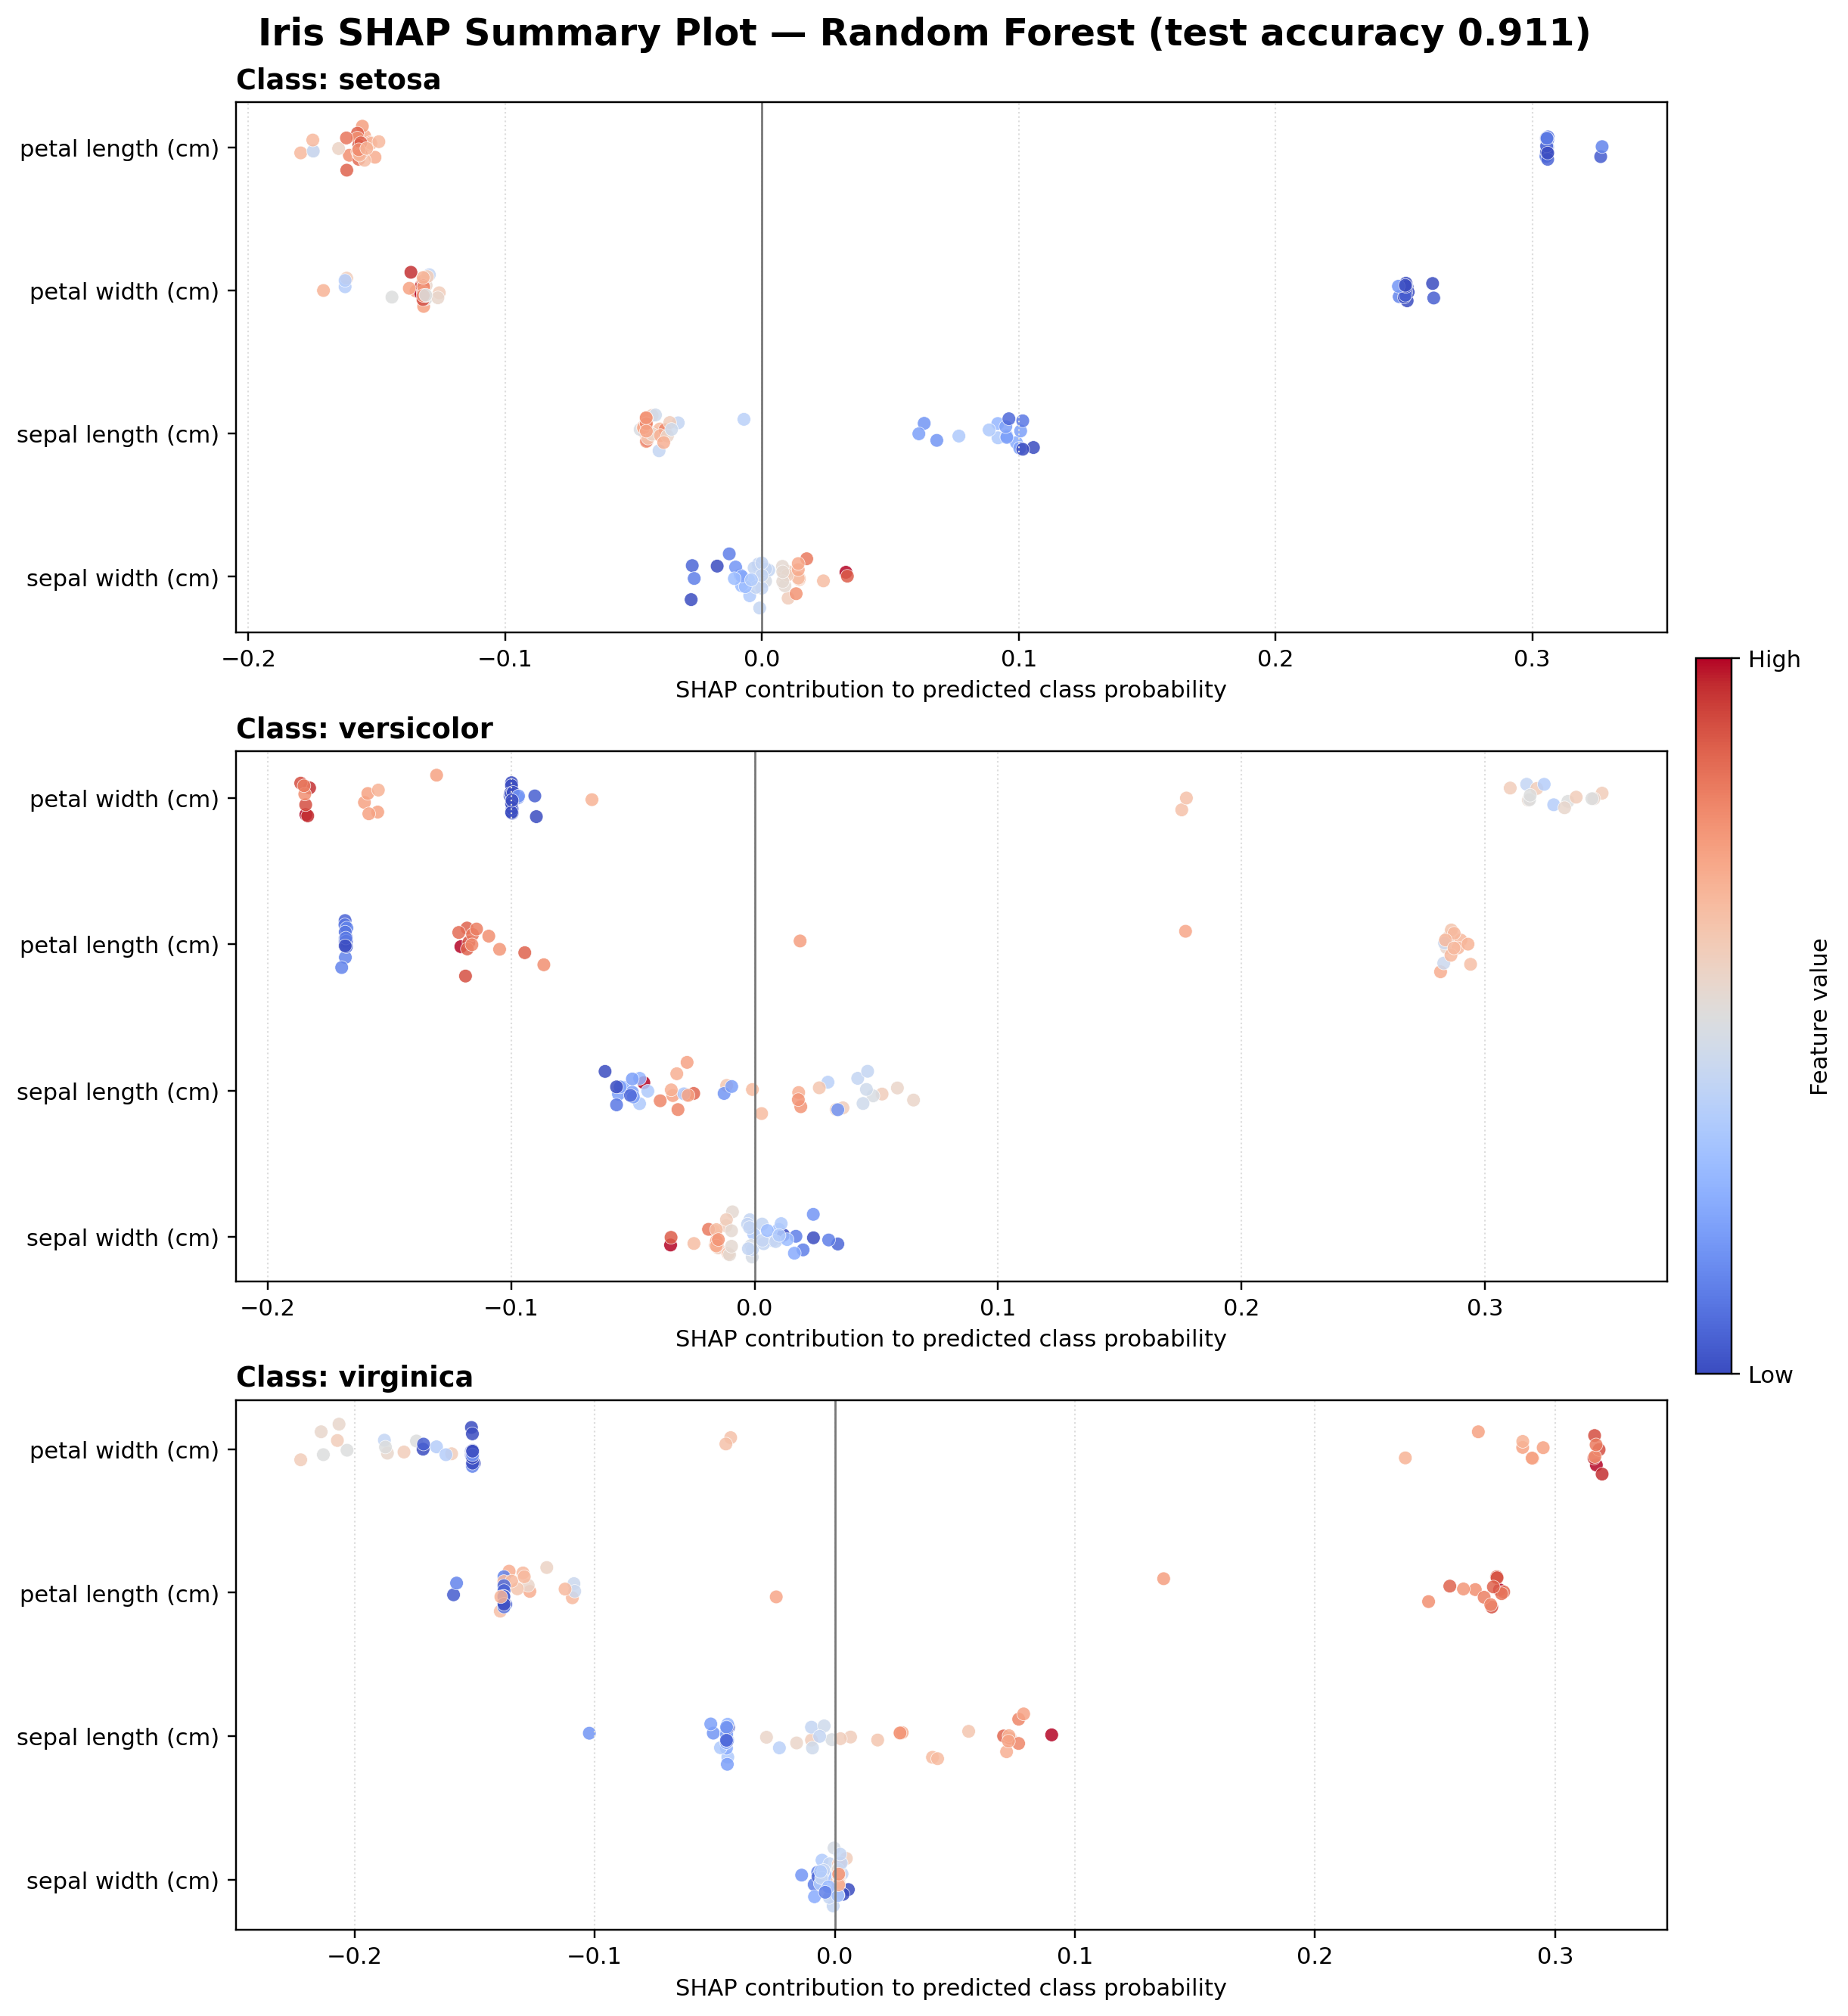
- Plotの色
- 特徴量の数値をの大小を表している
- その特徴量の中での大小
- 青:小、赤:大
- SHAP Contribution(X軸):
- 寄与の事で、ある特徴量が、そのデータの予測を基準値からどれだけ動かしたかの数値
- 0から離れているほど、その予測への影響が強いという意味
3クラスとも、分類を大きく左右しているのは次の2つ:
- petal length(花弁の長さ)
- petal width(花弁の幅)
わかること:
- setosaは花弁が小さいほど予測されやすい:
- setosaでは、petal lengthとpetal widthの小さい値(青)が、正のSHAP値に集中している
- つまり、花弁が短く細いほど、モデルはsetosaだと判断しやすい
- という関係がある
Dependence Contribution Plot
Dependence Contribution Plotでは、各特徴量の値が変化したときに、各クラスの予測へどの程度プラス/マイナスに寄与するかを確認できる。
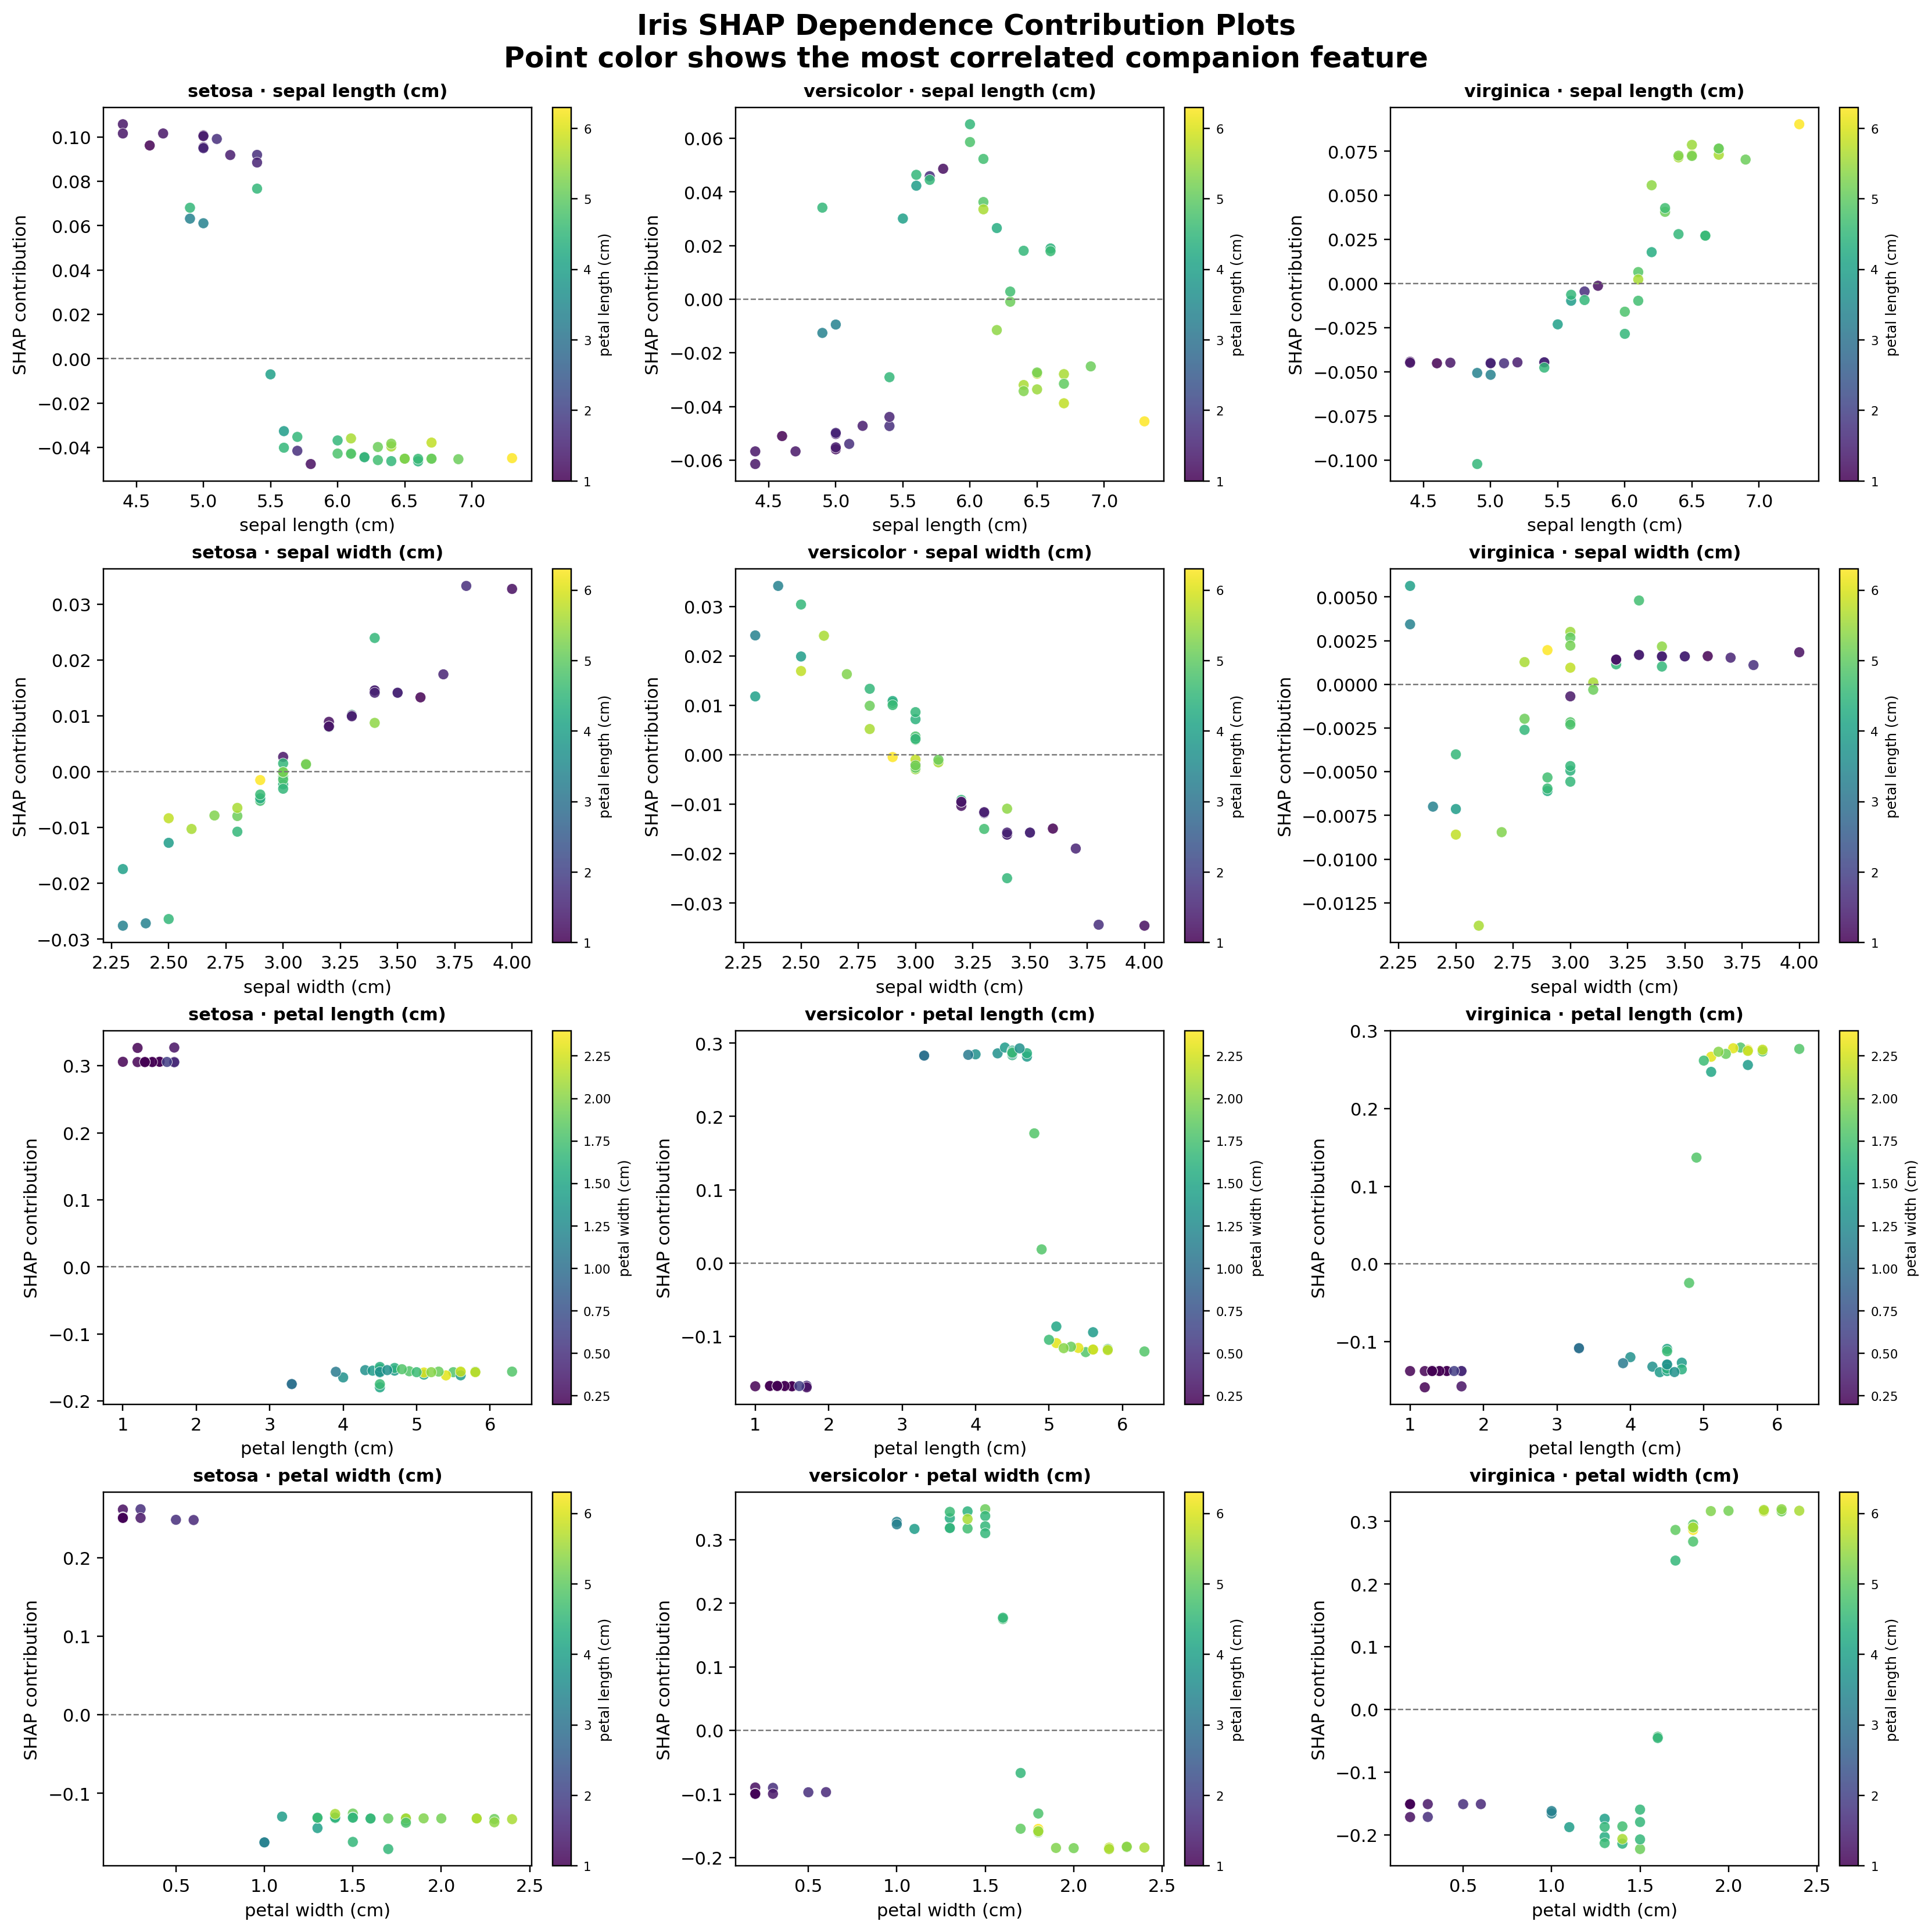
- setosa:花弁に明確な境界がある
- petal lengthでは、おおむね次の傾向がある
- 約2cm以下:setosaの予測を大きく押し上げる
- 約3cm以上:setosaの予測を下げる
- petal widthも同様に、以下となっている
- 約0.6cm以下:強いプラス寄与
- 約1cm以上:マイナス寄与
- Random Forestらしい階段状の変化で、花弁の大きさに明確な判定境界があることが分かる
- petal lengthでは、おおむね次の傾向がある
KernelSHAPとTreeSHAP
SHAP値の理論はモデルの種類によらず定義できるが、実際の計算方法はいくつかあり、それぞれ長所と弱点が異なる。
- KernelSHAP:
- モデルの種類を問わない汎用的な計算方法
- 特徴量の組み合わせ(連合)をサンプリングし、周辺分布から値を補完しながら重み付き線形回帰でSHAP値を推定する
- 汎用的な一方、計算に時間がかかる
- 周辺分布からサンプリングするため、特徴量間の依存関係(相関)を無視してしまい、PDPと同様に非現実的な組み合わせを評価に含めてしまう可能性がある
- TreeSHAP:
- 決定木ベースのモデル(ランダムフォレスト・勾配ブースティングなど)専用の高速な計算方法
- 周辺分布の代わりに木構造に沿った条件付き期待値を使うため、KernelSHAPより高速かつ特徴量の依存関係も考慮できる
- 一方で、予測に全く影響しない特徴量に対しても、非ゼロのSHAP値を割り当ててしまうことがあるという別の弱点がある
各種法の違い
| 手法 | 問い |
|---|---|
| Permutation Importance | 特徴量と目的変数の関係をシャッフルで壊したら、モデル性能はどれだけ低下するか? |
| Ablation | 特徴量・モデル部品・処理などを取り除いたら、性能はどう変化するか? |
| Partial Dependence Plot | ある特徴量を特定の値にそろえて推論したら、平均予測はどう変化するか? |
| SHAP | ある特徴量が予測に加わったときの限界的な貢献を、さまざまな特徴量の組み合わせについて平均するとどれくらいか? |
まとめ
- Permutation Importanceは「どの特徴量が重要か」を素早く測れるが、「どう重要か」までは教えてくれない
- Permutation ImportanceはAblationの安価な近似であり、いずれの手法も、相関・交互作用のある特徴量の重要度を過小評価しうるという共通の弱点を持つ
- 逆に相関する特徴量を追加すると、重要度が分散して見かけ上下がることもある
- PDPは特徴量ごとの影響の形状を示すが、相関がある場合は非現実的な組み合わせを平均してしまい、不均一な効果は打ち消し合って見えなくなることがある(ALE・ICEが代替・補完手段)
- SHAP値は個々の予測を分解して説明でき、ベースラインとの合計が予測値に一致するという分かりやすい性質を持つ
- 実際の計算方法(KernelSHAP・TreeSHAP)にもそれぞれ異なる弱点がある
参考文献
- Machine Learning Explainability - Kaggle Learn
- Advanced Uses of SHAP Values - Kaggle
- Lundberg, S. & Lee, S. (2017). “A Unified Approach to Interpreting Model Predictions” (arXiv:1705.07874)
- Strobl, C. et al. (2008). “Conditional variable importance for random forests” (BMC Bioinformatics)
- Interpretable Machine Learning
- AIの予測根拠を可視化する:SHAPを使ったモデル解釈・特徴量分析について #XAI - Qiita
- Predicting FIFA Man of the Match
- Permutation Importanceを使って検証データにおける特徴量の有用性を測る #Python - Qiita
- Accumulated Local Effects(ALE)で機械学習モデルを解釈する / TokyoR95 - Speaker Deck
- Partial Dependence Plot: 機械学習モデルを「特徴量と予測値の平均的な関係」から解釈する | Data Driven Knowledgebase
- PDP/ICEを使用した回帰問題の機械学習モデルの大局的解釈方法 - よっしーの私的空間