目次
背景
- X(旧Twitter)で、「なぜ美しいと感じるのか」「なぜジョークは面白いのか」「なぜ好奇心が生まれるのか」を、すべて1つの原理で説明する論文があるというツイートを見た
This paper answers:
why anything is beautiful why jokes are funny why we get curious why you get bored why babies explore why music has hooks
For centuries, we thought these were deeply mystical human traits. Soul-level mysteries that machines could never touch.
But, the paper proves that the human brain operates as a relentless compression engine. It is constantly trying to predict the world and compress it into the smallest possible file size.
Here is how it explains your entire life:
If something is completely predictable, your brain has already compressed it. There is no new data to extract. The result? You feel bored.
If something is pure randomness, your brain cannot compress it at all. The result? You feel annoyed or tune it out.
But then there is the sweet spot.
When you encounter something that seems complex, but suddenly your brain finds the hidden pattern and connects the dots… your brain releases dopamine.
That sudden, glorious rush of successful data compression? That is what you experience as “curiosity.”
When a comedian tells a story that makes no sense, and the punchline suddenly makes all the pieces fit together instantly? That rapid neural compression is what you experience as “humor.”
When you look at a painting and notice an underlying symmetry that ties the chaos together? That is “beauty.”
Art, science, music, and jokes are not magic.
They are just highly optimized data sets designed to trigger compression progress in your neural network.
Here is the most unsettling part.
This paper wasn’t written by a philosopher. It was written by an AI pioneer to figure out how to program intrinsic motivation into artificial agents.
He wasn’t trying to explain humans. He was writing the blueprint for machines.
We always assumed AI could never appreciate art, laugh at a joke, or feel the spark of curiosity.
But if our deepest subjective experiences are just a mathematical reward for maximizing compression progress…
- 元ネタは、Jürgen Schmidhuberの"Driven by Compression Progress: A Simple Principle Explains Essential Aspects of Subjective Beauty, Novelty, Surprise, Interestingness, Attention, Curiosity, Creativity, Art, Science, Music, Jokes"(2008年、arXiv:0812.4360)という論文
- 要するに「脳は圧縮エンジンであり、圧縮がうまくいく瞬間に快を感じる」という説明だが、ツイートの要約だけでは物足りなかったので、論文自体を確認して整理する
- 笑いの仕組みには中学生くらいの頃から関心があった。当時、「他人の失敗で笑いが生まれるのは、その失敗があらかじめ(周囲に)共有されていたからだ」という説明をどこかで読んだことがあり、記憶に残っていた
圧縮進歩とは
- 論文は、観測者(人間でも人工エージェントでもよい)$O$が時刻$t$に持つ圧縮器を使って、あるデータ$D$を符号化するのに必要なビット数を、$D$の「主観的な美しさ」$B(D, O(t))$と定義する
- ビット数が少なくて済む(=短く圧縮できる)ほど、そのデータは美しいとされる
- そのうえで、「興味深さ(interestingness)」を、この美しさの時間微分として定義する
- つまり興味深さとは、データそのものの性質ではなく、「観測者がそのデータをどれだけ速く、うまく圧縮できるようになっているか」という変化率
- 離散的な実装では、圧縮器(プログラム)$p$の性能を、そのプログラム長$l(p)$で測る。これに実行時間のコストを加えた$C_{l\tau} = l(p) + \log \tau$という指標も提案されている
- 圧縮器が改善したときの内発的報酬は、改善前後の符号長の差として定義される
- $f$の最も単純な例は$f(a, b) = a - b$、つまり単純な差分
なぜ退屈でもなく、ランダムでもない、ちょうど良さが面白いのか
- 完全に予測可能なもの(退屈): すでに圧縮しきっているので、これ以上圧縮が進む余地がない。圧縮進歩が0になるため、興味深さも0になる。論文は、暗闇の中で変化のない視覚入力を例に挙げている
- 完全にランダムなもの(ホワイトノイズ): 情報理論的な驚き(Shannon流のサプライズ)は大きいが、アルゴリズム的な規則性が存在しないため、圧縮を改善しようがない。したがって、これも興味深さは生まれない
- 円周率の桁のように、一見ランダムに見えるデータは、実際には短いアルゴリズムで計算できるため、アルゴリズム的には圧縮可能であり、この理論の枠組みでは「ランダムではない」として扱われる
- この両極端のあいだ、つまり「複雑に見えるが、学習によって徐々に規則性が見つかっていく」データこそが、圧縮進歩を生み続け、興味深さ・好奇心を生むとされる
好奇心・美・ユーモア・芸術への当てはめ
- 好奇心: まだ圧縮しきっていない規則性を含むデータを求める衝動として説明される
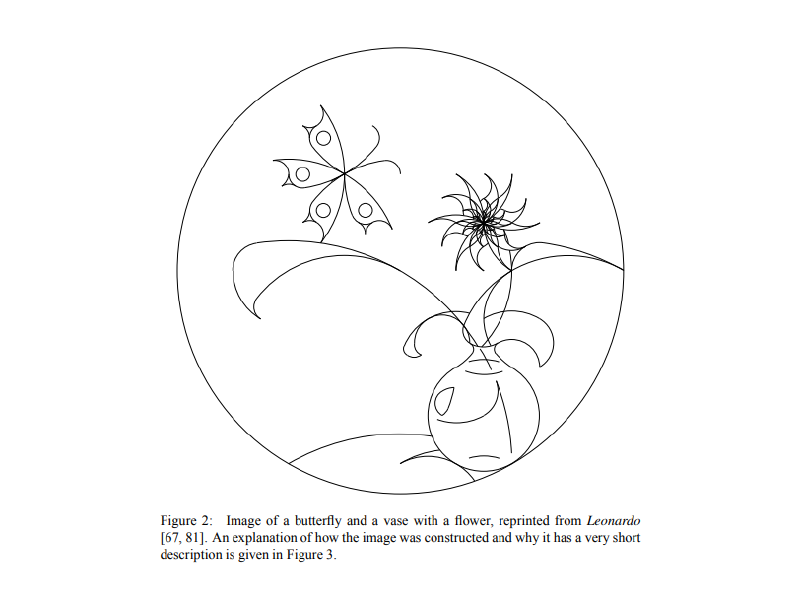
- 美: 既存の符号化方法で、より短く記述できるものほど美しいとされる。例えば、プロトタイプとなる顔からのズレだけで符号化できる顔や、対称性を持つ図形が挙げられている
- ユーモア・喜び: ジャグリングの習得や、ジョークのオチで突然規則性に気づく経験が例として挙げられている。予測や圧縮が急に改善する瞬間に報酬が生じるという説明
- 芸術: 既知の要素を、全体の説明の長さが部分の説明の長さの合計より短くなるように組み合わせる営みとして位置づけられる
- 科学: 重力の法則のように、多数の観測を短いコードでまとめて説明できる新しい規則性の発見として位置づけられる
- 音楽: 完全に予測可能でも、完全に無秩序でもなく、「学習可能な」規則性を含むものが面白いとされる
学習の進歩率と内発的報酬
- 強化学習エージェントが、この圧縮進歩による報酬の期待累積和を最大化するように学習すると、結果として「学習曲線の傾き(圧縮が進む速さ)が最大になる」行動を選ぶようになる
- 論文は、1990年の手法と1991年の手法を比較している
- 1990年の手法: 予測誤差そのものを報酬とする。しかし、ノイズによる誤差が続く場合、エージェントは誤った方向(予測不可能なノイズ)に誘導されてしまう
- 1991年の手法: 予測器の改善そのものを報酬とする。これにより、ノイズのような圧縮の進まない対象には報酬が発生しなくなる
- この違いが、「驚き(サプライズ)」そのものを報酬にする設計と、「圧縮進歩」を報酬にする設計の、本質的な差になっている
人工エージェントへの応用
- 1990年: RNNの予測誤差を好奇心報酬とする手法
- 1991年: 予測器の改善を予測するモデルを追加し、その期待される変化を報酬とする強化学習エージェント
- 1995年: 予測器の事前分布と事後分布の相対エントロピーを報酬とする手法。2005年にBaldiとIttiが、この手法が人間の視覚的注意の一部をよく説明すると報告している
- 1997年: 予測器と実験者(データを生成する側)が共進化し、賭けの形で互いの知識の穴を探す、ゼロサムのゲーム形式の手法
- 論文は、好奇心報酬を導入することで、外部報酬の獲得自体も速くなることを実験的に示したとしている
著者の意図について
- 紹介元のツイートは「この論文は哲学者ではなく、人工エージェントに内発的動機付けをプログラムするために書かれた」という点を強調していたが、論文を実際に読むと、人間の行動の説明と人工システムへの実装は、どちらも主要な目的として位置づけられている
- 論文のSection 1.2では、このアルゴリズム的な原理が「人間などの知的エージェントを定性的に説明する」としたうえで、人工システムへの実装を勧めている
- 結論部でも、人工の好奇心エージェントの構築と、人間行動への予測の検証という、両方の方向性に言及している
- つまり「人間を説明するためではなく、機械のために書かれた」という紹介のされ方はやや強調しすぎで、実際には人間の心理学的な現象の説明と、人工エージェントの内発的動機付けの設計は、最初から一体のものとして提案されている
まとめ
- 圧縮進歩理論は、主観的な美しさを「データを符号化するのに必要なビット数」として定義し、興味深さをその美しさの時間微分(圧縮がどれだけ速く改善しているか)として定義する
- 完全に予測可能なもの(退屈)と、完全にランダムで圧縮不可能なもの(ノイズ)は、どちらも圧縮進歩が生まれないため興味深くなく、両極端の間にある「学習によって徐々に規則性が見つかるもの」が、好奇心・美・ユーモア・芸術・音楽といった体験の共通基盤として説明される
- 強化学習の文脈では、予測誤差そのものではなく予測器の改善量を報酬にすることで、ノイズに引きずられない内発的動機付けが設計できる
- この論文は、人間の主観的な体験の説明と、人工エージェントへの内発的動機付けの実装を、どちらも目的として書かれている
参考文献
- Schmidhuber, J. (2008/2009). Driven by Compression Progress: A Simple Principle Explains Essential Aspects of Subjective Beauty, Novelty, Surprise, Interestingness, Attention, Curiosity, Creativity, Art, Science, Music, Jokes. arXiv:0812.4360
- Schmidhuber, J. (2009). Simple Algorithmic Theory of Subjective Beauty, Novelty, Surprise, Interestingness, Attention, Curiosity, Creativity, Art, Science, Music, Jokes. Journal of SICE, 48(1).