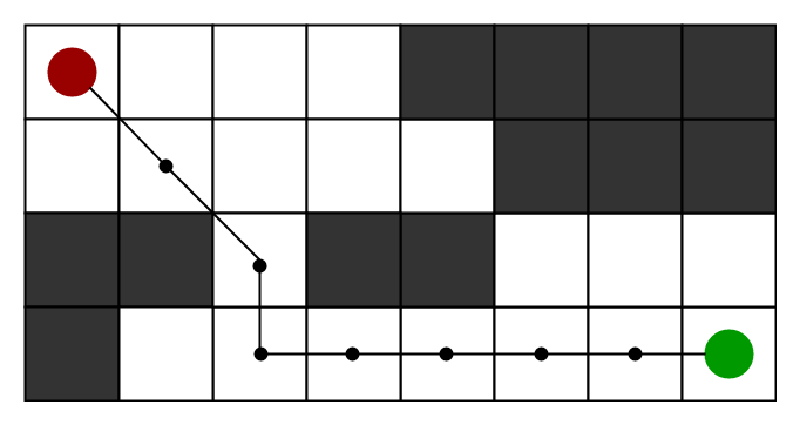
目次
背景
- 最近、色々なことを探索する機会の増加している
- 商品、仕事、旅行先、投資先、学習テーマ、技術選定などの比較など
- 選択肢が増えるほど難しくなる意思決定
- ROS2のNAVや機械学習、仕事でもこれらは頻出する
- 一見すると別々の分野の理論とも見える
- ただし、根底にある共通の問題として定義できる
限られた情報の中で、どこまで探索し、どのように推定し、いつ意思決定するか
探索に含まれる問題
探索を分解すると、主に以下の問題。
- 候補の生成
- 情報の収集
- 状態の推定
- 将来の予測
- 候補の比較
- 不確実性の評価
- 探索終了の判断
- 最終的な選択
それぞれの問題に対応する手法。
手法
最適停止問題
探索をいつ終了するかという問題で、代表例が秘書問題。
- 候補が一人ずつ順番に登場
- その場で採用または不採用の判断
- 一度見送った候補への後戻りは禁止
- 全候補を確認してからの決定も禁止
- 最も良い候補を選ぶことが目的
古典的な条件では、最初の約37%を観察に使い、その後に現れた過去最高の候補を選ぶ「37%ルール」という戦略で、早すぎる決断とおそすぎる決断の両方を回避できる。
- 37%という数字が成立するのは、候補数が既知、順序がランダム、後戻り不可などの条件がある場合
- 日常生活で重要なのは37%という数字そのものではなく、探索と決断を分ける発想
- 別の言い方をすると、以下の不等式が成り立たなくなったタイミングで探索をやめるということ
これには、機会損失も含まれるのかもしれない。
ベイズ推定
新しい情報によって評価を更新する方法で、最初から正しい評価を作るのではなく、観測のたびに評価を更新する考え方。
基本となる三つの要素:
- 事前確率
- 観測された情報
- 更新後の確率
例えば、あるサービスを導入する場合、次のように評価が更新されていく。
- 導入前は評判の良さ・導入コスト・他社の事例・機能の充実度で評価
- 試用後は、そこに追加された新しい情報を反映して評価を更新
固定された点数ではなく変化し続ける確信度であり、「最初の予想が外れた」という失敗ではなく「新しい情報によって評価が更新された」という理解になる。
マルコフモデル
状態の変化を確率的に捉え、次の状態への遷移確率としてモデル化する方法。
基本となる要素:
- 現在の状態
- 次に起こり得る状態
- 状態間の遷移確率
典型的な状態の例:
- 未認知
- 興味あり
- 比較中
- 購入
- 継続利用
- 離脱
重要なのは、現在の状態を過去の情報が圧縮されたものとして扱う点。
- 過去の出来事をすべて保存する代わりの現在状態
- 状態間の移動としての将来予測
- 一回の選択ではなく、連続する変化への注目
探索対象を静止した点ではなく、変化する状態として見る方法。
カルマンフィルター
ノイズを含む観測から本当の状態を推定する方法で、観測値そのものと本当の状態を区別する考え方。
現実で直接観測できるものの多くは不完全な例:
- 一時的な売上
- 短期間のアクセス数
- 他人からの評価
- 商品レビュー
- 市場価格
- 自分の体調
- 学習の進捗
基本的な流れ:
- 過去からの予測
- 新しい観測
- 予測と観測の誤差
- 推定値の修正
- 次の時点の予測
観測を全面的に信用するのでも過去の予測に固執するのでもなく、予測と観測それぞれの信頼度を考慮して更新する姿勢で、一時的な数字に振り回されず背後にある状態を推定するための考え方。
グリッドサーチ
あらかじめ決めた候補の組み合わせを網羅的に試す方法で、各項目に複数の候補を設定し、すべての組み合わせを比較する。
例えば、以下のような項目の組み合わせ:
- 価格帯
- 利用人数
- 導入期間
- 機能数
- サポート品質
グリッドサーチの特徴:
- 分かりやすい仕組み
- 比較過程の透明性
- 見落としの少なさ
- 計算量の増加
- 探索範囲の設定への依存
候補数が少ない場合には強力な方法だが、軸や選択肢が増えるほど組み合わせが急増し、そもそも探索範囲を誰が決めるのかという問題も残る。
モンテカルロ法
不確実な条件を何度もランダムに発生させ、結果の分布を見る方法。
モンテカルロ法では、一つの予測値ではなく多数のシナリオを扱う:
- 楽観的な場合
- 標準的な場合
- 悲観的な場合
- 極端な場合
- 予想外の組み合わせ
例えば、新規事業の評価では、以下のような条件を固定値ではなく確率分布として設定する:
- 顧客数
- 顧客単価
- 継続率
- 開発費
- 広告費
- 市場成長率
多数回のシミュレーションによって、以下のようなものが得られる:
- 平均的な結果
- 結果のばらつき
- 赤字になる確率
- 目標を達成する確率
- 最悪ケースの大きさ
単一の未来予測ではなく未来の可能性の分布であり、「いくらになるか」ではなく「どの程度の確率で、どの範囲になるか」という問いになる。
効率的フロンティア
複数の評価軸から、明らかに劣る候補を除外する方法。
基本的な流れ:
- 二つの評価軸の決定
- 候補のリスト化
- 各候補の数値化
- グラフへの配置
- 他の候補に支配される候補の除外
- 効率的フロンティアの抽出
- フロンティア上からの選択
投資では、一般的にリスクと期待リターンの関係として利用される。
- 同じリスクなら、より高いリターン
- 同じリターンなら、より低いリスク
- どちらの面でも劣るポートフォリオの除外
つまり、リスクとリターンの両面で他に劣る候補を機械的に除外する考え方。
ゲーム理論
二人以上の取引では、囚人のジレンマのような構造になることがある。
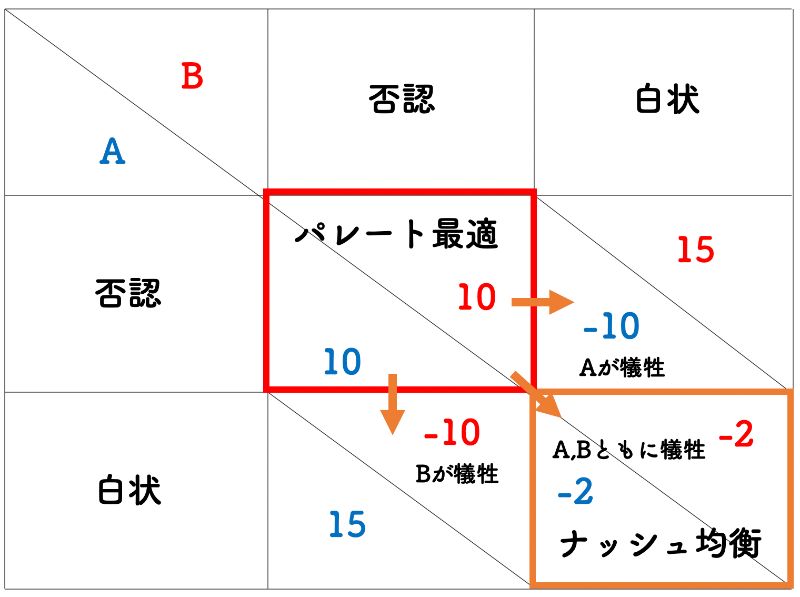
この場合の最適解:
- パレート最適
- ナッシュ均衡
非協力で損を避けるか、協力して得を取るかという選択になる。
二分法
- 最も古典的だが役立つ手法
- 例えば、コードにバグがあったとする
- どこか全くわからないときはシンプルに半分コメントアウトする
- すると、1/2でバグに当たる
- バグにあたったら更に1/2とこのように繰り返す
- $O(\log_2 n)$の計算量になる
Just Do it
- 下手の考え休むに似たり
- 行動したほうが速いこともある
- 探索しないアルゴ
- 行動そのものを低コストな情報収集として使うアルゴリズムとも言える
TTP(徹底的にパクる)
- 誰かがすでに探索・検証済みの答えがあるなら、それを丸ごと真似ることで、探索そのものを省略できる
- 「巨人の肩の上に立つ」という言葉も同じ発想
- 「学ぶ」の語源は「真似ぶ」という説がある
- 学習の本質はもともと模倣だった
- つまり、ゼロから探索するより、先行研究、先行事例、成功事例をそのまま輸入する方が速い
- また、ホモサピが他の動物より優れている点の1つが、模倣(観察学習)の能力の高さ
- 探索のコストを払う前に「誰かがすでに解いていないか」を確認するのが、最も効率的な探索戦略とも言える
- 明治期の日本も模倣がうまかった
まとめ
- 改めて全体を見渡すと、普通に知識が大切だと思った
- ヌケモレなく、MECEかどうか、全体を網羅しているのか
- 最初の候補で、この前提がない場合は最適解に行きづらい
- しかし、知識を増やし続ければ正解に到達できるとは限らない
- 知識の獲得にもコストがあり、環境が変われば古くなる
- 結局は、探索と活用のトレードオフは常につきもの
- 大切なのはその見極め
- そして、直面する課題には往々にして先人が既に直面しているので、先行事例をベースにするべき