目次
背景
- 機械学習モデルを利用したシステムの開発で、precisionを高める必要があった
- 特に、対象ではないデータをpositiveと誤判定するFalse Positive(FP)のコストが高かったた
- そのため、評価データ上でFPを発生させず、可能な限り高いrecallやcoverageを維持することを目標にした
- しかし、本番環境では入力がフリーフォームに近く、事前にすべての入力パターンを列挙したり、完全に制限したりすることは難しい
- なので、学習時に想定していなかった未知のデータ、すなわち分布外データに対する対策が必要になった
- ここでは、そのときに実施した対策と、それぞれの限界についての備忘録をまとめる
- なお、有限の評価データでFPが0件だったとしても、将来のあらゆる入力に対してFPが発生しないことを保証できるわけではない点に注意
- ここでの「FPを抑える」とは、モデルとシステムの両面から誤判定のリスクを下げることを意味する
用語
ラベル
- positive
- 判定対象であるデータに付ける正例ラベル
- negative
- 判定対象ではないデータに付ける負例ラベル
IDとOOD
- ID(In-Distribution)
- 学習時および運用時に想定している分布に属するデータ
- OOD(Out-of-Distribution)
- 学習時に想定した分布から外れるデータ
- 疑似OOD
- 外部データやデータ加工によって作成した、OODを模したデータ
NOTE:
- ID/OODとpositive/negativeは別の概念
- ID/OODは「想定した分布に属するか」を表し、positive/negativeは「判定対象であるか」を表す
- したがって、IDのnegativeやOODのpositiveが存在する可能性もある
- 実装上、OODをnegativeまたはNoneとして扱う場合があるが、概念として同一ではない
対象と想定の4象限
| - | 対象(Positive) | 非対象(Negative/None) |
|---|---|---|
| 想定内(ID) | ① ID-Positive | ② ID-Negative |
| 想定外(OOD) | ③ OOD-Positive | ④ OOD-Negative |
- None:ラベル上、対象クラスではない
- OOD:学習・想定分布から外れている
- ID-Posivtive:想定範囲内の対象
- ID-Negative:想定範囲内の非対象
- OOD-Negative:想定範囲外の非対象
- OOD-Positive:分布外だが、本当は対象に該当する
Mining
- mining
- 大量の候補から、学習に役立つデータを発掘すること
- hard negative mining
- 現在のモデルがpositiveと誤判定しやすい負例を優先的に発掘すること
OOD検出
- 入力が学習時に想定した分布の範囲内か、それとも分布外かを判定すること
- 一般には、モデルや特徴量からOODスコアを算出し、しきい値を超えた入力をOODとして扱う
- ただし、IDとOODの境界は絶対的なものではなく、「何を想定範囲とするか」というタスクの定義にも依存する
i.i.d.(独立同分布)
- データが互いに独立であり、同じ確率分布に従うという仮定のこと
- 機械学習では、学習データと評価・運用データが同じ分布から生成されるという仮定を置くことが多い
- 現実の運用環境では、時間、ユーザー、センサー、入力方法などの変化によって、この仮定が崩れることがある
内挿と外挿
- 内挿(interpolation)
- 学習データが十分に存在する領域における予測
- 外挿(extrapolation)
- 学習データがほとんど存在しない領域における予測
- 学習域
- 学習データが分布している領域を指す非形式的な表現
多次元データでは、各特徴量が単独では学習時の範囲内でも、特徴量の組み合わせとしては学習データから大きく外れていることがある。
なお、外挿とOODは関係が深いが、必ずしも同じ概念ではない。
バイアス
バイアスとは、調査や分析結果が、真の値や関係性から体系的にずれてしまうこと。
| バイアスの種類 | 定義 |
|---|---|
| 交絡バイアス | 第3の因子が介在し、見かけ上の因果関係を生む |
| 選択バイアス | 調査対象の選定に偏りがあり、標本が母集団を代表しない |
| 情報バイアス | 測定や回答、記録などの不正確さによってデータに偏りが生じる |
因果関係と相関関係
ココらへんも頻出なので注意。
| 観点 | 相関関係 | 因果関係 |
|---|---|---|
| 意味 | AとBが一緒に変化する | AがBを引き起こす |
| 関係 | 「Aが増えるとBも増える/減る」 | 「Aを変えると、その結果Bが変わる」 |
| 原因・結果 | わからない | 原因と結果がある |
| 方向性 | 基本的に方向は決まらない | A → Bという方向がある |
| 第三の要因 | 影響している可能性がある | 交絡などを排除する必要がある |
| データだけで判断できる? | 比較的見つけやすい | 相関だけでは証明できない |
| 例 | 身長と体重には相関がある | 喫煙は肺がんリスクを高める |
欠落と交絡
早とちりの論理は多いので注意。
- 欠落
- 重要な第三の変数を落とした(欠落変数)上の結論
- 特に、その変数との交互作用を無視した結論
- 何を分析から落としたかという問題
- 例:
- 「モデルのパラメーターを増やしたら=>前回より精度が落ちた」 ∴ 「モデルのパラメータを増やすと精度が落ちる」
- でも実際はデータを増やしたら(第三の変数)、結果は良くなった
- つまり「Bを固定したときのAの効果」を「Aの普遍的な効果」だと思ってしまった
- 交絡(こうらく)
- 第三の因子による見せかけ上の因果関係を出す事
- 欠落によって因果推定がどう歪んだかという構造
- 例:
- 「アイスが売れると水難事故が増える」
- 実際は気温が関係ある
ゴールドラベルとシルバーラベル
- ラベルの信頼度によるGold(人手検証済み)・Silverの違いや、タクソノミー設計については機械学習におけるクラスとラベルの再考で詳しく扱っている
- 評価データは特にゴールドで揃えることが望ましく、シルバーのまま評価に使うと、モデルの精度なのかラベルのノイズなのかが区別できなくなる点は、OOD対策の文脈でも重要
分布シフト
機械学習モデルの前提と問題
教師あり機械学習モデルは一般に、学習データから得た統計的な関係が評価時や運用時にも成立することを期待して学習される。
しかし、現実の運用環境では次のような理由でデータ分布が変化する。
- データの収集方法が変わる
- ユーザー層が変わる
- 撮影環境やセンサーが変わる
- 時間の経過によって対象の性質が変わる
- 学習データの選び方に偏りがある
- データ生成メカニズムそのものが変わる
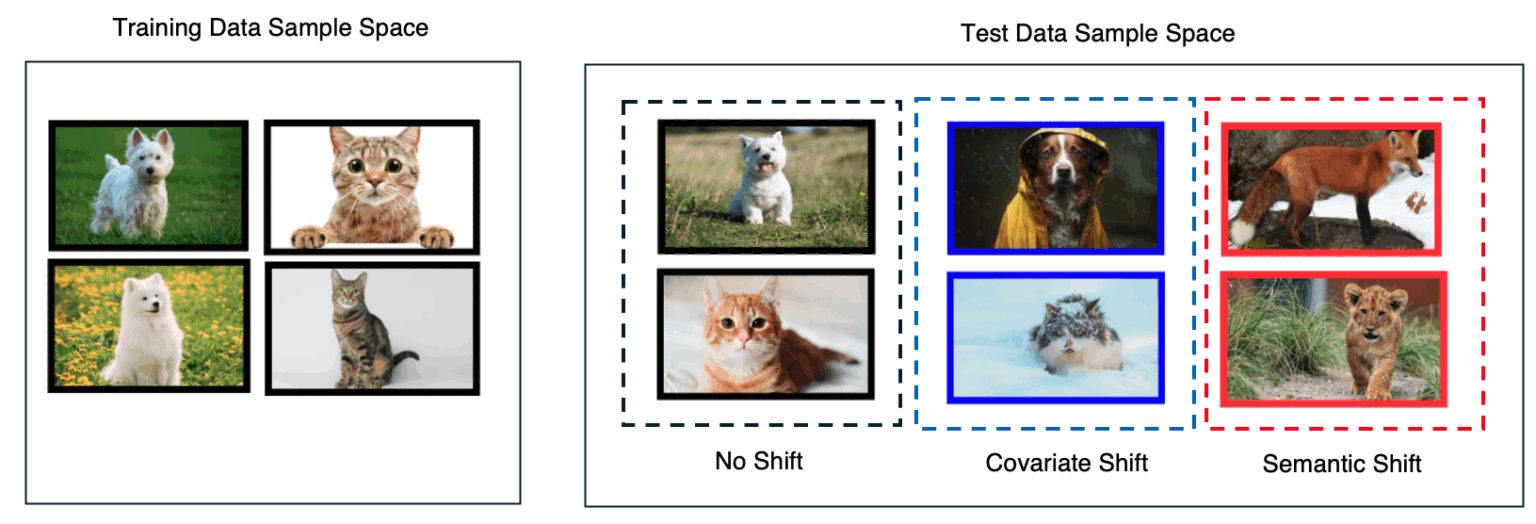
このような学習時と運用時の分布の違いを、分布シフトと呼ぶ。
主なデータセットシフト
| シフト | 変化するもの | 不変と仮定するもの |
|---|---|---|
| Covariate Shift | $P(x)$ | $P(y \mid x)$ |
| Label Shift | $P(y)$ | $P(x \mid y)$ |
| Concept Shift | $P(y \mid x)$ | 一般には特に定まらない |
他にも、次のような表現が使われる。
| 用語 | 内容 |
|---|---|
| Domain Shift | 撮影環境、計測方法、データセット、利用環境などのドメインが変化すること |
| Sample Selection Bias | データの選択方法や収集方法によって、観測された分布に偏りが生じること |
- 例えば、道路画像が昼から夜に変化するケースはDomain Shiftに当たる
- これによって$P(x)$が変化し、$P(y \mid x)$が変わらないと仮定できる場合はCovariate Shiftとしても扱える
- 実際のシステムでは、複数の種類のシフトが同時に発生することもある
評価指標
False Positiveを議論するときは、precisionとFalse Positive Rateを区別する必要がある。
$$ \mathrm{Precision} = \frac{TP}{TP + FP} $$$$ \mathrm{FPR} = \frac{FP}{FP + TN} $$NOTE:
- precisionは、モデルがpositiveと判定したもののうち、実際にpositiveだった割合を表す
- FPRは、実際にはnegativeだったデータのうち、誤ってpositiveと判定された割合を表す
また、すべての入力をnegativeまたは棄却にすれば、FPを0件にすること自体はできる。そのため、安全性を評価する際にはFPだけでなく、recallやcoverageも同時に確認する必要がある。
- recall
- 実際のpositiveをどの程度検出できたか
- coverage
- 全入力のうち、棄却せず自動判定できた割合
- selective risk
- 棄却せず受理した予測における誤り率
そもそもの前提
About Data
データが全て
- 結局はデータがあるかないかによって全てが決まると言っても過言ではない
- 特に評価では実データでやらないとドメインシフトが起きるので正当な評価ができない
- データがあればほとんどの問題は解決するので、めんどくさくても先にデータを集めるべき
- Data is the new oil
データ生成が最強
- もし実際のinferenceデータを生成できるならそれが一番強い
- データの分布の変更や、ハードネガティブにも逐次対応できるから
- ドメインシフトが起きず、データ生成が適用可能な問題を解くのも大切
- 例えば、画像分類などで、データ生成による精度向上が良く使われがち
GIGO
- garbage in, garbage out
- モデルが弱く特徴が抽出できない事もある
- また最新のモデルにすればいいと考える事もある
- しかし、最新のモデルでも精度の差は数ポイントになることが多い
- すなわちデータがほぼ全てと言っても過言ではない
データの特徴を消さない
- 音ではメルスペクトル特徴量や画像では圧縮などをやりがち
- 推論を高速化する上では重要だが精度を高める上では情報量が全て
- 最近ではメルスペクトル特徴量のような人の手によって作られた情報ではなく、wavを直接使う事も多い
- また、図面などのデータでも、情報がスパースなので、圧縮すると消えてしまったりする
- モデルの層に関しても同じでそもそも層に分解可能な情報が残っているのかも重要になる
- もし転移学習などを刷る場合は、学習する前に、サブクラスレベルでDNNのレイヤーの分解能があるかを見極めるべき
データフォルダの分け方
データフォルダは、grade(難易度別)・class(ラベル別)・positive/negative(正負)・easy/hard・subclass・pair(対照学習用のペア)などの軸で分ける。より一般的なフォルダ管理・タクソノミー設計・seedの考え方は機械学習におけるクラスとラベルの再考で詳しく扱っている。
特に、generalization dataset(いわゆるOOD dataset)は用意しないと客観的な性能評価ができない。
実験の前提の前提
安定化モード
- seedは再現性確保で最も重要な話なので、必ず決定論的に実験ができるようにする
- 逆説的に、決定論的にしないと、そこが常に疑えるので、そもそもAIとdiscussionや検証しても意味がなくなる
- 処理速度を犠牲にしてでもやるべきであり、最初に安定化モードの試験を数回行うべき
| |
seedキャリブレーション
- seedを変えて結果がどのぐらい変わるのかをCheckする
- もしseedを少し変えて結果が大きく変わる場合は、データのとり方などが一番大きなハイパラになる
- 基本的にそれだとモデルのアーキの向上による差が減るので、固定もするが、seedに依存しないようにするのも大事
- 例えば、ランダムサンプリングで抽出していたのを、固定分割でサンプリングするなど
- ランダムサンプリングだとseedに依存するが、固定分割だったらepochに依存する
- epochは往々にして変えないし、増やしても途中の結果が残るので、途中ので比較すればOK
クラス別信頼区間
- 最初に同じデータ、同じシードでべき等性テストをするべき
- もし安定化モードが適用できないような確率的な結果になるときは特に重要
- 統計的に有意な回数分テストを回して点推定の信頼区間をクラス毎に取るべき
- 実験をするなかでクラスやグレードごとに分散は違うのが一因
- これをしないと、いくら変化があっても原因がその変更によるものかはわからなくなる
- これがFirst Stepとなる
対処方法
特徴抽出機の評価
線形Probeで特徴抽出できるのかを評価する
- 最近のAIの開発は強い特徴抽出機と分類Headを分離する事が多い
- その時に、特徴抽出機は外部のものを使うことがあるが、その評価も刷る必要がある
- 例えば、Encoderを外部がら使ってEmbeddingするとする
- AとBとCと複数のEncoderを評価する必要があり、かつそもそも特徴が埋め込まれていているのかも考慮刷る必要がある
- 例えば、線形プローブでEmbeddingからシンプルな線型回帰ができるか検査する
- 色々な層の出力に同じ種類の線形Probeを載せて、どの層で情報が最も読み出しやすいかを比較する
- もしできないなら、そもそも前提の特徴抽出機やその特徴空間にその情報がないことになる
- 線形Probe以外にも複数の分類器族を横断的に比較すると、埋め込み空間の幾何構造そのものを診断できる。詳しくは分類器の比較で埋め込み空間の構造を診断するで扱っている
- ただし、仮説の交絡に注意するべき
- つまり、本当の原因ではないものを原因だと勘違いしてしまう事に注意
- 一言でいうと、「どの層で、どんな情報が立ち上がって、どこで消えるか」を見る検査
対照群付き埋め込み分析
- 一言でいうと、データをベクトル化し、注目するグループと比較対象のグループで、埋め込み空間の違いを調べる分析
- 例
- 対象群:AIを導入した店舗のレビュー
- 対照群:AIを導入していない似た店舗のレビュー
- この2つを比較して、「AI導入後、顧客レビューの内容が変化したか」を調べる
- つまり、対象群は対照群に比べて、この方向にどれだけ特徴的にずれているかを見極める
- もし、埋め込み後にデータとして特徴抽出の効果が出ているのか否かを調べる
データの集め方
posi/negaの両方を集める・中間データの保存・ダブルチェック・出来合いデータのみでテストを作る、といった収集時の実践は機械学習におけるデータとデータソースの再考で扱っている。
データのクラス間の量
stratified splitについては機械学習におけるデータとデータソースの再考で扱っている。ここではクラス間の量の偏りをどう調整するかを扱う。
Class balancing(バランス化)
- クラス間の影響の偏りを調整する、より広い概念
- データ数そのものを変える場合もあれば、ロスのクラスウェイトのようにloss上の重みだけ変える場合もある
- 方法には以下がある
- oversampling:少数クラスのサンプルを増やす
- undersampling:多数クラスのサンプルを減らす
- サンプリング重み:データ数は変えず、抽選確率を変えてバッチに乗る頻度を調整する
- ロスのクラスウェイト:データ数は変えず、少数クラスのlossへの寄与を大きくする
- Focal Loss:簡単に正解できるサンプルのlossを弱め、難しいサンプルを相対的に重視する
- また、balancingの一種で、よくやるのが、train splitで各クラスのサンプル数を、以下のABCのように均等にすること
| |
oversamplingとundersampling
どっちも不均衡データのクラス比率を、学習用データ側で調整する方法。
- oversampling
- 少ない方を水増し
- undersampling
- 多い方を間引く
サンプリング重み
- oversamplingは、実際には各サンプルに重みをつけて、その重みに比例した確率で抽選する形で実装することが多い
- ロスのクラスウェイトと違い、lossの計算自体は変えず、どのサンプルがバッチに乗るかの確率だけを変える
- インバランスデータの学習に有効
- 重みは1/サンプル数(所属グループの件数の逆数)を使う
- loss reweighting(ロスのクラスウェイト)と対になるやり方
| |
hard case・Class Design・Geometric Class Design
hard negative/hard caseの作り方(shifted positive・adversarial negatives・Truncated Negative・Hidden Negativeなど)、Noneクラス・Negationクラスの設計、クラスの完全性・無矛盾性の原則、クラスの幾何学的デザイン(コアとサーフェス、境界専用データセットなど)、具体的なデータセット定義例は、分類タスク固有の設計問題として機械学習におけるクラスとラベルの再考にまとめている。
Grade class
grade別の評価データ設計や、holdout以外の複数種類のtest/evalデータセットの必要性については機械学習におけるクラスとラベルの再考の「Gradeによる難易度設計」で扱っている。
データの量
サンプル数の絶対量・相対量(クラス間バランス)の注意点は機械学習におけるデータとデータソースの再考の「データの量」で扱っている。
Data Check
最小構成でのミニテスト(overfit a single batch)・データビュアー・そもそものデータセット確認・前提の制約の見直しといったデータ品質のチェック手法は機械学習におけるデータ品質QAの再考で扱っている。
結果の比較
見た目の精度差が統計的に有意かどうかを検定する方法は、マクネマー検定でモデル比較の有意差を検定するで扱っている。
追加したデータ量の確認
- 基本的に過去の実験と新しくした実験を比較するが、そもそも論データを増やしたら前提が変わる
- 例えば、Positive/Negativeの二値分類で、Positiveデータを増やしたとする
- すると、それに引っ張られてモデルのPositiveの出しやすさも変わる
- すなわち、何件そのカテゴリーで追加したのか、それは前回と比べて何%増えたのか、そして、クラス比はどう変わったのかを計算する必要がある
- それらを元にデータ量や比率の違いによる影響のありなしを評価することができる
ホールドアウトかの確認
- ある実験とある別の実験の比較で追加したデータによる精度の比較をする
- つまり、新しく追加したデータがホールドアウトとして半分とか評価データに使われているなら疑うべき
- 特に新しいデータを大量に追加してその結果、評価データが増えて、指標が良くなっただけかもしれないから
- 基本的に評価データはホールドアウト以外に評価のみのデータセットを用意しておいてそれでもCheckするべき
アブレーション
- もし追加したデータやモデルの差を見たいん場合はアブレーションをするべき
- 結局は安定化モードで決定論的な結果を出せても、複数の変更を含む実験だと原因が分からなくなる
- 機能であれば、XXXを消したバージョン、YYYを消したバージョンなどで追試をすることで何が寄与したのかを出せる
サブクラス間の相関
- クラスのpositive/negativeの中のさらにsubclassを定義することで強みと弱みがわかる
- 特にデータ量の差よりもそのサブクラスの特性による得意不得意がわかるから
- あえて弱みのサブクラスに対してはOut of Scope対応にしたりそれ専用の対策を入れる事も可能になる
- それができるのも、クラスのさらに細かいSetのサブクラスを定義するから
総当りサブクラス
- さらに、総当たり系のサブクラスはそもそも論、サブクラスの中の更に詳細なサブサブクラスも把握できる
- 例えば、あるクラスのネガティブのあるサブクラスについて、MECEに網羅できるならそれの中のサブサブクラスがモデルの性能を明らかにする
- 結局はデータの定義やTaxonomyをしっかりすれば、色々な考察が可能になる
Exposure
サブクラスカバー率とサブクラス学習効率
- サブクラス毎に量の偏りがある場合は、サブクラスごとの選出率も関係ある
- AとBというサブクラスがあり、Bクラスは量が多いが、AとBを同じ用にサンプリングしていたらカバー率が違う
- 仮に新しいBというサブクラスを追加しても精度が上がらない=難しいとはならない点に注意
- また、統計的に仮にカバーを100%していても見ている回数が違う=学習しやすさが違う場合がある
- その場合は、カバー率だけではなく、学習効率($sampleされた回数/データセットのサンプル数$)も出すべき
- ステップ数におけるサンプリング数をだして、その上でサブクラスカバー率とサブクラス学習割合を出すべき
- これとサブクラスごとの誤検知率とサブクラス学習割合の相関性をだすと学習が公平だったのかがわかる
サブクラスバリエーション効率
- これはData Augumentaionする前提での話
- subset毎にデータaugmentationを変えていた場合は、それもvariationという指標になる
- 単純な話サンプル数が多くてもvariationの少ないところからのsamplingか否かで大きく意味が異なる
- そのため、精度との比較はサブクラスの学習効率とともに、variation数も比較する必要がある
- バリエーション効率は$variation/samples$で求める
- 一般的に、量が多いデータセット程複雑なパターンがあるという前提で効率を求める
露出と表現の問題
- 仮にあるサブクラスの精度が低く、サブクラスのvariationとカバー率を上げたとする
- その結果、サブクラスは相対的、絶対的に増えたにも関わらず精度が上がらなかったとする
- この場合は、データの露出は増やしたのに、表現が上がらなかった事を意味する
- すなわち、Exposureの問題ではなくExpressionの問題と判断する事ができる
- Expressionとは、例えば分類問題などであった場合はHeadの話
- 特に、すでに線形Probeなどでモデルの層に線形分類するだけの特徴がある場合などは強くその仮説が支持される
- 例えば、分類層では、mean poolingをしていたがそれが特徴をけしていた、など
error analysis
データリーケージに注意する
- データリーケージ(Data Leakage)とは、本来モデルが知り得ない情報が、学習や評価のプロセスに紛れ込んでしまうこと
- エラーアナリシスにおいては、testデータを見て傾向をつかみ、その結果を元にモデルやデータを改善するというサイクルを繰り返すこと自体が、一種のデータリーケージになる
- 繰り返すうちにtestデータが実質的なvalidationデータ化してしまい、最終的な評価値が楽観的に偏る
- これは後述のWinner’s Curseと同じ、同じデータで選択と評価を繰り返すことで生じるバイアスの一種
- そのため、エラーアナリシスは基本的にvalidationデータで行い、testデータは最終確認のためだけに温存するべき
Winner’s Curse(勝者の呪い)に注意
- 複数のモデル、checkpoint、しきい値、ハイパーパラメータを同じ検証データで比較し、その中で一番良かったものを選ぶと、選ばれた候補の評価値は本来の実力より楽観的に偏る
- 理由は、比較対象の数が増えるほど、たまたま検証データとの相性が良かっただけの候補が選ばれやすくなるため
- 元はオークション理論の用語で、複数の入札者が同じ対象の価値を誤差込みで見積もったとき、最も高く見積もった入札者(勝者)の見積もりは実際の価値より高くなりがちという現象
- 意思決定論では同じ現象をoptimizer’s curseとも呼ぶ
- データリーケージが「testデータを見て判断や改善を繰り返すこと」自体の問題なのに対し、Winner’s Curseは「パラメータや候補を最適化(比較・選択)した結果、選ばれたものの評価値が偏る」という、選択操作そのものに起因するバイアス
- 対処方法
- 選定に使ったのとは別のホールドアウトデータで、選ばれた候補を再評価する
- 比較する候補の数を絞る、または候補間の差が誤差の範囲内かを検定する
- checkpointの学習時evalを鵜呑みにしないという注意点(後述)も、この現象の一種
NOTE:
- いわゆる「データ最適化バイアス」(同じデータに対して選択と評価を繰り返すことで生じる楽観バイアス)と、この現象は本質的に同じもの
- しきい値選定、モデル選定、特徴量選定、ハイパーパラメータ探索など、何であれ「同じデータで何度も比較して一番良いものを選ぶ」という操作が入る限り発生する
- 呼び方が違うだけで、根っこにあるのは「選択に使ったデータで、選んだものをそのまま評価してはいけない」という同一の問題
エラーアナリシス
- 言わずもがなエラーアナリシスを行うのが一番大切
- どこがエラーになり、なぜエラーになったのかの分析のこと
- 特にエラーの分類(Subcategorization)を行い、何が弱いのかを具体的に判断する
- 他には、一番重要なのはNoneクラスのRecall(全体見逃し)やその他のクラスのPrecisionなど
- subcat毎に指標を置いて、エラーの傾向や割合をCheckする
- 別の言い方だと、Don’t boil the oceanという考え方に近い
データを可視化する
- 例えば、PCA、T-SNE、UMAPなどで次元を削減して可視化するのも一つの手
- クラスタリングしてクラスごとの境界線を可視化するとどのぐらい分けれているのかがわかるため
- そこで実際にコードを動かして結果を元にプロットするとどのクラスターに近いかがわかる
- 実際に手で動かすと、実はWhack-a-Moleパターンだとわかることもある
- 単に混同行列だけではなく、推論用にクラス境界マップを作るがおすすめ
確信度の高いfalseの境界ペアの可視化
- 確信度の高いfalseの境界ペアを明らかにするのが一番当たり前だが最も重要
- 確信度が90%以上で間違った例を確認して、どのクラスがどのクラスと間違えたのかという情報
- 例えば、AをBと間違えたなら、その分類の境界線が怪しいということ
- それらのfalseの境界ペアに対して、境界線をはっきりさせる為のサンプルを追加すればいいという事
- そして、Noneが全体を網羅する負例クラスとして存在するため、幾何学的にNoneはあらゆるクラスと接する
- そのため、Noneに関してはepoch毎に入れ替えて多様性を加味して多角的に接点を学習させる必要がある
- 普通のクラス境界よりもNoneのクラス境界は多次元的に接していると考えられるため
- 別の言い方をすると、あるAクラスは狭いので他のクラスと距離がある、しかし、Noneは広いので他のクラスと距離が近いということ
信頼度をキャリブレーション
- 分類器が出力する信頼度 (confidence) が、分類結果が真に正しい可能性を表すように補正する
- これを、信頼度キャリブレーション (confidence calibration) と呼ぶ
- つまり、AIや自動化システムへの信頼を、そのシステムの実際の当たりやすさに近づけていく手法
エラーのクラス分類
- 特にしきい値が高いときのエラーの内訳が大切
- その上で、genuine vs. quetionableなのかが最初のフィルターになる
- つまり、評価データで正しくGTのラベルがついいているかいないかという事
- さらに、それがグレード別にどうなのかの判断も大切
- ODDだった場合はグレード外やtaxonomyのヌケモレだったということ
- エラー内のクラス分類をして間違えたOODに対して、対策するのが正しい
Nearest Neighbor Analysis
- 学習して分析し、最もエラーが高かったものの一覧を出す
- それをベースに、まずはどんな特徴があるのかをCheckする
- さらに、そのエラーの特徴量一つ一つの特徴量と一番近い学習データの特徴量を出す
- これによって、そのエラーが何のトレインによって学習されたのかがわかる
- 例えば、ある似たTrainの集合A, B, Cというデータがあり、それぞれ特徴量DとEを共有する
- しかし、実際にDを学習させる目的で学習したらEも学習してしまったみたいな事もある
- その場合は、Eを含むNear Negativeなデータを含めればいいとわかる
評価
かならず複数しきい値で評価する
- しきい値を一つで評価するとモデルの評価はできない
- AUCも複数種類でやるべきであり、かつclassやsubclassレベルでもやるべき
- 特に、モデルのアーキを良くしたのに精度を一つの指標で評価するのは危険
- 性能が上がっているのに、見落としている事が往々にしてあるから
- 最低でもROC-AUCとPR-ACU、pAUC(この場合は、FPRのpartial AUC=部分AUCなど)で評価するべき
不均衡データではAUC系より実運用の分母に寄り添った指標を使う
- 極端に不均衡なデータでは、AUC系の指標だけでは実運用の感覚とズレることがある
- 理由は、AUCは正例・負例のペアの順位関係を見る指標なので、負例が膨大にあっても比較的高い値が出やすいため
- 実運用の分母(1時間あたり・1日あたりの発話数など)に寄り添った指標を使うべき
- 例: FA/hour(1時間あたりの誤発火数)
- こうすることで、「実際に運用したらどれくらいの頻度で誤動作するか」が直感的に分かる
マクロ指標とマイクロ指標でみる
- 全体としては性能が下がっていように見えても部分では性能が上がっている可能性がある
- 全サンプルを均等に評価するマイクロ指標サブクラスやクラス毎に出して評価するマクロ指標は分けるべき
- 特にある一部の問題を解決できるが全体の性能が下がるトレードオフがあるのが普通
- 全体評価と個別評価は分けて述べるべき
アップストリーム指標の注意
- 前提となるepoch選定には学習時のアップストリーム指標のみで測るとbestモデルを選べないことがある
- 故に、analysisの前提となるepochについては、ダウンストリーム指標で測るのがベター
- すなわち、eval_lossとかだけではなく、この例で言うと、FPRやNone-Recall、クラスのPrecisionなどで総合的にクラスやサブクラスベースで測るべき
- 安易にeval_lossでbestを出さないべき
checkpointの学習時evalを鵜呑みにしない
- 学習中に自動で出るcheckpointごとのeval結果は、軽量・簡易な指標であることが多い
- 良さそうなcheckpointが見つかっても、その数値をそのまま信じてモデルを選定しない
- 後で改めて、ちゃんとした評価指標・評価データでそのcheckpointを洗い直すべき
- 学習時evalと本番想定の評価は、計算方法やデータの粒度が異なることが多く、乖離が起きうるため
Winner’s Curse(パラメータ最適化のバイアス)
Winner’s Curseについては、前述の「error analysis」内の同名セクションを参照。
足し算じゃない相互作用に注意
- 変更一つに対して精度が下がってもそれが必ずしも悪影響だったかというとそうでもないこともあるので注意
- 例えば、以下みたいなことがある
- Aという変更=>精度が下がった
- Bという変更=>精度が下がった
- しかしAとBを両方同時に入れた=>精度が上がった
- 故に、一般的に論理的に考えて有効な手法でも前提条件が揃わず下がる事があるので注意
- 自分の例では、multi-head attention pool x exposure設定の向上 などであった
- かっこよくいうと、non-additive interactionというらしい(マイナスかけてプラスだから?)
OOD対策の評価方法
OOD対策は、単一のテストデータだけで評価しないほうがよい。
例えば、次のように評価データを分ける。
- IDのpositive
- IDのnegative
- IDに近いnear-OOD
- IDから明確に離れたfar-OOD
- 実際の運用ログから作ったデータ
- 時期、ユーザー、環境などで分けたデータ
確認する指標には次のようなものがある。
| 対象 | 主な指標 |
|---|---|
| 通常の分類 | Precision、Recall、FPR、F1 |
| OOD検出 | AUROC、AUPR、FPR@95TPR |
| 棄却を含む分類 | Coverage、Selective Risk |
| 安全性 | 受理した予測におけるFP件数・FP率と信頼区間 |
しきい値は検証データで決定し、最終評価データを確認してから変更しないことも重要である。
評価データ上でFPが0件だった場合も、「観測されたFPが0件だった」と表現し、将来のFPが0であると断定しない。
model
学習率の選択
- いろいろな手法を試していて、早いepochでlossが下がりすぎる傾向がある場合は、学習率が高すぎることを疑うべき
- 学習率の調整だけでも、スコアが良くなることが多い
- 迷ったら、その手法のベースになっている論文で使われている学習率を採用するのが安牌
- 桁を変えた複数の学習率(例: 1e-3、1e-4、1e-5)で実際にチェックして比較するべき
入力データを増やす
- 基本的に入力に対してモデルは学習する
- もしどんなに頑張っても精度が上がらないときは、シンプルに入力データを増やすといい
- あるEncoderをFreezeしたモデルで使ったクラス分類の時に、そのEncoderの中間データを使った
- 一般的にEncoderの最後の出力を使うと、既に丸められたデータだったから
- このように、入力が抽象化されて弱いときはあえて、低次元のプリミティブな情報を取ってモデルを構築するのもあり
マルチエンコーダーを組み合わせる時の注意
- 複数のEncoderの出力をシンプルにconcatして学習に使ったが、精度が上がらなかった
- 原因は、Encoderごとに出力のスケールが違うものをそのままconcatしていたこと
- スケールの大きいEncoder側の情報にモデルが引っ張られてしまい、スケールの小さい方の情報が実質的に無視されてしまう
- 対処方法はz値化
- 各Encoderの出力を平均0・分散1に標準化してからconcatすることで、スケールの違いによる偏りをなくす
モデルを厚くする
- モデルのパラメータと学習量には相関性がある
- ASRなどではEncoderの学習できる量はそのパラメーター数で決まる
- 例えば、大きな学習データを小さいEncoderで学習しようとしても忘却してしまう
- もしくは、小さな学習データを大きなEncoderで学習しても過学習するだけ
- モデルの容量とトレインデータのバランスが取れるモデルの厚みにするべき
残差とconcat
- ResNetのような加算による残差を伝えたり、concatして長いベクトルにする方法もある
- 例えば、Conv層で情報を近傍の特徴を抽出しているが、それが原因だと判断した場合
- その場合は、そのConv層で行う入力を残差ブロックやConcatで繋げて後ろに伝える方法
PE
- TransformerではPositional Encodingを行う
- それを応用してabsolute/relativeなPEを使って位置情報を明示的に特徴にする方法もある
- Conv層の場合は、局所的な特徴をFilterするのでbiasとして織り込まれているが、明示的にPEをやるのもあり
- ただし、絶対的なPEを使うと、その場所にその情報があることを過学習してしまう可能性もあるので注意
PoolingをAttentionに
- poolingをAttentionするのも有効な手法
- 局所特徴をConvなどで抽出したとに、情報を抽象化する意味でPool層を入れる事はあるが、情報がぼやけてしまうことがある
- 例えば、mean poolなどでは、結局はpoolはそれぞれを重みをなく要約するので重要な情報が落ちる可能性がある
- この場合は平均に要約されて、最大や最小の情報が消えてしまっている
- そのため、Query attention poolingやmulti head attention poolingなどでどこのpoolを重要視するかを学習させるのもあり
ConvをAttentionに
- ConvをAttention系にするのも有効な手法
- Convだと近傍の特徴をまとめるinductive biasがかかっているが、全体をみたい時などにはself-attentionなどが有効
- 特に、multi-head self-attentionで複数のhead(見方)から高度なattentionをかけて特徴抽出を学習することができる
不均衡データの学習方法
None(負例)をepochごとに入れ替える
- Noneクラスとして利用できる負例が大量にある場合、各epochで異なる負例をサンプリングした
- これにより、Noneクラスの件数を極端に増やさずに、多様な負例をモデルへ提示できる
- ただし、epochごとにランダムに入れ替えるだけではhard negative miningとは限らない
- 現在のモデルが高いpositiveスコアを出した負例を優先的に選ぶ場合に、hard negative miningと呼べる
- また、学習時のクラス比率を変えること自体は禁止ではない
- クラス比率、サンプリング方法、クラス重みは、precision、recall、確率校正に影響するため、目的に合わせて検証する必要がある
損失関数の重みで調整
- epoch毎に入れ替えて調整する方法もあるが、損失関数側で重みで調整する方法もある
- 例えば、Positiveケースが少なく、Negativeケースが多い場合、あえてそのままで学習する
- しかし、損失関数側でPositiveの重みを$\frac{neg}{pos}$倍に調整して、Positive側を大きく調整することとする
- これによって、Positiveを学習しやすく、Negativeを学習しにくくし、影響をコントロールできる
- 少量のソースのサブクラスは普通にepochで全部学習さ、大量のソースのものはsamplingする形になる
ロスのクラスウェイト
- ロスのクラスウェイトは「そのサンプルが何クラスか」で重みを決る
- たとえば A:1%, B:99%なら、Aクラスはweight = 99、Bクラスはweight = 1
- つまり、Aはサンプルが少ないので、Aのサンプルなら簡単なAでも難しいAでも全部重くするイメージ
- データ数は変えず、少数クラス1件あたりのlossへの寄与を大きくする
- ロスのクラスウェイトにはサンプル数の逆数が使える
- lossの計算時にクラスごとの重みを掛けて調整する
Focal Loss
- クラス数そのものではなく、予測の難しさに応じて各サンプルのlossを調整する
- ロスのクラスウェイトと違い、Focal Lossは「そのサンプルをモデルがどれくらい簡単に当てられているか」で重みを変える
- 例
- 正解を99%確信している → ほぼ無視
- 正解を60%くらい → そこそこ重視
- 正解を10%しか出せない → 強く重視
- つまり、クラスではなく難易度を見る
- 少数クラスは学習が浅い段階では確信度が低い(=難しい)ことが多いため、Focal Lossはロスレベルで結果的にマイノリティクラスへ重みをかけることになる
- そのため、Focal Lossを使う場合はロスのクラスウェイトを併用してはいけない(重みが二重に乗ってしまうため)
ロスのクラスウェイトとFocal Lossの比較
| - | ロスのクラスウェイト | Focal Loss |
|---|---|---|
| 重みの基準 | クラス | サンプルの難しさ |
| 少数クラス | 直接重くする | 直接は関係ない |
| 簡単なサンプル | 少数クラスなら重いまま | 軽くする |
| 主な目的 | クラス不均衡対策 | Easy sample が大量にある問題への対策 |
まとめると、
- ロスのクラスウェイト:「少数クラスだから重要視」
- Focal Loss:「まだ上手く分類できないから重要視」
注意点として、不均衡データに対して既にロスのクラスウェイトで対応している場合、そこにFocal Lossを追加すると重みが二重に乗ってしまい逆効果になる。Focal Lossを使うなら、ロスのクラスウェイトは外す必要がある。
不揃いデータの学習方法
クラスごとの数が偏っている不均衡データとは別に、サンプルごとの難易度や質にばらつきがある不揃いなデータもある。この場合、いきなり全データを均等に学習させるより、まず粗く全体像を学習してから徐々に詳細や難しいケースに踏み込んでいく方が有効なことがある。
カリキュラム学習
- 人間が易しい問題から難しい問題へ順に学ぶのと同じように、モデルにも易しいサンプルから難しいサンプルへ順に学習させる手法
- いきなり難しい・ノイズの多いサンプルを学習させると、学習が不安定になったり収束が遅くなったりすることがある
- 「易しい」の基準はタスクによって様々で、ラベルの確信度が高い、サンプルサイズが小さい、ノイズが少ない、などが使われる
- 学習が進むにつれて、徐々に難しい・不揃いなサンプルの比率を上げていく
破滅的忘却(Catastrophic Forgetting)
- 段階的に学習を進める際、新しい(後段の)データばかり学習させると、以前学習した内容を忘れてしまう現象
- カリキュラム学習のように学習フェーズを分けたり、新しいドメインのデータを後から追加学習させたりする場合に起きやすい
- 対策
- 新しいデータだけでなく、古いデータも一定割合混ぜて学習を続ける(リハーサル)
- 学習率を下げて、既存の重みを大きく壊さないようにする
- 重要なパラメータの変化を抑制する正則化を加える
train
データを増量する時の注意
- 例えば、全体のデータ量を数倍にするのは一般的にやる方法
- ただし、Train中にあるカテゴリーが弱いからとそこだけ増やすと問題が発生する事が多い
- 発生するのは 「1カテゴリだけ拡張すると他が犠牲になる」問題
- ある少量のサンプルを過度に拡張すると、過学習が起きる
- つまり、データAugmentationなどをする場合は、もともとの多様性が重要ということ
- 言い換えると
- もともとのユニークなものが多い(多様性がある)=>増やしても偏らない=>全体的な底上げになる
- もともとのユニークなものが少ない=>増やすと偏り過学習になる=>り他のクラスも低下させる、もぐらたたきになる。
- 言い換えると、データ量とモデル容量の関係はもちろん容量の問題もあるが、データ量の多様性の問題もある
実験ログとdiscussionログを残す
実験に再現性と論理性、実論性、問題の真性を検証すためにいくつかの工夫が必要。
- フォルダ分けする
- 再現性のためexperimentsフォルダを切ってそこで作業する
- 例えば、
experiments/01_xxxみたいな形 - そこの中で完結するようにして、独立性を高める(例えば、過去の実験コードなどは使わない)
- 実行logなどは必ず全て保存する
- データドリブンでAIに開発させるのが目的
- データがあれば問題の再現性を検証できる
- AIにGuessさせない
- mdベースでissueについてdiscussionする
- 理由は、課題が再現しても(原因がわかっても)解決するべき本物の課題かを議論する
- 前提が間違っていたり、インパクトが小さかったり、実現可能性が引くい可能性もある
- issueの真因究明と本物の課題かどうかをまずは見極める
- mdベースでsolutionのdiscussionをする
- 解決策についてもmdでdiscussionする
- 特に課題の原因と価値が明らかになったら次は打ち手の検証が必要だから
- 打ち手についてもA vs Bのよう形で検証して結論を出してからsrcのコードに反映する
lossのトレンドの見方
- train lossとvalid lossがどちらもまだ下がっている場合は、epoch数を増やした方がいい
- 収束しきっていないのに学習を打ち切ると、伸びしろを捨てることになる
- wandbなどでlossを可視化して管理するべき
- 数値の羅列だけでは傾向がつかみにくく、グラフで見た方がトレンドが分かりやすい
- プラトー(lossがほぼ横ばいになっている状態)にいるかどうかを確認する
- プラトーに入っているなら、そのままepochを増やしても伸びない可能性が高い
val_lossの設計
- train lossだけを見ていると過学習に気づけないので、val lossが大切
- val_lossの計算をやりすぎると重くなるので、毎epochではなく数epochに一度でもいい
- 最終的にはtestで使うような指標でval_lossを評価するべき
- valとtestで見ている指標がズレていると、valが良くてもtestで期待通りの結果にならないことがある
Dropout
- trainで過学習を抑える目的で使う
- 非決定性の原因になりうるが、精度向上のためには入れるべき
- スパイスのようなもの——少し入れるだけで効いてくる
Focal Loss
- BCEだと、簡単な問題も難しい問題も同じように学習してしまう
- Focal Lossを使うと、難しい問題(誤分類しやすい/確信度が低い例)により大きなウェイトを置いて学習できる
- 簡単な問題の勾配を抑えることで、モデルの学習を難しい問題に集中させる
ゲート処理
- ブラックリスト方式ですべての不正入力を列挙するのではなく、条件を満たした入力だけを許可するホワイトリスト方式のゲートを設けた
- ゲート処理によって、OODや不適合入力が分類モデルまで到達する可能性を減らせる。その結果、False Positiveを抑えやすくなる
- 一方で、本来はpositiveである入力まで棄却するとFalse Negativeが増える
- そのため、ゲートの厳しさとcoverageのトレードオフを評価する必要がある
OODスコアを算出する
分類モデルのsoftmax確率だけでなく、入力が分布外である可能性を表すOODスコアを算出した。
OODスコアとしては、例えば次のようなものがある:
- MSP(Maximum Softmax Probability)
- softmax出力の最大値(Top-1クラスの確率)を確信度スコアとして使う、最も単純な方法
- しかし、全クラスへの反応が弱い入力でも比率さえ偏っていれば高い値が出てしまう(相対的なため)
- Energy Score
- softmaxを通す前のlogit(生の出力値)から計算するスコア
- logitの絶対的な大きさを反映して、「どのクラスにも強く反応していない入力」を検出しやすい
- IDならエネルギーが低く(負に大きく)、OODなら高くなる傾向
- 特徴空間における学習データからの距離
- 複数モデル間の予測の不一致
- OOD検出専用モデルの出力
OODスコアにしきい値を設定し、しきい値を超えた入力をOut of Scopeとして棄却する。
ただし、OODスコアは必ずしもOODである確率ではない。また、学習分布から明確に離れたfar-OODは検出できても、IDに近いnear-OODは検出が難しい場合がある。
マルチタスクで学習をする
- マルチタスク学習(Multi-task learning; MTL)が 有効な場合もある
- 補タスク(auxiliary tasks)の学習から得た教師信号をもとに興味がある主タスクの性能を向上することができるから
- あえて、gradeのheadもつけて学習させることによってauxiliary task learningができる
想定運用母集団に対する性能評価
- 固定データセットではなくリアルでどの程度使えるかを判断するため点推定ではなくCIで判断する
- 特に、固定済みモデルを、有限件のテスト標本で評価したことによる不確実性を測るのが目的
- そのため、次の指標のCIを測る
- None Recallの片側下限
- 各TargetクラスPrecisionの片側下限
- また、要求水準を「None Recall 99%以上」、信頼水準を95%として、二項CIで出した
- ただし、CIが測るのは主に標本誤差で、分布シフトまではカバーしないので注意
自動学習
- シンプルに精度が低いサブクラスは学習データを増やす方法
- サブクラスのカバー率とサブクラス学習効率を求めて、それに対して精度を比較する
- 精度が低いなら、そのサブクラスの割合を想定的に他のクラスより増やす
- これだけで自動学習が可能になる
対照学習
対照学習とは
- 教えるのが難しいものを、対照として用意して特別に学習させる方法
- つまり、ほぼ同じ条件の正解と誤答”を直接並べて、正解のスコアを必ず上にしろTrainする方法
- 例えば、「たろう」を分類するために、「XXXたろう」と「XXXたらう」みたいなpositive/negativeのpairを用意して学習する
- 普通の学習では、そのペア比較するべきペアだとわからないため、対照学習という方法がある
- そして、普通の学習とは別に、$score(Taro) > score(near-miss) + margin$というLossを入れる
- 実際は以下のような形
- $ReLU(2 - (logit_{pos}-logit_{neg}))$
- ちなみに、ReLUは、$ReLU(x) = max(0,x)$という関数
- つまり、positiveのlogitをnegativeのlogitより2以上高くしてくださいという事
- このPair Lossを使って学習をさせるイメージ
対照学習のPair Lossの具体例
差が1だとlossは罰になる:
| |
差が2.5だとlossは0になる(罰なし):
| |
つまり、差が開くと、「もう十分離れてる=学習できた」となるということ(この2がmargin)。
BCEとPair Lossの違い
- 一般的に二値分類の損失関数はBCE(Binary Cross Entropy=二値交差エントロピー)を使う
- positiveである確率は、$L=−[y log_p+(1−y)log(1−p)]$となる
- つまりBCEは次の仕組み
- y=1
- $-log_p$で、p=1なら0でlossなし
- y=0
- $-log_(1-p)$で、p=0ならばlossなし
- y=1
- しかし、これは結局は、y=1のラベルならpは1に近づき、y=0のラベルならpは0に近づく事を学習するに過ぎない
- 言い換えると以下を学習している
- positiveには「1を出せ」
- negativeには「0を出せ」
- 他方、対照学習は場合分けせずに、統合して(2つを比較して距離を)学習している
- 故に、対照学習は、次の力学が働く:
- Positive logit ↑ 上げる
- near-miss logit ↓ 下げる
- Binary Cross Entropyではなく、ReLUを使う理由がこれ
推論
Userの入力を狭める
任意の入力を完全に扱うという要件を見直し、システムが対応する入力の範囲を明確にした。
例えば、次のような条件を定義する。
- 対応するデータ形式
- 対応するクラス
- 必要な画像品質
- 許可するユーザーや利用環境
- モデルが判定してよい状況
ユーザーごとに対象データを登録または学習し、その範囲だけを判定対象にする方法も考えられる。
機械学習モデルの改善だけで安全性を確保しようとせず、モデルが動作してよい範囲をシステム側で定義することが重要だった。
判定しきい値を上げる
- positiveと判定するしきい値を上げる方法は、False Positiveを抑えるための単純で有効な方法である
- 一般には、しきい値を上げるとprecisionは上がりやすくなるが、recallとcoverageは下がる
- また、DNNは未知入力に対しても高いsoftmaxスコアを出すことがある。そのため、分類確率のしきい値だけに依存せず、OODスコアやゲート処理と組み合わせる必要がある
相対的な確信度を利用する
一つのクラスの確信度だけでなく、複数クラス間のスコアを比較した。
例えば、次のような値を利用できる。
- Top-1とTop-2の確率差
- Top-1とTop-2のlogit差
- 予測分布のエントロピー
- 複数モデル間の予測のばらつき
同じTop-1確率でも、他のクラスと僅差の場合と、一つのクラスだけが突出している場合では意味が異なる。
ただし、相対的な確信度は主に既知クラス間の曖昧さを表す指標であり、それだけでOODを検出できるわけではない。OOD入力に対して一つのクラスが突出することもある。
アンサンブルで判定する
複数のモデルを利用し、予測結果やモデル間の不一致を判定材料にした。
例えば、次のような方法が考えられる。
- 複数モデルの平均確率を使う
- すべてのモデルがpositiveと判定した場合だけ受理する
- モデル間の予測分散が大きい場合は棄却する
- 異なる特徴や学習データを使ったモデルを組み合わせる
アンサンブルは予測性能や不確実性推定を改善する可能性がある。
ただし、複数モデルが同じ学習データや特徴に依存している場合、同じ入力に対して同時に誤る可能性がある。アンサンブルだけで安全性を保証できるわけではない。
Selective Classification
確信度が不十分な場合に、モデルが無理に分類せず棄却できる仕組みを追加した。
棄却された入力については、次のようなフローへ移す。
- ユーザーに確認する
- 管理者によるレビューへ送る
- より高精度なモデルで再判定する
- 安全側のデフォルト処理を実行する
これはSelective ClassificationまたはClassification with a Reject Optionと呼ばれる考え方に近い。
棄却を増やせば受理した予測の精度は高めやすいが、自動処理できるcoverageは下がる。そのため、誤り率とcoverageの両方を評価する必要がある。
また、ユーザーへの確認を追加しても、ユーザー自身が正解を判断できなければ安全性は保証されない。誰が何を根拠に確認するかまで設計する必要がある。
事前確率を考慮する
クラスの発生頻度が学習時と運用時で異なる場合、運用環境の事前確率を考慮する方法がある。
Label Shiftを仮定できる場合、推論結果は次のように補正できる。
$$ P_{\mathrm{test}}(y \mid x) \propto P_{\mathrm{train}}(y \mid x) \frac{P_{\mathrm{test}}(y)} {P_{\mathrm{train}}(y)} $$ただし、この補正は主に次の仮定が成立する場合に利用できる。
$$ P_{\mathrm{test}}(x \mid y) = P_{\mathrm{train}}(x \mid y) $$運用環境の事前確率を正しく推定できない場合や、Concept Shiftも発生している場合には、単純な補正が逆効果になる可能性がある。
また、False PositiveとFalse Negativeのコスト差を反映したい場合は、事前確率補正とは分けて、コストを考慮した判定しきい値を設計する。
Conformal Prediction
- モデルフリーのConformal Predictionでしきい値や予測集合を統計的に較正し、自動判定、棄却を決めることも可能
- 各入力に対して予測集合を出し、長期的な誤り率が目標値以下になるよう較正する事が可能になる
- 普通の方法: 「0.9なら十分自信が高そう」、Conformal:「過去のNegativeの99%を誤判定しなかった境界を使う」というイメージ
- その前提として、キャリブレーションデータと本番データが同じような分布であることを前提にした長期的・集団的な保証ということ
- UQ解析の一種
モデル選定
タスクに適したモデルへ変更する
分類対象同士の違いが細かい場合は、Fine-grained classificationに適したモデルや学習方法を採用する。
例えば、車とペットボトルのような上位カテゴリ間の分類に比べ、タカとワシのように同じ上位カテゴリ内の下位カテゴリを区別する分類では、細かな局所特徴が重要になる。
この場合、次のような方法が考えられる。
- 高解像度の入力を使う
- 局所特徴や部位に注目するモデルを使う
- Metric LearningやContrastive Learningを使う
- 階層分類を行う
- タスク専用の特徴抽出器を利用する
Fine-grained classificationへの対応は既知クラス間の識別性能を改善する方法であり、それ自体がOOD対策になるわけではない。
転移学習を利用する
- 大規模データで事前学習されたモデルを利用し、対象タスクへFine-tuningする
- 事前学習によって得られた汎用的な表現は、限られた学習データだけで一から学習する場合よりも、分類性能や分布シフトへの頑健性を改善する可能性がある
- LLMにおけるLoRAは、事前学習済みモデルを少ない追加パラメータでFine-tuningするParameter-Efficient Fine-Tuningの一手法である。LoRA自体が転移学習と同義というわけではない
- また、転移学習を行ってもOODを必ず検出できるわけではないため、OODスコアや棄却処理とは別に考える必要がある
feedback
運用中の監視と再学習
開発時に想定できなかった入力は、運用開始後にも発生する。
そのため、次の情報を継続的に収集する。
- 棄却された入力
- 高い確信度で誤判定した入力
- モデル間で判定が分かれた入力
- ユーザーが訂正した入力
- 時間経過による入力分布の変化
収集したデータからhard negativeを発掘し、評価データの追加や再学習に利用する。
ただし、同じデータをしきい値調整と最終評価の両方に使うと、性能を過大評価する可能性がある。学習用、検証用、最終評価用のデータは分ける必要がある。
Check項目まとめ
量が多いので、AIにSVGにしてもらった。
また、簡潔にいうとこれらは最低限でもやったほうがいい:
- まず分母が同じ事
- 決定的なアルゴであること
- 非決定的なら信頼区間を出すこと
- 点推定ではなく信頼区間していること
- それらを細かなデータ区分でやること
- サンプル数があること
- 因果推論してること
- 統計的に有意なこと
- 論理的矛盾がないこと
- 証明されていること(truth and proof )
- 事前の仮説との整合性があること
- 交差検証されてること
- ホールドアウトで確認してること
- 未検証のデータセットを使ってること
- ドメインシフトが起こってないこと
- しきい値が一つじゃないこと(aucなどを使用)
- seedを変えたときの再現性があること
- 欠陥変数がないこと
まとめ
- ID/OODとpositive/negativeは別の概念として扱う必要がある
- DNNは未知入力に対しても高い確信度を出すことがあるため、分類確率のしきい値だけでは十分ではない
- False Positiveを抑えるには、入力ゲート、Noneクラス、疑似OOD、hard negative mining、OODスコア、アンサンブル、棄却などを組み合わせる必要がある
- Noneクラスや転移学習は有効な場合があるが、単独で未知入力全般に対応できるわけではない
- 安全性が重要なシステムでは、確信度が不十分な入力を無理に分類せず、人間による確認や安全側の処理へ移す設計が重要である
- 有限の評価データから、将来のあらゆる入力に対するFP 0件を保証することはできない
- FPだけを減らすとrecallやcoverageが低下するため、これらのトレードオフも評価する必要がある
- OODへの対処は単一のモデルや手法で完結するものではなく、入力制約、モデル、棄却、監視、再学習を含むシステム全体で設計する必要がある
OOD対策の本質は、すべての入力を無理に分類することではなく、モデルが判断してよい範囲を定め、判断できない入力を安全に棄却すること。
参考文献
- 機械学習におけるデータとデータソースの再考
- 機械学習におけるクラスとラベルの再考
- A Baseline for Detecting Misclassified and Out-of-Distribution Examples in Neural Networks
- Deep Anomaly Detection with Outlier Exposure
- Energy-based Out-of-distribution Detection
- ATOM: Robustifying Out-of-distribution Detection Using Outlier Mining
- Simple and Scalable Predictive Uncertainty Estimation using Deep Ensembles
- Can You Trust Your Model’s Uncertainty? Evaluating Predictive Uncertainty Under Dataset Shift
- SelectiveNet: A Deep Neural Network with an Integrated Reject Option
- Detecting and Correcting for Label Shift with Black Box Predictors
- Advancing Fine-Grained Classification by Structure and Subject Preserving Augmentation
- トップカンファレンスにおけるデータセットシフトと機械学習
- 論文紹介: Adapting Auxiliary Losses Using Gradient Similarity #機械学習 - Qiita
- Conformal Predictionで不確実性を定量化する #機械学習 - Qiita