目次
背景
- Dictionary-Constrained G2Pの辞書とデータ作成で進めている、LLMによる読み注釈付きデータの生成実験で、「学習データの量を増やしたら精度が上がった」という結果だけでは、それが対象を広げた効果なのか、同じ対象を厚く学習させた効果なのかが分からないという問題に直面した
- そこで、この2つの要因を分離して実験を進めるための、自分なりの設計の考え方を整理する。これは外部文献に基づくものではなく、今回の実験設計を考える中で固めた、自分の考察
全体多様性と部分多様性
定義
- 全体多様性(Coverage): 学習対象全体(語・target・reading groupなど)のうち、何%を学習データに含めるか。語彙・targetの広がりにあたる
- 部分多様性に近い指標として、Density(同じtarget/groupについて、どれだけ多くの用例・文脈を学習データに含めるか)という量を使う。targetあたりの文脈量にあたる
- ただし、Density=部分多様性と完全に同義ではない点に注意が必要。用例の数が多くても、似た文ばかりであれば実際の多様性は低いままなので、正確には「用例数(Density)を増やすことで、部分多様性が上がりやすくなる」という関係にとどまる
- そのため、実験設計上は「Coverage=語彙・targetの広がり」「Density=targetあたりの文脈量」と呼ぶのが、最も誤解が少ない
なぜ2軸に分けて考えるのか
- CoverageとDensityを、それぞれ独立に動かせるようにしておくことで、精度向上が「対象を広げた効果(全体多様性)」なのか、「同じ対象を厚く学習させた効果(部分多様性側の量)」なのかを分離できる
- 1軸の量(総文数など)だけを見ていると、この2つの効果が混ざった結果しか得られない
- 総文数はそのままLLM生成・学習にかかる時間やコストに直結するため、このマトリックスは、単に精度要因を分離するだけでなく、同じ総文数(≒同じコスト・時間)でどの組み合わせが最も精度を出せるか、つまり精度と時間・コストのトレードオフ(コスパ・タイパ)を測るための手法でもある
同じ「10%」でも、CoverageとDensityでは意味が違う
- 「データの10%を使う」という言い方は、実は一意に決まらない
- 全体のどこに対する10%なのかによって、実験として全く違う意味を持ってしまう
| 抽出方法 | targetの範囲 | targetあたりの文脈量 | Coverage | Density | 意味 |
|---|---|---|---|---|---|
| 全体からまんべんなく10%抽出 | 全target(100%) | 各targetを薄く | 100% | 約10% | 広く薄く。全部のtargetを少しずつ見る |
| ある部分(10%のtarget)から100%抽出 | 一部のtarget(10%) | その対象は全文脈 | 10% | 100% | 狭く濃く。一部のtargetを徹底的に見る |
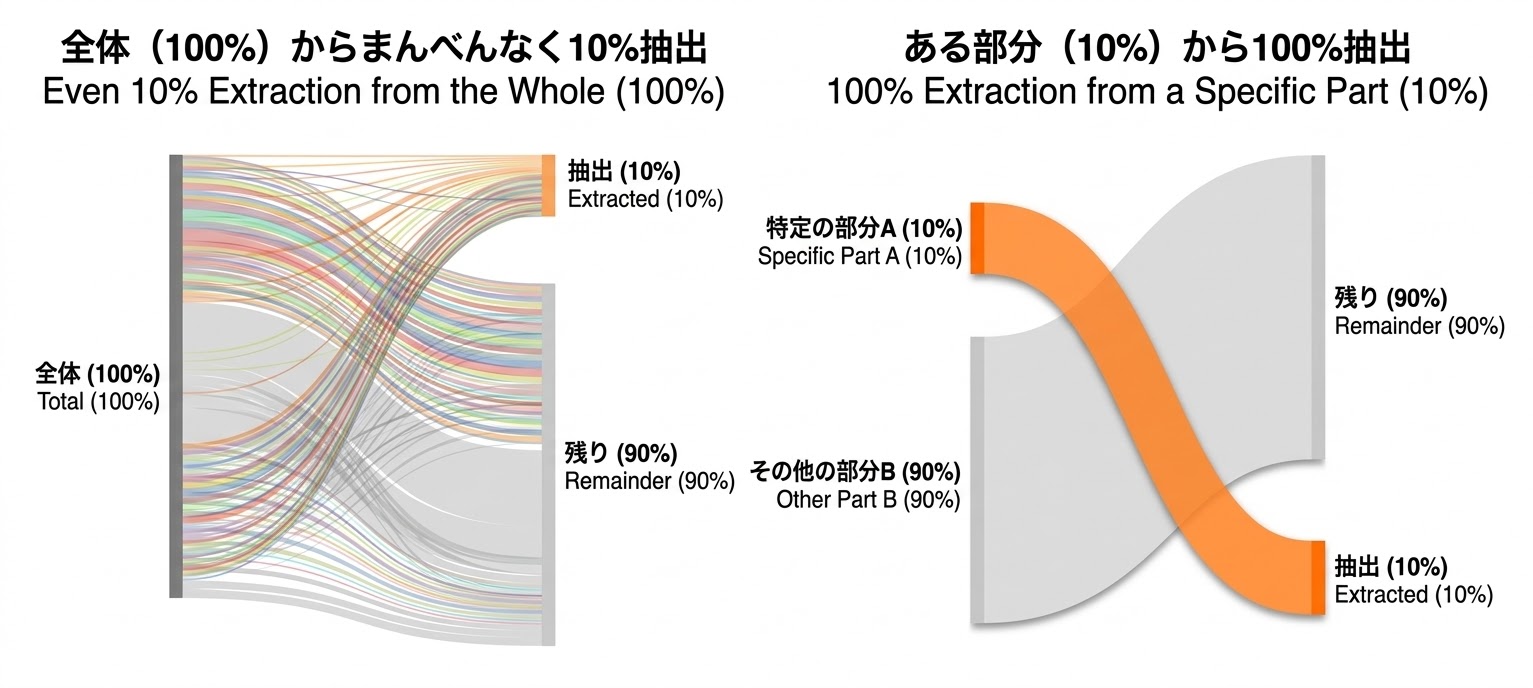
- 前者は全体多様性(Coverage)が確保される一方で部分多様性側の量(Density)が下がり、後者は逆にDensityが確保される一方でCoverageが下がるという、正反対の実験になる
- どちらも「データの10%」とは言えるが、実質的にはCoverageを10%にしたのかDensityを10%にしたのかで中身が全く異なる
- だからこそ、単に「データをX%間引く」とだけ言うのではなく、CoverageとDensityのどちらをX%にしたのかを明示する必要がある
Coverage × Density マトリックスで実験を整理する
基準となるDensityの段階
- 今回の実験では、論文相当のMono×15/Poly×30をDensity 100%として基準にする
- Densityは整数倍でなければならないため、実験で扱いやすい段階は以下のようになる
| Density | Mono | Poly |
|---|---|---|
| 100% | ×15 | ×30 |
| 33% | ×5 | ×10 |
| 13.3% | ×2 | ×4 |
| 6.7% | ×1 | ×2 |
Coverage × Density の12マス
- Coverage(1%・10%・100%)とDensity(6.7%・13.3%・33%・100%)を組み合わせると、以下のようなマトリックスになる
| Coverage ↓ / Density → | 6.7%(×1/×2) | 13.3%(×2/×4) | 33%(×5/×10) | 100%(×15/×30) |
|---|---|---|---|---|
| 1% | 超小規模 | 小規模 | 小規模 | 既存Phase Aから抽出可能 |
| 10% | 試せる | 試せる | 試せる | 今ここ(Phase A) |
| 100% | 有力 | かなり有力 | 高コスト | 超高コスト |
- 12マス全部を試すのはコストが高いため、まずは総データ量が近い組み合わせ(マトリックス上の斜め)に注目するのが効率的
斜めの比較が本質: 狭く濃く vs 広く薄く
- 現在進めているPhase Aは、Coverage 10% × Density 100%(Mono×15/Poly×30)にあたる
- Mono 142,352語・Poly 8,078語というfull母集団に対し、Density 100%の総文数は以下の通り
- 合計約2.38M文のうち、Coverage 10%にあたるPhase Aは約23.8万文に相当する
- これと総文数が近い組み合わせとして、Coverage 100% × Density 13.3%(Mono×2/Poly×4)を考えると
- 合計約32万文となり、Phase Aの約23.8万文とかなり近い総文数になる
- つまり、「約24万文を10%の対象に濃く使う(狭く濃く)」と「約32万文を100%の対象に薄く使う(広く薄く)」という、総文数をほぼ揃えた比較ができる
- 総文数がほぼ同じということは、LLM生成・学習にかかる時間やコストもほぼ同じということなので、この比較はそのまま「同じコスパ・タイパで、どちらの配分の方が精度が出るか」という問いになる
既存データから無料で作れる組み合わせ
- Phase Aには既にMono×15/Poly×30のデータがあるため、target単位・文単位で決定論的にsubsetすれば、新しいLLM生成なしで以下の組み合わせが作れる
- Coverage 1% × Density 100%
- Coverage 10% × Density 33%
- Coverage 10% × Density 13.3%
- Coverage 10% × Density 6.7%
最初に進める5点
- 12マス全部を一度に試すのではなく、まずは対角線と現在地を合わせた以下の5点から始めるのが効率的
| - | Density 6.7% | Density 13.3% | Density 100% |
|---|---|---|---|
| Coverage 1% | - | - | ● |
| Coverage 10% | ● | ● | ●(今ここ) |
| Coverage 100% | - | ● | - |
- この5点だけで、以下の3つの効果が見える
- Coverage 1%→10%(Density一定): 対象を増やすこと自体の効果
- Coverage 10%でDensity 6.7%→13.3%→100%: 同じ対象に何文必要なのかという、部分多様性側の量の効果
- Coverage 10% × Density 100%(狭く濃く)とCoverage 100% × Density 13.3%(広く薄く)の比較: 全体多様性と部分多様性、どちらが効くのかという本質的な比較
- 3つ目が最も重要で、Coverage 100% × Density 13.3%がPhase Aに勝てば、残り90%の対象をMono×15/Poly×30で大量生成する必要はほぼなくなる。逆にPhase Aが強ければ、同じ対象を複数文脈で厚く学習させることに意味があると分かる
考察
多様性と標準化
- ここまでのCoverage・Densityはどちらも「多様性」側の話だが、実験設計を考える上では、多様性の対極にある「標準化」という一般的な概念も合わせて理解しておくと整理しやすい
| 観点 | 多様性(Diversity) | 標準化(Standardization) |
|---|---|---|
| 目的 | できるだけ広く・多くのパターンをカバーする | 条件を揃え、比較・再現を可能にする |
| 増やすと起きること | 未知のパターンへの対応力(汎化性能)が上がる | 結果のブレが減り、比較の信頼性が上がる |
| 今回の実験での対応 | Coverage(対象の広がり)・Density(文脈の厚み) | 総文数・モデル設定・学習手順などを揃えること |
| 行き過ぎた場合の問題 | 何が効いたのか分からなくなる(交絡) | 現実の多様な状況に対応できなくなる(過学習・過適合) |
| 実験における役割 | 意図的に変える軸(独立変数) | 変えずに揃える軸(対照条件) |
- つまり、多様性は「意図的に変える軸」、標準化は「変えずに揃える軸」という、実験設計における正反対の役割を担う
- 今回のCoverage×Densityマトリックスで、総文数が近い組み合わせ(斜めの比較)を選んだのも、Coverage・Densityという多様性側の軸を動かす一方で、総文数という交絡要因を標準化しようとする試みだったと整理できる
メモライズと汎化、そしてgrokking
- もう1つの考察として、メモライズ(暗記)と汎化、そして多様性・標準化の関係について触れておく。ここは検証された結論ではなく、自分の考察
- ある対象(target)についてDensityを100%、あるいはそれ以上まで上げてデータを集めるというのは、その対象が持つ読み方のパターンを、個々の文として暗記させるのではなく、文脈を超えて成り立つ1つのクラス(規則)として暗黙的に学習させようとする試みに近いのではないか、という見方ができる
- これは、Power et al. (2022) “Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets”(arXiv:2201.02177)で報告されている、小さなアルゴリズム的データセットにおいて、訓練データを一旦完全に暗記(過学習)した後、さらに学習を続けることで、ある時点から急に汎化性能が立ち上がるgrokking現象とも重なる発想
- 覚えて終わる(メモライズで十分な)対象には多様性は不要で、汎化して未知の文脈にも対応しなければならない対象にこそ、多様性(Density・Coverage)が必要になる、という整理ができる
- 言い換えると、難しい対象を「クラス(規則)」としてではなく「個々のサンプル」として学習してしまっている状態から、文脈の多様性を量で与えることによって、サンプルの集合をクラスとして学習する方向へ押し出す、というのがDensity・Coverageを上げることの本質的な役割なのかもしれない
| 観点 | メモライズ(暗記) | 汎化(Generalization) |
|---|---|---|
| 対応する軸 | 標準化(Standardization) | 多様性(Diversity) |
| 学習の単位 | 個々のサンプル | サンプルの集合が示すクラス・規則 |
| 必要なデータ量 | 少数の典型例で足りる | 多様な文脈を量でカバーする必要がある |
| 対象の難易度 | 簡単な対象(パターンが単純) | 難しい対象(文脈依存・例外が多い) |
| 関連する現象 | 過学習(Overfitting) | grokking(過学習後に汎化性能が急に立ち上がる現象) |
- このように整理すると、Coverage×Densityの実験は、単なるデータ量の実験ではなく、「どの対象がメモライズで十分で、どの対象が汎化(多様性)を必要とするか」を切り分ける実験とも言える
明示的クラスと暗黙的クラス
- 前節の「サンプルの集合が示すクラス・規則」という言い方を、もう一歩具体化すると、クラス(規則)の与え方には明示的クラスと暗黙的クラスの2通りがあるという整理になる。これも自分の考察
- 明示的クラス: 「この語はこの文脈でこう読む」というルールやラベルを、人間(または辞書)が直接定義して与える方法。Dictionary-Constrained G2Pの辞書とデータ作成で使っているような、辞書エントリそのものが明示的クラスにあたる
- 暗黙的クラス: ルールを直接は与えず、同じ読み方のパターンを示す大量のサンプル(文脈)だけを与え、モデル側にそのサンプル集合が暗黙に示す規則を推測させる方法。Density・Coverageを上げてデータを集めるのは、この暗黙的クラスを学習させるための手段にあたる
| 観点 | 明示的クラス | 暗黙的クラス |
|---|---|---|
| クラスの与え方 | ルール・ラベルとして直接定義する | サンプルの集合から推測させる |
| 必要なデータ量 | 少ない(ルール自体が情報を持つ) | 多い(サンプルの数・多様性がルールの代わりになる) |
| メンテナンス | ルールの追加・修正を人手で行う必要がある | 新しい文脈のサンプルを追加するだけでよい |
| 未知の例外への対応 | ルールの外の例外には対応できない | 学習データに含まれていれば吸収できる可能性がある |
| 今回の実験での対応 | 辞書エントリ(Dictionary-Constrained) | Density・Coverageを上げたサンプル集合 |
- つまり、Dictionary-Constrained G2Pというアプローチ自体が、「辞書という明示的クラス」と「LLM生成データという暗黙的クラス」を組み合わせる設計になっている
- 辞書でカバーしきれない、文脈依存の読み分けのような部分を、サンプルの多様性(暗黙的クラス)で補おうとしている、と整理できる
まとめ
- 全体多様性(Coverage)は学習対象全体のうち何%を学習データに含めるかという、語彙・targetの広がり
- 部分多様性に近い指標としてDensity(targetあたりの文脈量)を使うが、Density自体は用例数であり、その中で文脈がどれだけ実際に散っているかという意味での部分多様性とは厳密には同義でない
- Coverage×Densityの2軸に分けて実験を整理することで、精度向上が対象を広げた効果か、同じ対象を厚く学習させた効果かを分離できる
- 総文数はLLM生成・学習の時間やコストに直結するため、このマトリックスは精度要因の分離だけでなく、精度と時間・コストのトレードオフ(コスパ・タイパ)を測る手法でもある
- 基準をMono×15/Poly×30(Density 100%)とし、整数倍になる33%・13.3%・6.7%という段階を使うと、実験で扱いやすい
- 既存のPhase A(Coverage 10% × Density 100%)のデータから決定論的にsubsetするだけで、Coverage 1% × Density 100%やCoverage 10% × Density 33%/13.3%/6.7%が、追加のLLM生成なしで作れる
- まずは対角線+現在地の5点(Coverage 1% × Density 100%、Coverage 10% × Density 6.7%/13.3%/100%、Coverage 100% × Density 13.3%)から始め、特にCoverage 10% × Density 100%(狭く濃く)とCoverage 100% × Density 13.3%(広く薄く)という、総文数をほぼ揃えた比較が最も重要になる
参考文献
- Dictionary-Constrained G2Pの辞書とデータ作成
- 実験駆動開発
- Power, A., Burda, Y., Edwards, H., Babuschkin, I., & Misra, V. (2022). “Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets” (arXiv:2201.02177)