目次
背景
- 学習の汎化性能をチェックするのにホールドアウトや交差検証は必須
- 単純にデータをTrain/Testに1回だけ分割するhold-out法は、手軽だが、たまたまその分割が簡単(または難しい)だった場合に、性能推定が偏ってしまう
- 特にデータが少ない場合、1回の分割で評価に回すサンプルを減らすと、TrainもTestも情報が不足する
- 交差検証(Cross-Validation)は、分割を複数回変えて評価を繰り返すことで、性能推定の分散を抑える手法群
- 一口に交差検証といっても、データの性質によって適した種類が異なるため、ここで整理する
交差検証
交差検証とは
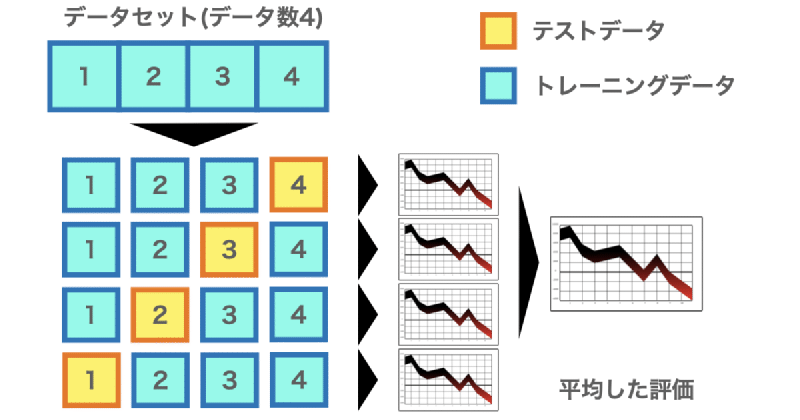
- クロスバリデーション(交差検証)とは、学習用のデータを複数の分割パターンで学習データと検証データに分けてモデルの汎化性能(未知のデータに対する予測能力)を検証すること
- 分割した学習データで学習し、検証データで予測し精度を検証する
- 複数の分割パターンで検証を行うことでより正確なモデルの精度を測ることができる
NOTE: 以降、「Test」という言葉はK-Fold内で一時的にholdoutするデータを指すのに使うことがあるが、これは機械学習におけるデータセットの分割の再考で定義した「一度もモデル改善に使わないBlindなTest」とは別物。CVの中で繰り返し使われるholdoutは、本来はValidationと呼ぶ方が正確で、混乱を避けやすい
スプリットとホールド
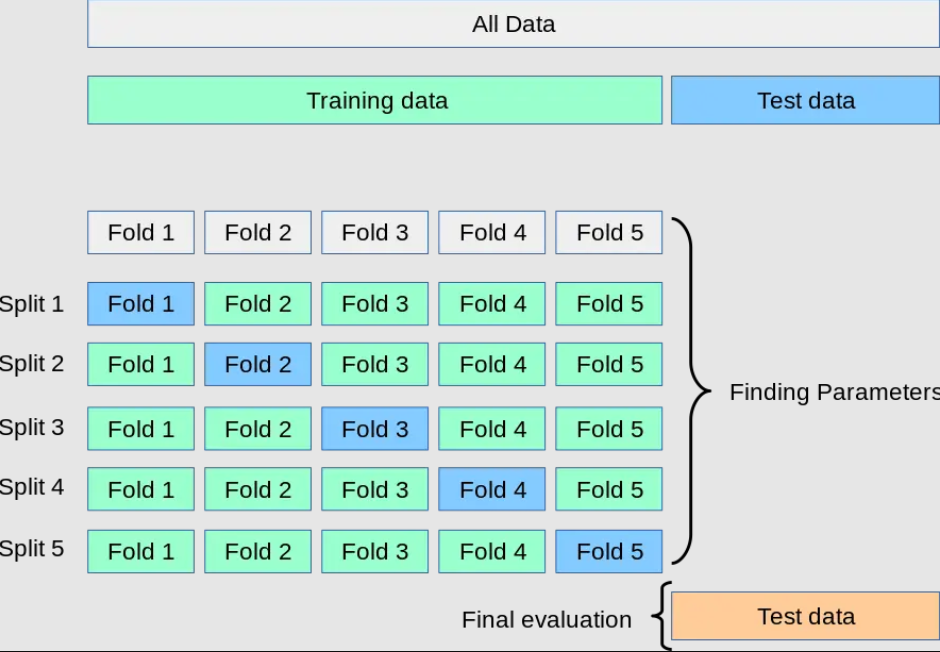
- Fold:データを固定的にいくつかのグループに区切った「部品」そのもの
| |
- Split:そのFoldを使って、TrainとValidationをどう組み合わせるかという1回分の試行
| |
- K-Fold系の手法は、先にFoldを固定してから、それを使ってSplitを作る
- 一方、後述のShuffle Split系の手法は、固定されたFoldを持たず、毎回ランダムにSplitだけを作る。この違いを押さえておくと、両者の違いが分かりやすい
5-fold CVの例
たとえば5-fold CVなら、データを5つのFoldに分ける。
| |
そして各回で、1つをValidation、残り4つをTrainにする。
| |
つまり、元データ全体を5つのFoldに分けて、その中から毎回TrainとValを作る。
OOF予測(Out-of-Fold Prediction)
- 標準的なCVの手順は、CVでハイパーパラメータなどを決めた後、Train全体で改めて1つのモデルを再学習し、最後にTestで一度だけ評価する、という流れになる
| |
- これとは別に、実務(特にKaggleのようなコンペティション)でよく使われるテクニックとして、OOF(Out-of-Fold)予測がある
- 各foldでそのfoldをValidationにしてモデルを学習する際、そのValidation部分に対する予測値を記録しておく
- $k$回のCVが全て終わると、Train全体の各サンプルについて、「そのサンプルの学習には使われなかったモデルによる予測値」が1件ずつ揃う。これがOOF予測
- OOF予測は、Trainのどのサンプルも、それを学習していないモデルによる予測になっているため、Train全体に対するunbiasedな(リークのない)予測値として扱える
- 主な用途
- スタッキング(Stacking): OOF予測を、次段のメタモデルの学習入力として使う
- CV全体の性能を1つのスコアにまとめて評価する(foldごとのスコアの単純平均よりも、サンプル単位で再現した方が正確な場合がある)
- 似て非なる手法として、$k$個のfoldで学習した$k$個のモデルを、Test(未知データ)に対してアンサンブル(予測を平均)することがある
- これはOOF予測ではなく、学習済みモデル群を使った推論時のアンサンブルであり、CVの手順そのものに必須の処理ではない
K-系
k-分割交差検証(k-Fold Cross-Validation)
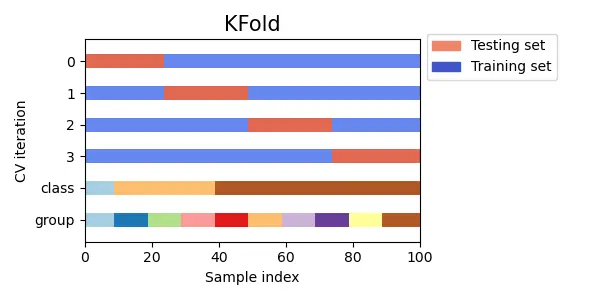
- データを$k$個のfoldに分割し、$k-1$個をTrain、残り1個をValidationとして評価するのを、Validationにする部分を入れ替えながら$k$回繰り返す
- 最終的な性能は、$k$回の評価の平均(と分散)として報告する
- $k=5$や$k=10$がよく使われる
- Validationに使うfoldが毎回入れ替わるため、hold-out法より少ないデータロスで、全サンプルを1回ずつValidationとして使える
Stratified k-Fold(層化k分割交差検証)
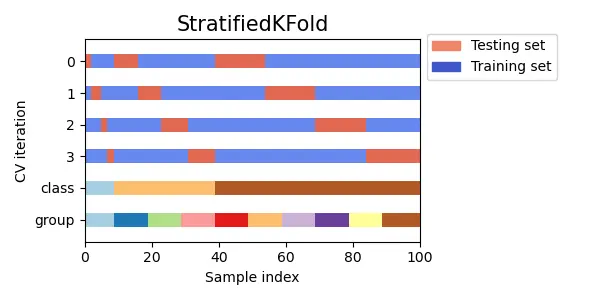
- クラス比率が偏っているデータでは、単純にランダムにfold分割すると、あるfoldにだけ少数クラスが集中してしまうことがある
- Stratified k-Foldは、各foldでのクラス比率が元データの比率をほぼ維持するように分割する
- 機械学習におけるデータとデータソースの再考で触れたstratified splitのk-Fold版
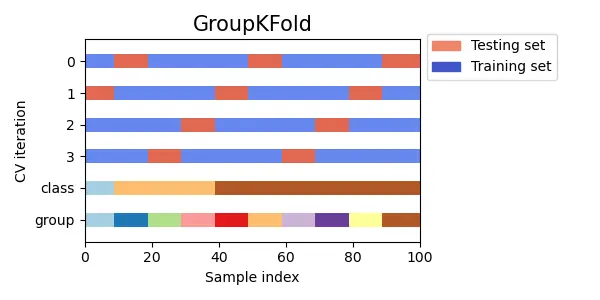
Group k-Fold
- 同じ患者・同じユーザー・同じデバイスから複数のサンプルが取られているデータでは、単純なランダム分割だと、同じグループのサンプルがTrainとValidationの両方に紛れ込むことがある
- この場合、モデルはそのグループ固有の特徴(患者の個人差など)を学習してしまい、Validationでの性能が実際の汎化性能より高く出る
- Group k-Foldは、同じグループに属するサンプルが必ず同じfold(同じTrainまたは同じValidation)に入るように分割する
- これは機械学習におけるデータとデータソースの再考で触れた「元データソースを分ける」という独立性の要求を、fold分割のレベルで実現したものと言える
Shuffle Split系
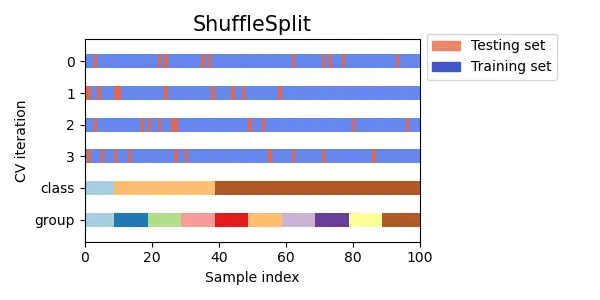
Shuffle Split
- ShuffleSplitは、K-Fold系と違って固定されたFoldを作らない。指定した回数だけ、毎回データ全体からランダムにサンプリングしてTrain/Validationを作り直す
| |
- 1回のSplit内では、Train集合とValidation集合は重複しない($\text{Train} \cap \text{Validation} = \emptyset$)
- 重複や偏りが起こりうるのはSplitをまたいだ場合で、同じサンプルが複数回Validationに選ばれることもあれば、一度もValidationに選ばれないサンプルが残ることもある
- K-Foldのようにデータ全体を重複なく分割しているわけではないので、分割回数とTrain/Validationの比率を自由に調整できる
Group Shuffle Split
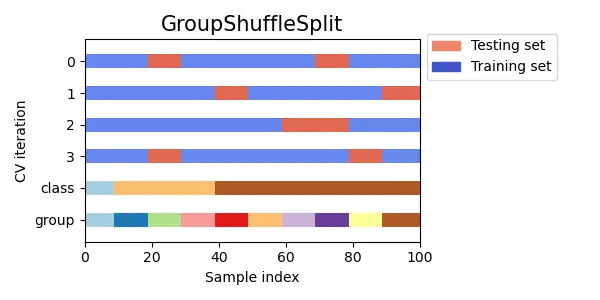
- Group Shuffle Splitは、Shuffle Splitの考え方をグループ単位に拡張したもの
- Shuffle Split: サンプル単位でランダムにTrain/Validationへ分割する。同じ人・同じ企業・同じ患者のデータが、TrainとValidationの両方に入る可能性がある
- Group Shuffle Split: グループ単位でランダムにTrain/Validationへ分割する。同じグループがTrainとValidationにまたがることはない
| |
- 1回のSplit内では、同じグループ(例えばAさん)の一部がTrain、別の一部がValidationに分かれることはない
- ただしSplitをまたぐと、Aさんのデータが「Split1ではTrain、Split2ではValidation」のように役割を変えることはある
- つまりShuffle Splitが「サンプル単位のランダム分割」、Group Shuffle Splitが「グループ単位のランダム分割」という理解でよい
Leave-XXX
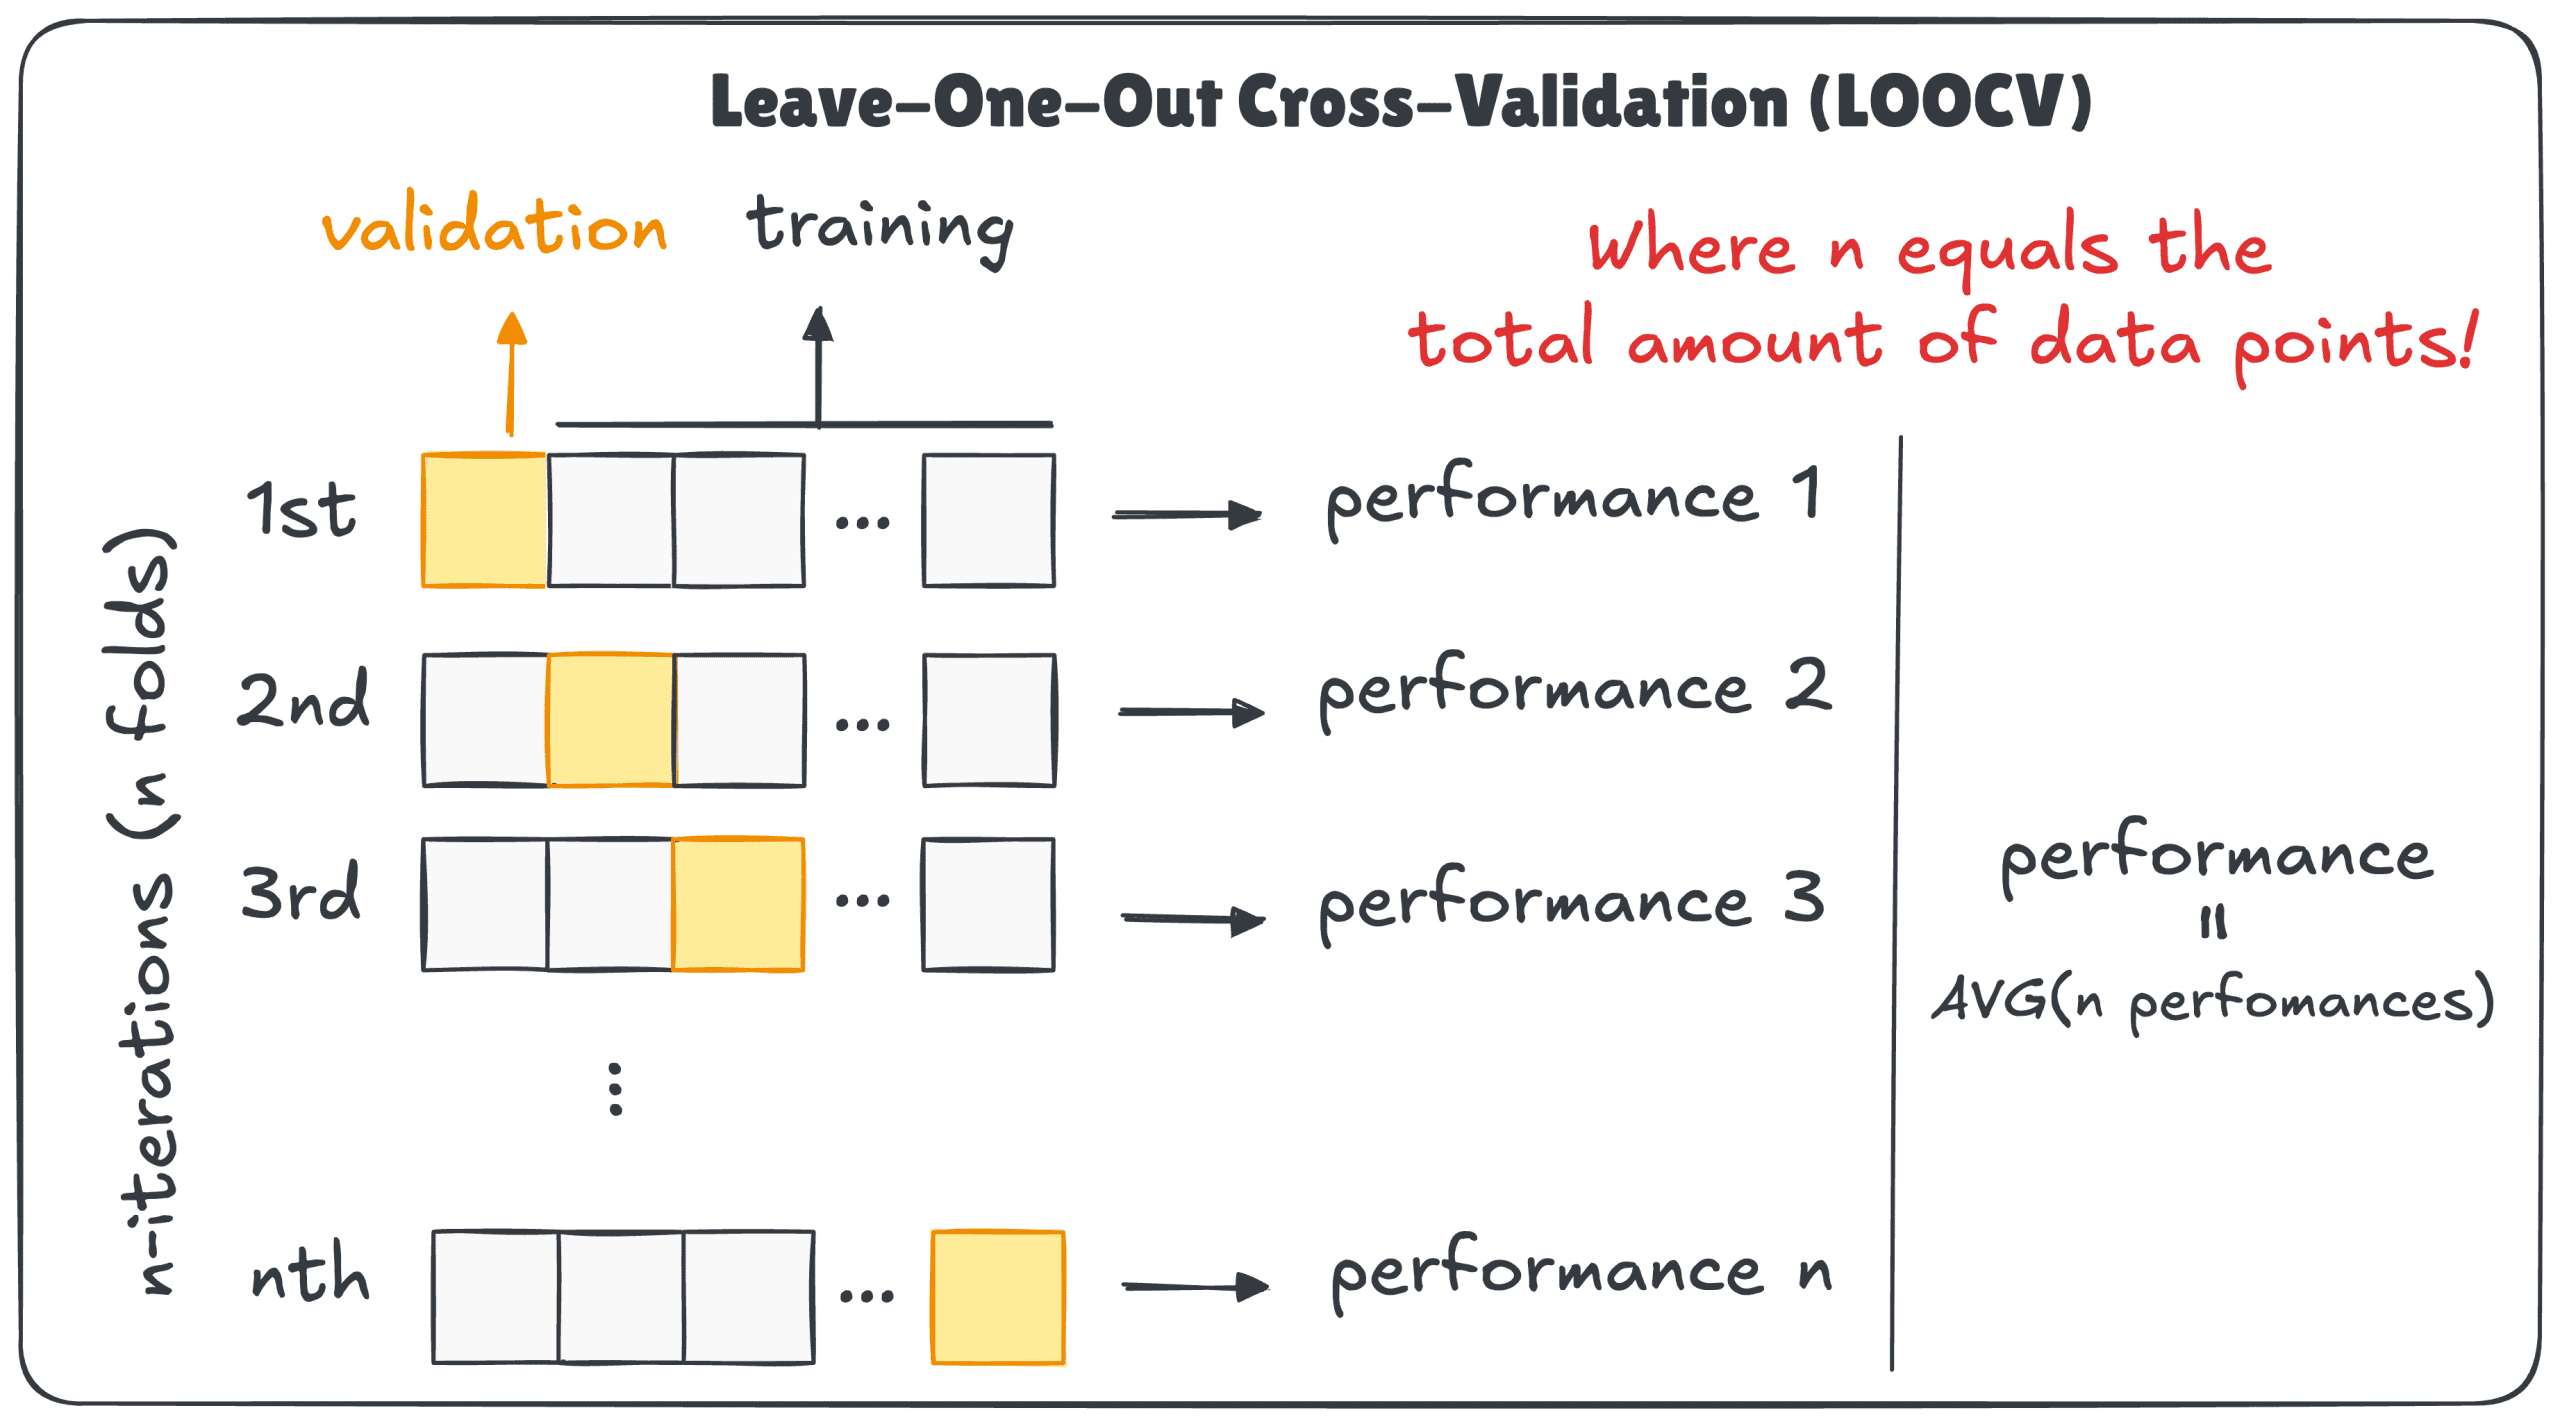
Leave-One-Out(LOOCV)
- $k=n$(サンプル数)とした、k-Foldの特殊ケース
- 1サンプルだけをValidationにして、残り全部をTrainにするのを、全サンプル分繰り返す
メリット:
- 毎回$n-1$件をTrainに使えるため、データが極端に少ない場合でも学習データを無駄にしない
デメリット
- $n$回モデルを学習させる必要があり、$n$が大きいと計算コストが高い
- Trainセット同士がほぼ同じデータ(1件しか違わない)になるため、$k$回の評価結果が互いに強く相関し、平均の分散が見かけ上小さく出ることがある
- モデル選択(ハイパーパラメータ探索)にLOOCVを使い回すと、小さなデータに対して過度にモデルを適合させてしまうリスクも指摘されている(Cawley & Talbot, 2010)
Leave-P-Out(LPOCV)
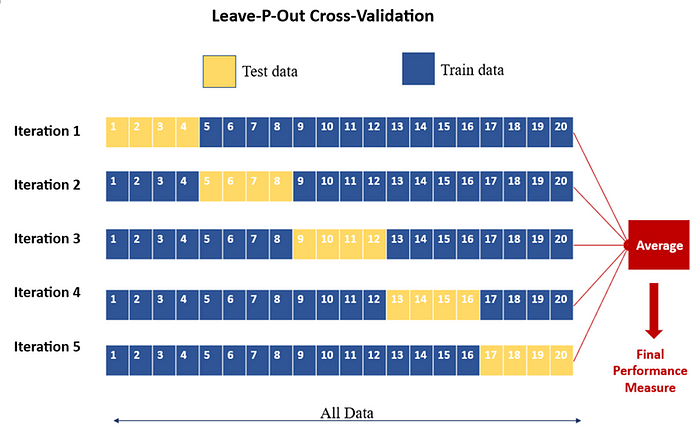
- LOOCVを一般化し、1件ではなく$p$件をValidationとして抜き出すのを、全ての組み合わせで繰り返す手法
- 組み合わせ数は$\binom{n}{p}$になるため、$p$が2以上になると急速に計算量が増え、実務ではあまり使われない
- $p=1$の場合がLOOCVに一致する
5×2交差検証
- $k$-Foldを1回行うだけでは、fold分割そのものの偶然性が結果に残る
- 5×2交差検証は、データを2分割してTrain/Validationを入れ替える2-Fold CVを、分割の仕方を変えて5回繰り返す(合計10回の評価)。これはあくまでデータの分割方法そのものの話
- マクネマー検定でモデル比較の有意差を検定するで触れた5×2 cvペアードt検定は、この5×2交差検証の結果を使って、2つのモデルの性能差を検定する、別の統計的検定の手法
- 「分割の偶然性による誤検出を抑える」効果は、5×2交差検証という分割方法そのものというより、その結果を使ったペアードt検定という検定手法に由来する。「5×2 CV」(分割方法)と「5×2 CV paired t-test」(検定方法)は分けて理解するとよい
Nested Cross-Validation
- ハイパーパラメータ探索と、最終的な性能評価の両方に同じ交差検証を使い回すと、分布外データの対処方法で触れたWinner’s Curseと同じ問題が起きる
- つまり、複数のハイパーパラメータ候補を同じ検証データで比較して一番良いものを選ぶと、選ばれた候補の評価値は本来の実力より楽観的に偏る
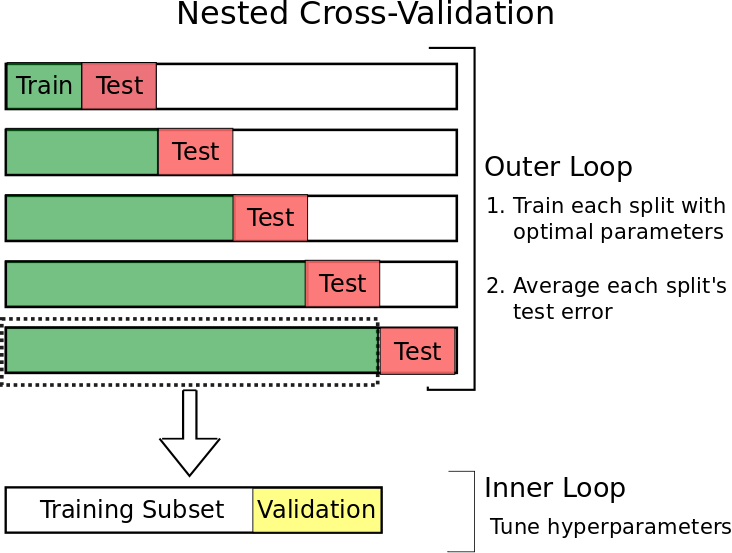
- Nested Cross-Validationは、これを避けるために交差検証を二重にする
- 外側のループ: 性能評価のためのTrain/Testの分割
- 内側のループ: 外側のTrain部分の中だけで、ハイパーパラメータ探索のための交差検証を行う
- 内側でハイパーパラメータを選び、外側のTestは一度もハイパーパラメータ探索に使わないため、性能評価が楽観的に偏りにくい
- 計算コストは、外側$\times$内側の分割数だけモデルを学習する必要があり、通常のk-Foldよりかなり高くなる
時系列データでの交差検証
- 時系列データでは、通常のk-Foldをそのまま使うと問題が起きる
- 未来のデータでTrainし、過去のデータでTestするような分割が発生しうるため、本来知り得ないはずの未来の情報がTrainに紛れ込む(リーク)
- Walk-Forward Validation(時系列分割)では、常に「過去をTrain、未来をTest」という時間順序を守ったまま、Testの範囲を時間方向にずらしながら繰り返す
| |
- Trainの範囲を固定せず、常に直近までを含めて広げていく方式と、一定の窓幅でスライドさせる方式がある
まとめ
- 交差検証は、hold-out法の分割の偶然性による性能推定のブレを抑える手法群
- K-Fold系は先にFoldを固定してからSplitを作るのに対し、Shuffle Split系は固定Foldを持たず毎回ランダムにSplitを作る、という違いを押さえると整理しやすい
- k-Fold CVが基本形で、クラス比率を保つStratified k-Foldとセットで使われることが多い
- CVの中で繰り返し使われるholdoutはValidationと呼び、一度だけBlindに使う最終評価用のTestとは区別する
- OOF予測は、各foldのValidation予測を集めてTrain全体に対するunbiasedな予測を作るテクニックで、スタッキングなどに使われる。Testに対する複数モデルのアンサンブルとは別物
- LOOCVはk=nの特殊ケースで、データが少ない場合に有効だが、計算コストと評価結果の相関に注意が必要
- 5×2交差検証はデータの分割方法そのもので、5×2 cvペアードt検定というモデル比較の統計的検定と組み合わせて使われる。両者は別物として区別する
- Nested Cross-Validationは、ハイパーパラメータ探索と性能評価を分離し、Winner’s Curseのような楽観バイアスを避ける
- 時系列データ・グループ構造を持つデータでは、通常のランダム分割ではなく、時間順序やグループの独立性を守った専用の分割方法が必要
参考文献
- Kohavi, R. (1995). “A Study of Cross-Validation and Bootstrap for Accuracy Estimation and Model Selection”
- Cawley, G. C., & Talbot, N. L. C. (2010). “On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation”
- Dietterich, T. G. (1998). “Approximate Statistical Tests for Comparing Supervised Classification Learning Algorithms”
- マクネマー検定でモデル比較の有意差を検定する
- 分布外データの対処方法
- 機械学習におけるデータとデータソースの再考
- クロスバリデーション(交差検証)についてわかりやすく解説 | 化学とインフォマティクスと時々雑記
- The Art of Model Validation in Machine Learning: Cross-Validation | by Mustafa Erboga, Ph.D. | Academy Team | Medium
- Time Series Nested Cross-Validation | by Courtney Cochrane | TDS Archive | Medium
- kaggleでよく使う交差検証テンプレ(Keras向け)
- 3.1. Cross-validation: evaluating estimator performance — scikit-learn 1.9.1 documentation
- What Is Cross-Validation? A Plain English Guide with Diagrams - KDnuggets