目次
背景
- ワールドモデルについて理解していなかったので、Youtubeで学習していた
- ワールドモデルとは、人工知能(AI)が現実世界の仕組みや物理法則を理解し、行動の結果を予測できるようにするための設計思想
- その中で引用されていたいくつかの論文についてAIに要約してもらった
- 動画の中で特に印象に残ったのは以下など
- モラベックのパラドックスで(人間にとって簡単な事こそロボにとっては難しい事)
- inferenceをenergy関数で実装するというアイディア
Intelligence is not what you know, it’s what you do when you don’t know.
- JEPAのアイディア
論文同士の繋がり
- 今回サーベイする論文・著作は、いずれもLeCun (2022)を直接・間接の起点にしている
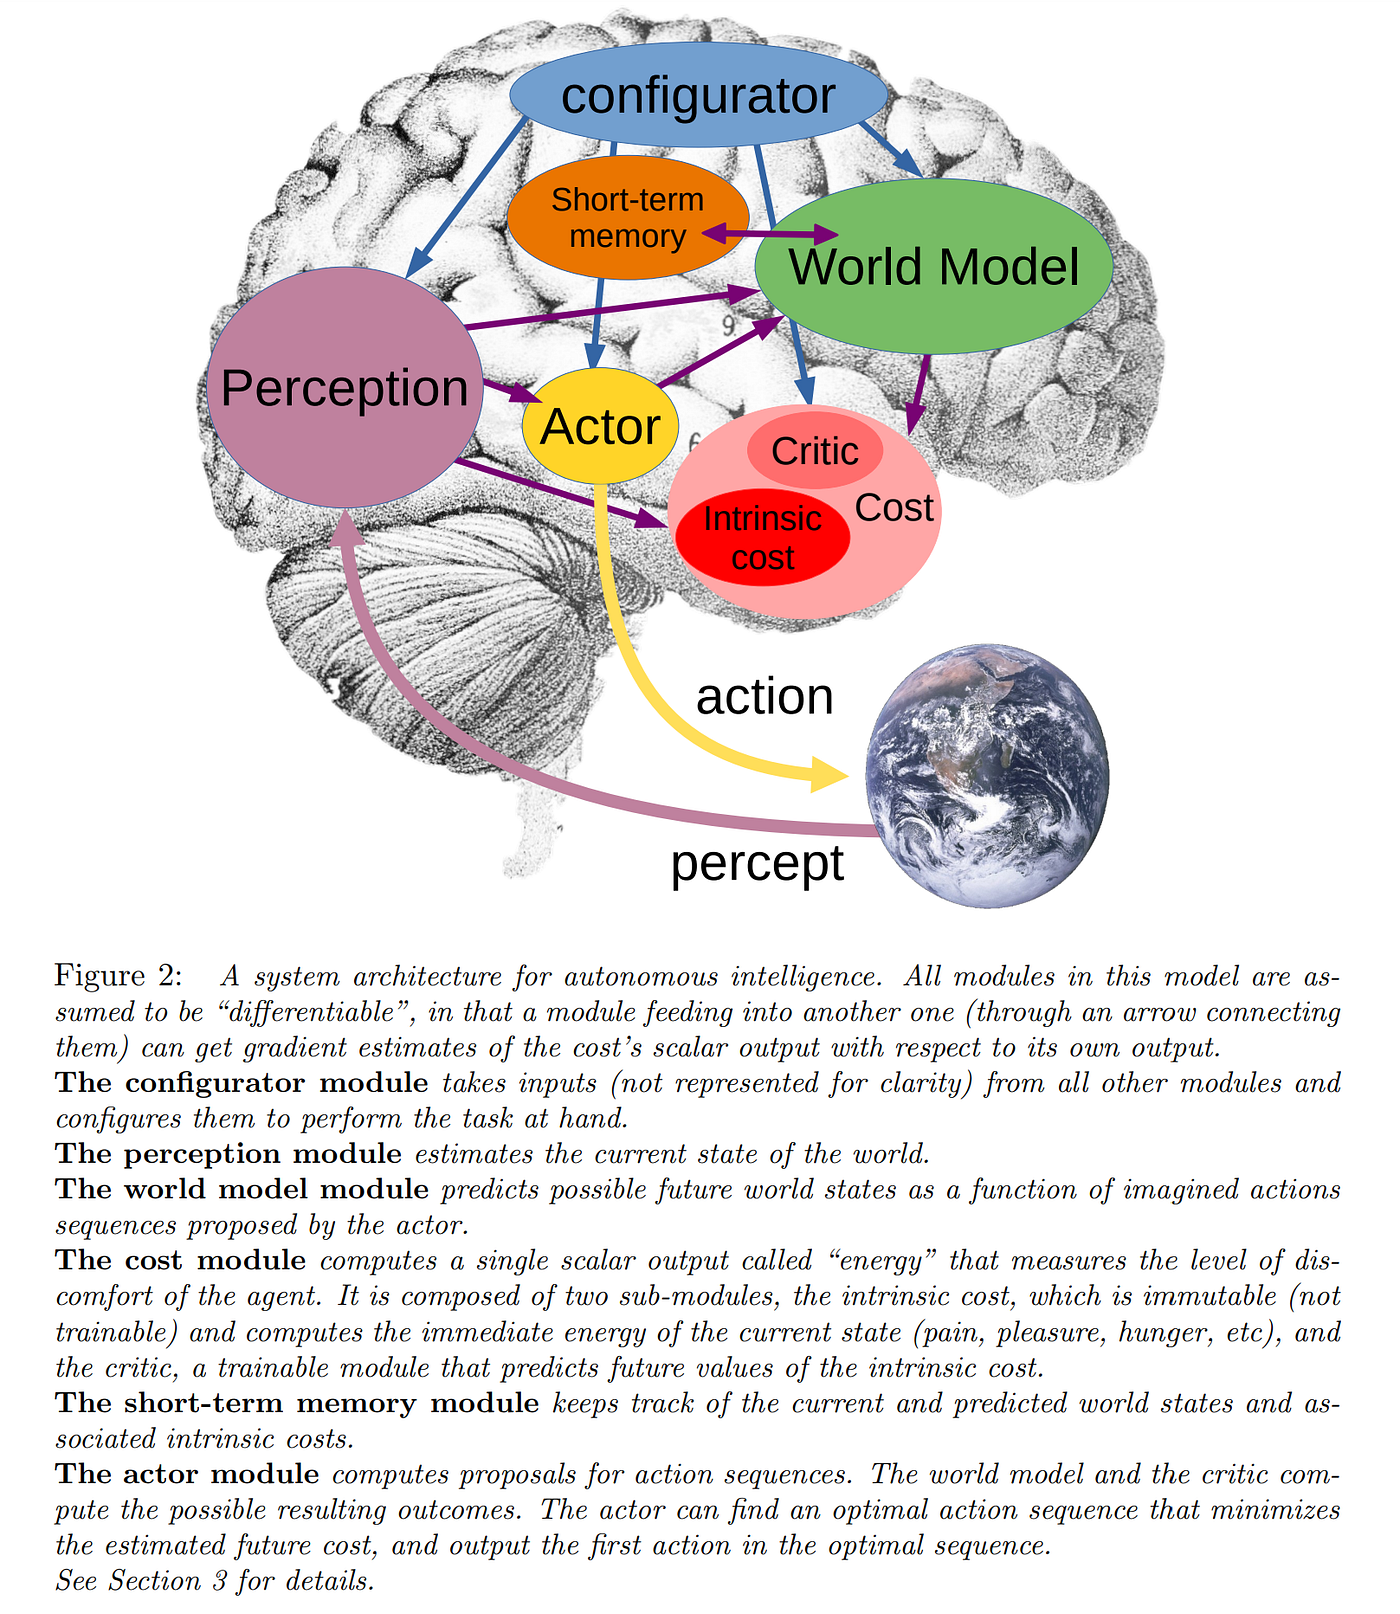
- LeCun (2022): Perception・World Model・Actor・Critic・Configuratorという全体のアーキテクチャを提案した、起点となるポジション論文
- Stanovich & West (2000) / Kahneman: LeCun (2022)がActorのMode-1・Mode-2を区別する際に着想を得た、認知科学側の背景にあたる研究
- Assran et al. (2023, I-JEPA): LeCun (2022)が構想したJEPAを、画像に対して初めて具体的に実装した論文
- Dawid, LeCun (2023): LeCun (2022)のWorld Model部分を、EBM・JEPA・H-JEPAという技術的な枠組みでより詳しく掘り下げた論文
- Gladstone et al. (2024, EBWM): Dawid, LeCun (2023)の「推論=エネルギー最小化」を、推論時のMCMCによる反復的な洗練として具体化した論文
- Balestriero, LeCun (2025, LeJEPA): Dawid, LeCun (2023)のヒューリスティックなCollapse防止を、SIGRegという理論的な正則化手法に置き換えた論文
- Dupoux, LeCun, Malik (2026): LeCun (2022)のConfiguratorを、System Mという自律学習のための具体的なメタ制御機構に発展させた論文
- Goldfeder, Wyder, LeCun, Shwartz Ziv (2026): LeCun (2022)のAGIを避ける立場を引き継ぎ、JEPA・World Modelを技術的な手段として、専門化を通じた超人的適応知能(SAI)を提案した論文
- 引用・参考関係を図にすると以下の通り
| |
LeCun (2022) “A Path Towards Autonomous Machine Intelligence”
概要
- 後続の論文群(System A/B/M、EBM/JEPA、SAI)がいずれも土台にしている、LeCun自身によるポジション論文
- AGIという言葉を避け、人間の知能も含めて動物の知能は専門化されたものであり、汎用的ではないという立場を取っている(Goldfeder et al. 2026のSAIの議論の先取りにあたる)
- 学習・推論・計画を組み合わせた自律的な知能エージェントのためのアーキテクチャと、学習パラダイムを提案している
モジュール構成
- Configurator: タスクに応じて他のモジュールを設定する、実行制御にあたる最上位のモジュール。目的の設定、知覚のうち注目すべき部分の選択、ActorやCriticの動作モードの調整などを担う
- Perception: 感覚入力を処理し、世界の現在の状態を推定する
- World Model: 知覚だけでは得られない世界の状態の欠落部分を補い、仮定した行動に対して、将来の世界の状態を予測する
- Cost module: エージェントの現在・予測される状態の「不快さ」をスカラー値で表す。あらかじめ固定されたIntrinsic Cost(痛み・飢えなどの基本的な欲求を表す、変更されないモジュール)と、将来のIntrinsic Costを予測できるよう学習されるCriticに分かれる
- Actor: World Modelを使って複数の行動系列をシミュレーションし、予測されるコストを最小化する行動を計算する。モデル予測制御(Model Predictive Control)に近い発想
- Short-Term Memory: 過去・現在・将来の状態とコストに関する情報を保持し、Criticの学習などに使われる
行動のモード
- 即時に反応するMode-1(反射的・単純な行動)と、World Modelを使って複数ステップ先までシミュレーションしながら計画するMode-2(熟慮的な行動)という、2つの動作モードを区別している
- この区別は、カーネマンのシステム1・システム2の区別に着想を得ている(詳細は本記事のStanovich & West・Kahnemanのセクションを参照)
- 後続のDupoux, LeCun, Malik (2026)のSystem Mにおける「習慣的行動と目標志向行動の切り替え」も、この区別の延長線上にある
World ModelとしてのJEPA
- World Modelは、自己教師あり学習によって訓練されることを前提としている
- ピクセル単位の生成的な予測ではなく、学習された表現空間で予測するJEPAという設計を提案しており、この部分はDawid, LeCun (2023)で詳細に展開されている
- 単一階層のJEPAではなく、複数の抽象度のレベルを持つH-JEPAによって、短期的な詳細な予測と長期的な抽象的な予測の両方、および階層的なプランニングを可能にすることを目指している
Stanovich & West (2000) と Kahneman: System 1・System 2の起源
Stanovich & West (2000): 用語の初出
- Stanovich, K. E., & West, R. F. (2000) “Individual difference in reasoning: implications for the rationality debate?"(Behavioral and Brain Sciences, 23(5), 645-726)が、「System 1」「System 2」という用語そのものの初出
- System 1(別名、暗黙的処理): 速く自動的で、強い情動的な結びつきを持ち、使う認知資源が少なく、習慣に基づくため変更・操作が難しい
- System 2(別名、明示的処理): より遅く可変性が高く、意識的な判断・態度によって動き、進化的に新しく人間に特有だとされ、逐次的な思考を行うが容量に限りがある
- 論文自体は、人間の推論における個人差と、それが「人間は合理的か」という論争に持つ含意を論じたもので、2つの処理システムの区別そのものが主題ではなく、その区別を使って個人差を説明する内容になっている
Kahneman (2003 / 2011): 直感と推論、そしてSystem 1・System 2への改称
- Kahneman, D. (2002年のノーベル賞受賞講演、2003年にAmerican Economic Reviewに掲載) “Maps of Bounded Rationality: A Perspective on Intuitive Judgment and Choice"では、まだ「System 1・System 2」ではなく「直感(intuition)」と「推論(reasoning)」という言葉が使われている
- 2011年の著書『Thinking, Fast and Slow』で、Stanovich & Westが作った「System 1・System 2」という呼び方を採用し、自身のヒューリスティクスとバイアスの研究(プロスペクト理論を含む)全体を整理するフレームワークとして一般に広めた
- System 1は速く自動的で感情的、System 2は遅く努力を要し意識的、という性質づけは、Stanovich & Westの区別を継承している
- 一部の研究者からは、2つのシステムに単純に二分する枠組み自体が、認知の複雑さを捉えきれていないという批判もある(例えば、暗黙的・明示的処理の連続体として捉えるべきだという主張)
LeCunとの接続
- LeCun (2022)がActorモジュールの動作を、即時に反応するMode-1と、World Modelを使って計画するMode-2に分けているのは、この区別の延長線上にある
- ただし、元論文自体はOpenReviewのブラウザ認証でブロックされ直接確認できておらず、LeCunがカーネマンの著書を名指しで引用しているかどうかまでは検証できていない。Mode-1・Mode-2という名付け方と、速い反射的処理・遅い熟慮的処理という性質分けが、System 1・System 2の枠組みと明確に対応している、というところまでが確認できる範囲になる
Assran et al. (2023) “Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture”(I-JEPA)
概要
- LeCun (2022)が構想として提案したJEPAを、画像に対して初めて具体的に実装した論文。LeCun自身も共著者に入っている
- Context Encoder(画像の大部分を見るエンコーダ)、Target Encoder(Context Encoderの重みの指数移動平均で更新されるエンコーダ)、Predictor(マスクされた位置を示すトークンを受け取り、対象ブロックの表現を予測する軽量なモデル)という3つの要素からなる
Joint-Embedding Predictive Architecture
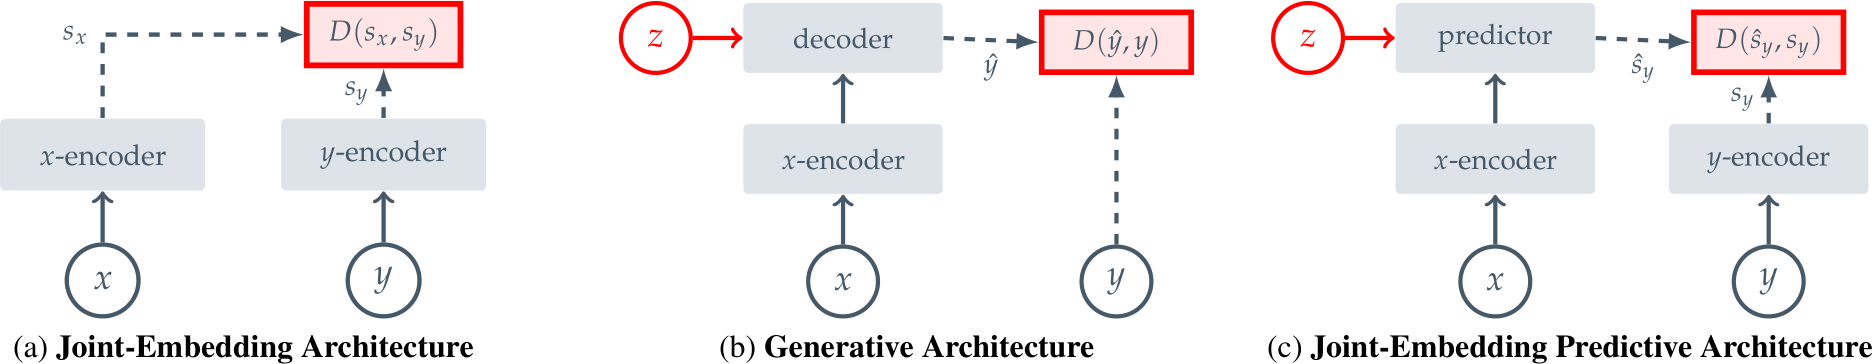
Figure 2. Common architectures for self-supervised learning, in which the system learns to capture the relationships between its inputs. The objective is to assign a high energy (large scaler value) to incompatible inputs, and to assign a low energy (low scaler value) to compatible inputs. (a) Joint-Embedding Architectures learn to output similar embeddings for compatible inputs x, y and dissimilar embeddings for incompatible inputs. (b) Generative Architectures learn to directly reconstruct a signal y from a compatible signal x, using a decoder network that is conditioned on additional (possibly latent) variables z to facilitate reconstruction. (c) Joint-Embedding Predictive Architectures learn to predict the embeddings of a signal y from a compatible signal x, using a predictor network that is conditioned on additional (possibly latent) variables z to facilitate prediction.
マスク戦略
- 画像の85〜100%を占める1つのコンテキストブロックから、画像全体に分散した、意味的なスケール(画像の15〜20%程度)の4つ程度のターゲットブロックの表現を予測する
- ターゲットブロックはコンテキストブロックと重ならないようにし、予測が自明にならないようにしている
他手法との違い
- MAEのような生成的な手法(ピクセルを直接再構成する)と比べ、表現空間で予測することで、必要な計算量を大きく削減できる。論文では、ピクセル空間での予測が66.9%から40.7%まで精度が落ちることを示し、表現空間での予測の方が意味的な学習につながることを示している
- DINO・SimCLRのような不変性に基づく手法と異なり、ランダムクロップや色変化といった、人手で設計したデータ拡張(data augmentation)を一切使わずに、マスクだけで強い表現を学習できる
Collapse防止の仕組み
- Target EncoderをContext Encoderの重みの指数移動平均(0.996〜1.0の運動量)で更新し、非対称性を作ることでCollapseを防いでいる
- この非対称な構成(EMA+Stop-Gradient的な力学)が、Joint-Embedding系の手法につきものの病的な解を避ける役割を果たしている
実験結果
- ImageNet-1Kの線形評価で、ViT-H/14(300エポック)は79.3%を達成し、MAEのViT-H/14(1600エポック)の77.2%を上回っている
- 計算効率も高く、ViT-H/14の学習がiBOTのViT-S/16より2.5倍、MAEのViT-H/14より10倍速いとされている
- 物体数のカウントや深度予測のような、空間的な局所構造が重要なタスクでは、DINO・iBOTのような視点不変性に基づく手法を上回る性能を示している
Dupoux, LeCun, Malik (2026) “Why AI systems don’t learn and what to do about it: Lessons on autonomous learning from cognitive science”
概要
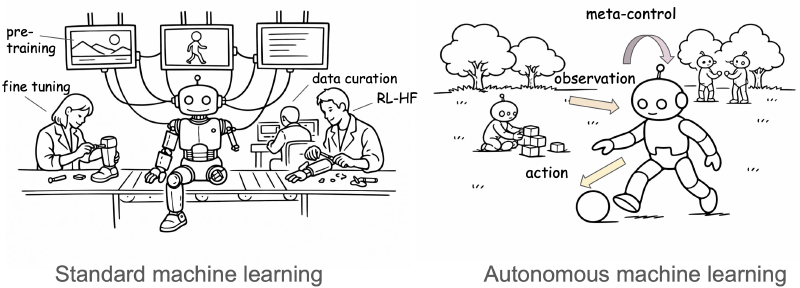
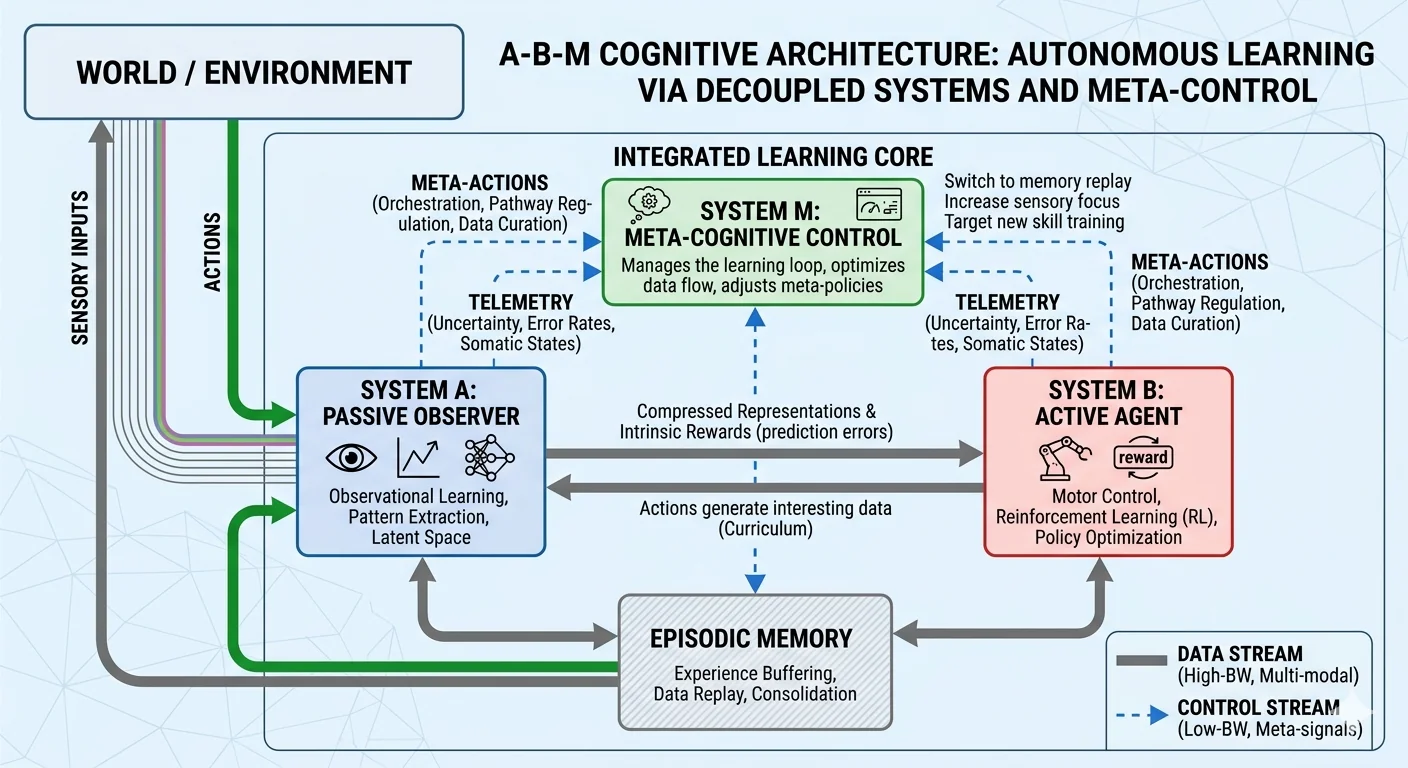
- 現在のAIが「デプロイ後は学習しなくなる」という問題を、認知科学のレンズで整理し、System A・B・Mという3つのシステムからなる自律学習のアーキテクチャを提案した論文
現在のAIへの批判
- LLMのスケーリングには限界があると指摘している
- 質の高いテキストデータの枯渇(data wall)
- 環境とのインタラクションがないため、人類の既知の知識を超えた新しいことを学べない
- 言語中心主義で、空間的・身体的な推論が弱い
- 継続学習(continual lifelong learning、デプロイ後の自己改善)の欠如
- 最大の問題は、一度デプロイされたモデルはそれ以降学習せず、特定用途への適応はプロンプトやファインチューニングという形でユーザー側に委ねられている点
- 実世界のデータは常に新しいケースを含み、時間とともに変化する(non-stationary)ため、事前学習・ファインチューニングだけでは対応できない
3つのSystem
アーキテクチャ概念(Reddit)
全体像
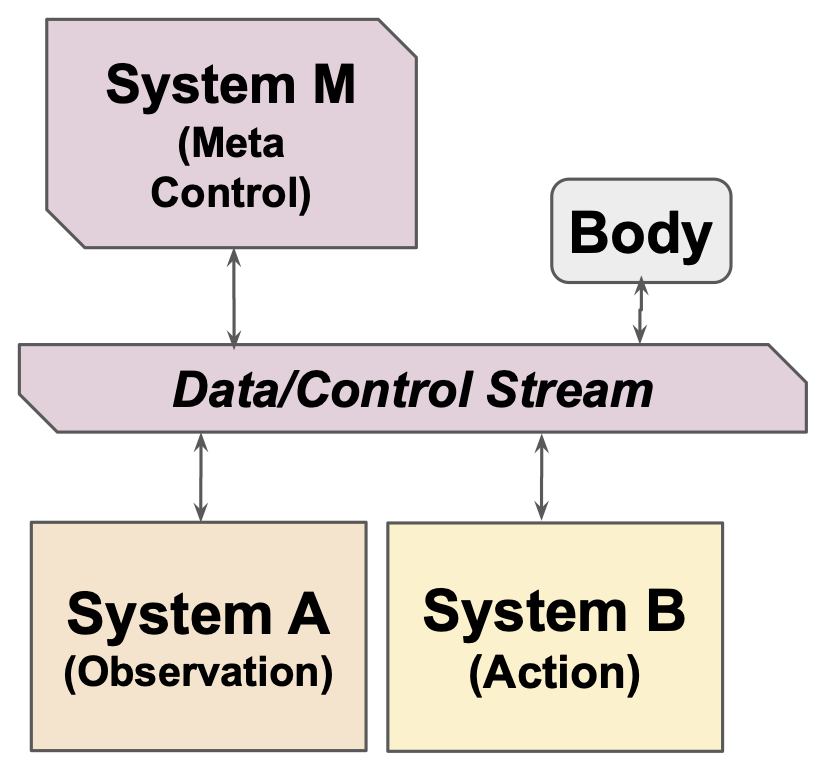
System A: 観察からの学習
- データストリームから統計的パターンを抽出する、受動的な学習
- 大規模データでスケールしやすく、感覚特徴から概念カテゴリまでの階層的な抽象表現を発見できる
- どのデータを取得すべきかを自分で決める仕組みがなく、相関と因果を区別できないという弱みがある
- 具体例: SimCLR・DINO・CLIPのような自己教師あり学習、GPT・BERTのような言語モデル
System B: 行動からの学習
- 環境と能動的にインタラクションし、報酬を最適化しながら学習する
- 制御・インタラクションに根ざしており、疎で遅延した結果からも学習できる
- サンプル効率が悪く、報酬が自然に明確に定義されていることは少ないという弱みがある
- 具体例: 強化学習(モデルフリー・モデルベース)、プランニング、制御理論
System M: メタ制御オーケストレーター
- 低帯域のモニタリングとルーティングによって、A・Bの学習プロセス全体を統括する中枢
- 入力の選択: 確信度・予測誤差・学習ゲインなどのエピステミックな信号、顔や音声などの種特異的な検出器、エネルギー・覚醒・痛みなどの身体的信号に基づく
- 損失・報酬の調整: 内発的動機、臨界期・学習率のスケジュール、睡眠・休息モード、探索と活用のトレードオフ
- 学習・推論モードの切り替え: 習慣的行動と目標志向行動の切り替え、観察モードと試行錯誤モードの切り替え、睡眠時のオフライン学習
- System Mは学習されるものではなく、進化によってあらかじめ固定された(hardwired)ルーティングポリシーとして実装されるという提案になっている
相互作用
AとBの相互作用
- AがBを助ける: 圧縮された状態表現、予測的な世界モデル、内発的報酬(予測誤差・不確実性・新奇性)を提供して探索を導く
- BがAを助ける: 能動的な行動によって、不確実性の高いデータを選んで集める(Active SSL)、タスクに関連する軌跡を使って表現をグラウンディングする(Goal-directed SSL)
- 現状のシステムは、AとBを柔軟に切り替えるのではなく、硬直的で手作業設計されたパイプラインになっているのが課題
生物学的インスピレーション
- 乳児は生後、視力が弱く(近視)、運動の自由度も限られているため、行動できる範囲が狭い間は観察による学習に頼る
- 歩行はロール→クロール→二足歩行という段階を経て、模倣ではなく試行錯誤で発達する。発声学習も同様に、言語的でない探索から始まる
- 顔への選好的注意(生後6ヶ月)、母語音素への選好(生後6〜12ヶ月)などが、System Mの入力選択機能の生物学的な実例として挙げられている
- 臨界期(特定の時期に学習の可塑性が高まる)は損失調整機能の、習慣的行動と目標志向行動の切り替えは環境の変動性に応じたモード制御の実例とされる
Evo/Devo(進化・発達)による学習の枠組み
- 発達スケール(内側のループ): System A・Bがメタパラメータから初期化され、固定されたSystem Mのもとで環境とインタラクションしながら更新される
- 進化スケール(外側のループ): 複数の仮想的な生涯(lifespan)を通じて、適応度関数を最大化するようメタパラメータ自体を調整する
- 課題として、A・Bは相互依存的で、Mもその両者からの信号が整った状態に依存するという「鶏と卵」の問題がある
- 解決策として、環境の多様性・予測不可能性を徐々に増やしていく進化的カリキュラムを提案している
周辺の関連研究
World Models
- Mathieu, Couprie, LeCun (2015) “Deep multi-scale video prediction beyond mean square error"は、動画の未来フレーム予測が平均二乗誤差だけではぼやけてしまう問題を、マルチスケール構造・敵対的学習・画像勾配差分損失で改善した研究。JEPAがピクセル単位の予測を避ける問題意識の、歴史的な先行研究にあたる
- Lerer, Gross, Fergus (2016) “Learning Physical Intuition of Block Towers by Example"は、積み木の塔が崩れるかどうかを畳み込みニューラルネットワークに学習させ、新しい状況や実物の画像にも一般化できることを示した研究で、ニューラルネットワークが直感的な物理法則を学習できることを示した早い例
- PlaNet・Dreamerは、潜在空間で力学をモデル化し、そこでプランニングする世界モデルの先駆的な研究
- MuZeroは、ルールを教えずに環境のモデルを学習し、そのモデル上でプランニングして盤面ゲーム・Atariを解く
- V-JEPAは、LeCun自身が関わる、動画からの自己教師あり世界モデル学習で、System Aの発展形にあたる
LeCunの2022年ポジション論文との関係
- 今回のSystem A/B/Mは、LeCun (2022)の構想の直接の後継にあたり、ConfiguratorがSystem Mに近い位置づけになっている(詳細は本記事のLeCun (2022)のセクションを参照)
Hierarchical RLとContinual Learning
- Sutton, Precup, Singh (1999) “Between MDPs and semi-MDPs: A framework for temporal abstraction in reinforcement learning"が、階層強化学習の古典的な基礎づけであるOptionsフレームワークを提案した
- Option-Criticアーキテクチャ(Bacon, Harb, Precup, 2017)は、このOptionsフレームワークを発展させたもので、メタポリシーが複数のサブポリシーをルーティングする仕組みが、System Mのモード切り替え機能に近い
- Director(Hafner, Lee, Fischer, Abbeel, 2022)“Deep Hierarchical Planning from Pixels"は、Dreamer系の学習済みワールドモデルの潜在空間の中で、長期的なゴール設定と短期的な行動を分けて学習する手法で、H-JEPAが目指す階層的プランニングに最も近い具体的な実装例にあたる
- Elastic Weight Consolidation(重要な重みの変化を抑えることで破壊的忘却を防ぐ継続学習の手法)が、臨界期の計算的な類似物として挙げられている
結論と今後の課題
- 推論時計算のスケーリング(thinking tokens)やテスト時強化学習など、最近の進展はあるが、子供が“テスト時”に新しい言語やスキル全体を学べることと比べると、全体として硬直的なシステムのマイナーな変種に過ぎないと評している
- 完全に自律的で広範な学習システムの実現は、おそらく数十年先としている
- 倫理的な課題として、適応性と制御可能性のトレードオフ、アライメント・ハッキング、擬人化によるユーザーの過信、痛みのような信号を持つエージェントの道徳的地位などを挙げている
Dawid, LeCun (2023) “Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence”
概要
- 現在のAIが、人間に比べてサンプル効率が悪く、世界モデルを持たず、推論や計画ができないという限界を指摘し、Energy-Based Model(EBM)と潜在変数モデルの枠組みから、JEPA(Joint Embedding Predictive Architecture)とその階層版H-JEPAを導く論文
- 自動運転を例に、人間は約20時間の練習で運転を習得できるのに対し、自動運転車は数千時間分の映像データを必要とするという、サンプル効率の差を指摘している
Energy-Based Modelとは
- 入力$x$と出力$y$の間の依存関係を、スカラー値を返すエネルギー関数$F(x,y)$で表現する枠組み
- 互換性のある組み合わせ(例: 雪が降っているときの低速運転)には低いエネルギー、互換性のない組み合わせには高いエネルギーを割り当てる
- 確率モデルのように正規化定数(分配関数)を計算する必要がなく、連続・高次元な空間でも扱いやすい
- 1つの入力に対して複数の出力が妥当な、マルチモーダルな依存関係も表現できる
推論と学習の違い
- 推論は、与えられた入力$x$に対してエネルギーを最小化する$y$を探すこと
- 学習は、互換性のあるデータに低いエネルギー、互換性のないデータに高いエネルギーが割り当たるよう、エネルギー関数そのものの地形を形成するプロセス
- 論文では「ここで議論しているエネルギー関数は、推論のためだけに使われ、学習には使われない」と明記されており、学習と推論は明確に役割が分かれている
Energy Collapse問題と学習方法
- 学習における中心的な課題が、エネルギーの地形が「平坦」になり、どの出力にも同じエネルギーが割り当てられてしまうEnergy Collapse
- 2つのエンコーダの出力同士の距離だけを最小化するように学習すると、エンコーダが入力を無視して同じ定数を出力するようになってしまう、という例が挙げられている
- Contrastive法: 学習データのエネルギーを下げながら、分布外のデータ(対照サンプル)のエネルギーを上げる。生成に次元の呪いの影響を強く受け、データの次元が増えるとスケーリングが悪化する
- Regularized法: アーキテクチャの制約や正則化項によって、低エネルギーな領域の体積そのものを制限する。論文では、将来のEBMの学習にはこちらの方が有望だとしている
潜在変数EBM
- 潜在変数$z$は、入力$x$からは得られない、出力$y$側の情報を捉えるために使われる
- 不確実性の表現(同じ$x$に対して、異なる$z$で複数の$y$を表現できる)、構造化予測(画像のセグメンテーションなど、観測されていない構造の表現)、マルチモーダルな予測に使われる
- 潜在変数を含めると、エネルギー関数は次のように$z$についても最小化する形になる
JEPA(Joint Embedding Predictive Architecture)
- マスク付き自己符号化器は、テキストでは機能するが、画像ではぼやけた予測になってしまう。単一の予測を行うよう学習すると、モデルはあり得る予測の平均を予測するようになるため
- 画像や動画のような、複数の未来があり得る連続的な領域では、この平均化が重要な詳細を消してしまう
- JEPAは、ピクセルを直接予測するのではなく、学習された表現(埋め込み)のレベルで入力同士を比較する
- 2つのエンコーダがそれぞれ$s_x = \text{Enc}_x(x)$、$s_y = \text{Enc}_y(y)$という表現を作り、潜在変数$z$を持つ予測器が$s_x$から$s_y$を予測し、エネルギーはこの2つの表現の距離として計算される
- 学習は、予測誤差の最小化、表現が入力について持つ情報量の最大化(VICRegなどによる表現同士の相関除去)、潜在変数$z$が持つ情報量の最小化という3つの項を組み合わせたRegularized法で行われる
Hierarchical JEPA(H-JEPA)
- 単一階層のJEPAだけでは、短期的な(詳細な)予測と長期的な(抽象的な)予測の両方を扱えない
- H-JEPAは、複数のJEPAモジュールを階層的に積み重ねる。JEPA-1が低レベルで詳細な表現を使った短期予測を、JEPA-2がより高レベルで粗い表現を使った長期予測を担う、という構成
- この階層構造により、複雑なタスクをより詳細なサブタスクに分解し、新しい観測に応じて定期的に更新しながら計画する、階層的なプランニングが可能になるとしている
自律知能アーキテクチャとの統合
- この論文は、LeCun (2022)の自律知能アーキテクチャ(Perception・World Model・Actor・Critic・Configurator)を土台にしている
- World Modelの部分を自己教師あり学習で訓練する際の具体的な構成要素として、H-JEPAを提案する位置づけになっている
- 知覚・計画・行動のサイクルは、モデル予測制御(Model Predictive Control)に近いが、学習された微分可能な世界モデルを使う点が異なる
Gladstone et al. (2024) “Cognitively Inspired Energy-Based World Models”(EBWM)
概要
- LLMの次トークン予測や、画像の次フレーム予測のような自己回帰モデル(Traditional Autoregressive Models, TAM)が、人間の認知と比べて欠いている性質を指摘し、Energy-Based World Models(EBWM)という代替手法を提案する論文
- 人間の認知は、予測が内部の認知処理そのものに影響を与えること、予測の妥当性を自分で評価できること、タスクの難しさに応じて計算量(考える時間)を動的に調整できることという3つの性質を持つが、固定された1回のフォワードパスしか行わないTAMにはこれらが無い
Energy-Based Transformer(EBT)
- 次の状態を直接予測するのではなく、文脈と予測される未来の状態の「互換性」を、EBMのエネルギー関数として学習する
- 通常のTransformerを拡張し、過去の状態と予測中の状態を別々に保持しながら、予測状態が過去の状態と自分自身に注意を向けられるようにしたアーキテクチャ
推論時のMCMCによる反復的な洗練
- 推論時には、ランダムノイズや初期推定値から始めて、エネルギーの入力に対する勾度を使って予測を反復的に洗練していく、MCMC(マルコフ連鎖モンテカルロ法)を使う
- エネルギーが収束するまで反復するため、難しい予測にはより多くの計算を割り当てられる(可変的な計算量)
- エネルギーの値そのものが予測の妥当性の指標になるため、予測の良し悪しを自分で評価できる
System 1・System 2との関係
- TAMの固定された1回のフォワードパスはSystem 1的な処理にあたり、EBWMのMCMCによる反復的な洗練はSystem 2的な熟慮にあたると位置づけている
- Chain-of-Thought(推論トークンを増やす手法)だけでは、可変的な計算量や、十分に考え終えたかどうかの評価ができないため不十分だと指摘し、エネルギー値に基づく打ち切り(収束判定)によってこれを解決できるとしている
実験結果
- 画像領域(Something-Something V2、Kinetics-400)では、データ量を増やすほどEBWMのスケーリングがTAMを上回り、過学習にも強いことを示している
- NLP(RedPajama-V2、100Bトークン)では、まだ予備的な結果ながら、良好な初期のスケーリング傾向を示している
Balestriero, LeCun (2025) “LeJEPA: Provable and Scalable Self-Supervised Learning Without the Heuristics”
概要
- Dawid, LeCun (2023)で紹介したRegularized法(VICRegなど)によるEnergy Collapse防止は、理論的な根拠が薄く、ヒューリスティックな手法を組み合わせた「モグラ叩き」のような状態だったと批判し、理論的に根拠づけられたSIGReg(Sketched Isotropic Gaussian Regularization)という新しい正則化手法を提案する論文
- 停止勾度(stop-gradient)や教師・生徒ネットワーク(teacher-student)といった、従来のJEPA系の自己教師あり学習で必須とされてきたヒューリスティックを一切使わずに学習できることを示している
埋め込みは等方的ガウス分布に従うべき
- 等方的ガウス分布(Isotropic Gaussian)とは、共分散行列が単位行列の定数倍になっている多変量正規分布のことで、どの方向にも同じ分散を持ち、分布の等高線が真円・球になる。方向によって分散が異なる(楕円形になる)分布はAnisotropic(非等方的)と呼ばれる
- ダウンストリームタスクが事前に分からない状況で、予測リスクを最小化するために埋め込みがどのような分布に従うべきかを理論的に分析している
- 線形プロービング・非線形プロービング(k-NN・カーネル法)のいずれにおいても、等方的ガウス分布が、最悪ケースのリスクを最小化する一意な分布であることを証明している
SIGReg(Sketched Isotropic Gaussian Regularization)
- 埋め込みの分布を、目標とする等方的ガウス分布に一致させるための正則化手法
- Sketched(スケッチ)とは、高次元のまま分布同士を比較する代わりに、ランダムな方向への射影を使って、高次元の分布比較を複数の1次元の分布比較に分解する手法で、ランダム線形代数・ストリーミングアルゴリズムの分野で使われる考え方の応用にあたる
- 射影した1次元の分布について、経験特性関数(Empirical Characteristic Function)を使い、目標のガウス分布とのズレを測る(Epps-Pulley検定)
- この手法は微分可能で、GPU間の分散学習にも効率的に対応でき、実装はPyTorchで約50行程度に収まるとされている
VICRegなどの従来手法との関係
- SIGRegは、1次・2次モーメント(平均・分散)だけを一致させる検定を使った場合、大量のスライス数の極限でVICRegと一致することを示している
- ただし、モーメントを一致させるだけでは分布全体が一致することの証明にはならず、同じモーメントを持ちながら異なる分布が存在してしまう「識別可能性のギャップ」があることも示し、VICRegだけに頼ることは推奨していない
- SIGRegを使うことで、停止勾度や教師・生徒ネットワークを取り除いてもCollapseが起きないことを実験で示しており、従来のヒューリスティックの組み合わせを置き換えるものと位置づけている
実験結果
- ResNet・ViT・ConvNeXt・Swin Transformerなど、8系統・約50種類のアーキテクチャで安定した性能を確認している
- ImageNet-1KでのViT-H/14は、frozenバックボーンの線形評価で79%を達成している
- 天文学のGalaxy10データセットのような専門領域では、自然画像で学習したDINOv2・DINOv3のような大規模基盤モデルの転移学習よりも、LeJEPAによるドメイン内の事前学習の方が性能が高いことを示している
Goldfeder, Wyder, LeCun, Shwartz Ziv (2026) “AI Must Embrace Specialization via Superhuman Adaptable Intelligence”
概要
- AGI(Artificial General Intelligence)という概念そのものに疑問を投げかけ、人間自身が本当に「汎用的」な知能なのかを問い直した上で、専門化(Specialization)を通じた超人的な適応知能(Superhuman Adaptable Intelligence, SAI)を提案する論文
AGIという概念への批判
- 人間の知能は進化の圧力によって形作られた専門的なものであり、普遍的な問題解決者ではない
- Moravecのパラドックス(人間が簡単だと感じるタスク(歩行など)はコンピュータには難しく、人間が難しいと感じるタスク(チェスなど)は計算上は簡単)を例に挙げている
- 「マグヌス・カールセンは客観的にチェスが強いわけではなく、人間の性能水準に対してチェスが強いだけだ」という指摘
- 既存のAGIの定義には3つの欠陥がある
- 一貫性が無い: 人間レベルの認知を「汎用的」とする定義自体が、人間の能力がドメイン特化であるという事実と矛盾する
- 実現可能ではない: ノーフリーランチ定理により、有限のリソースで無限のタスクに対する万能な性能を持つことは不可能
- 評価可能ではない: 性能ベースの定義には明確な指標がなく、適応速度に基づく定義の方が測定しやすい
Superhuman Adaptable Intelligence(SAI)とは
- 「人間にとって重要なことなら何でも人間を超えられるよう学習し、人間が苦手なスキルのギャップも埋められる知能」として定義される
- チェックリスト的な能力の網羅ではなく、新しいタスクをどれだけ速く学習できるかという適応速度で進歩を測る
- 専門化を避けるのではなく、専門化を前向きに受け入れる
- 「可能なスキルの空間は実質的に無限であり、個別にスキルをテストしていくことはシーシュポスの試みになる」と指摘している
ワールドモデルとの接続
- トークン単位の予測(自己回帰的なLLM)ではなく、JEPAやDreamerのような潜在表現を学習するアーキテクチャを推奨している
- 「ピクセルは状態ではない。物理世界はあまりに豊かで確率的すぎて、ピクセル単位の予測は意味のある目的関数にならない」と述べ、潜在空間でのワールドモデルの学習とプランニングを重視する
- 自己教師あり学習(SSL)は、希少なラベル付きデータに依存せず汎用的な知識を獲得するために不可欠とされる
- 現在の自己回帰的LLMの画一性を批判し、タスクに応じてルーティングされる、多様で専門化されたサブシステムによるモジュール性を提唱する
結論
- 「タンパク質を折り畳むAIは、洗濯物を折り畳むAIであるべきではない」という比喩で、専門化の原則を要約している
- 定義が曖昧なAGIを追い求めるのではなく、SSL・ワールドモデル・モジュール構造を通じて、人間のドメインを超えて重要なタスクに迅速に適応できるSAIを目指すべきだと結論づけている
まとめ
- 現在のAIは、デプロイ後に学習が止まるという本質的な限界を抱えている
- LeCun (2022)は、Perception・World Model・Actor・Critic・Configuratorというモジュール構成と、JEPA・H-JEPAによる世界モデルの学習を提案しており、後続の論文群の土台になっている
- 「System 1・System 2」という用語はStanovich & West (2000)の造語で、カーネマンは2011年の著書で初めてこの呼び方を採用した。ノーベル賞自体は、損失回避で知られるプロスペクト理論(Kahneman & Tversky, 1979)が受賞理由で、System 1・System 2とは別の研究
- Assran et al. (2023)のI-JEPAは、LeCun (2022)が構想したJEPAを画像に対して初めて具体的に実装し、データ拡張なしでも強い表現が学習できることを示している
- Dawid, LeCun (2023)は、推論をエネルギー関数の最小化として定義するEBMの枠組みから、ピクセル単位の予測を避けて表現空間で予測するJEPA・H-JEPAを、より技術的に掘り下げている
- Gladstone et al. (2024)のEBWMは、この「推論=エネルギー最小化」という考え方を、推論時のMCMCによる反復的な洗練として具体化し、System 2的な熟慮をモデルに持たせる手法を提案している
- Balestriero, LeCun (2025)は、Dawid, LeCun (2023)のヒューリスティックなCollapse防止(VICRegなど)を、埋め込みが等方的ガウス分布に従うべきという理論から導いたSIGRegに置き換え、理論的な根拠を与えている
- Dupoux, LeCun, Malik (2026)は、観察からの学習(System A)、行動からの学習(System B)、それらを統括するメタ制御(System M)という3つのシステムで、自律学習のアーキテクチャを整理している
- このアーキテクチャは、乳児の発達や動物の学習といった認知科学の知見に着想を得ており、進化・発達の2つのスケールで学習プロセス自体を最適化するEvo/Devoの枠組みを提案している
- Goldfeder, Wyder, LeCun, Shwartz Ziv (2026)は、AGIという概念自体に疑問を投げかけ、専門化を通じた超人的な適応知能(SAI)を提案している
- 7つの論文はいずれも、トークン単位の予測ではなく、潜在空間でのワールドモデル(JEPA・Dreamerなど)を学習の中核に据えるべきだという立場で一致している
- World Models・階層強化学習・継続学習といった既存研究とも接続している
参考文献
- LeCun, Y. (2022). “A Path Towards Autonomous Machine Intelligence”
- Stanovich, K. E., & West, R. F. (2000). “Individual difference in reasoning: implications for the rationality debate?” Behavioral and Brain Sciences, 23(5), 645-726
- Kahneman, D. (2003). “Maps of Bounded Rationality: A Perspective on Intuitive Judgment and Choice” American Economic Review, 93(5), 1449-1475
- Kahneman, D. (2011). “Thinking, Fast and Slow”
- Assran, M., Duval, Q., Misra, I., Bojanowski, P., Vincent, P., Rabbat, M., LeCun, Y., & Ballas, N. (2023). “Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture” (arXiv:2301.08243)
- Dawid, A., & LeCun, Y. (2023). “Introduction to Latent Variable Energy-Based Models: A Path Towards Autonomous Machine Intelligence” (arXiv:2306.02572)
- Gladstone, A., Nanduru, G., Islam, M. M., Chadha, A., Li, J., & Iqbal, T. (2024). “Cognitively Inspired Energy-Based World Models” (arXiv:2406.08862)
- Balestriero, R., & LeCun, Y. (2025). “LeJEPA: Provable and Scalable Self-Supervised Learning Without the Heuristics” (arXiv:2511.08544)
- Dupoux, E., LeCun, Y., & Malik, J. (2026). “Why AI systems don’t learn and what to do about it: Lessons on autonomous learning from cognitive science” (arXiv:2603.15381)
- Goldfeder, J., Wyder, P., LeCun, Y., & Shwartz Ziv, R. (2026). “AI Must Embrace Specialization via Superhuman Adaptable Intelligence” (arXiv:2602.23643)
- Sutton, R. S., Precup, D., & Singh, S. (1999). “Between MDPs and semi-MDPs: A framework for temporal abstraction in reinforcement learning”
- Hafner, D., Lee, K.-H., Fischer, I., & Abbeel, P. (2022). “Deep Hierarchical Planning from Pixels” (arXiv:2206.04114)
- Mathieu, M., Couprie, C., & LeCun, Y. (2015). “Deep multi-scale video prediction beyond mean square error” (arXiv:1511.05440)
- Lerer, A., Gross, S., & Fergus, R. (2016). “Learning Physical Intuition of Block Towers by Example” (arXiv:1603.01312)
- Why AI systems don’t learn and what to do about it: Lessons on autonomous learning from cognitive science : r/newAIParadigms
- Why AI systems don’t learn and what to do about itLessons on autonomous learning from cognitive science
- World model (artificial intelligence) - Wikipedia
- (9) Yann LeCun: World Models: Enabling the next AI revolution - YouTube