目次
背景
- 機械学習をして問題になるのは学習にとにかく時間がかかること
- 精度を上げるにも大きなモデルで大量のデータで学習をする必要がある
- しかし、精度を上げようとする程に学習時間がかかサイクルが遅くなる
- そこで一般的には小さなモデルと小さなデータセットで学習して肌感を掴んだりする
- もしくは、まず安価な代理評価で候補を絞り込み、有望なものだけ本番評価に回す、という考え方をする
- この考え方は機械学習分野では多信頼度最適化(Multi-fidelity Optimization)と呼ばれる
- 過去に自分が実際に手元で行った学習実験の記録を題材にしつつ、やってた方法について改めて考察した
多信頼度最適化
多信頼度最適化とは
- 多信頼度最適化(Multi-Fidelity Optimization: MFO)とは、精度とコストが異なる複数の評価方法を組み合わせ、限られた予算内で効率的に最適解を探索する手法
- 安価だが近似的な評価をlow-fidelity、高価だが目的とする真値に近い評価をhigh-fidelityと呼ぶ
- low-fidelityから得られる情報を活用することで、必要なhigh-fidelity評価の回数を減らす
- 必ずしもlow-fidelityで候補を絞ってからhigh-fidelityへ進むとは限らない
- 多信頼度ベイズ最適化では、観測済みデータ、予測の不確実性、各評価方法のコストや情報量を考慮し、次に評価する候補と信頼度を動的に選択する
- 材料探索、工学設計、ハイパーパラメータ探索、AutoMLなどに応用できる
Computation Funnel
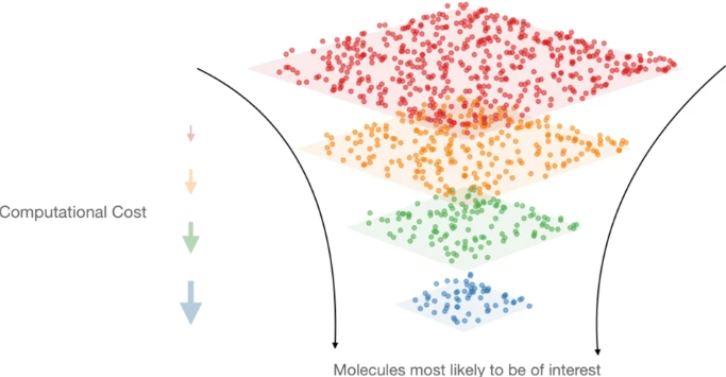
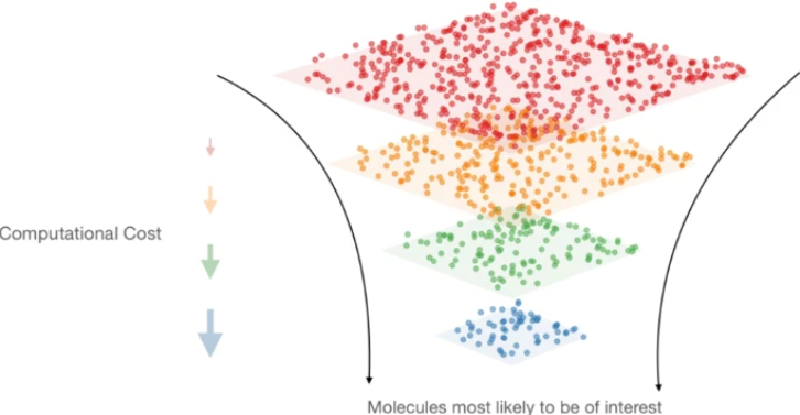
この図は、多数の候補を安価な方法で調べ、各段階で候補を減らしながら、残ったものにだけ高価で高精度な評価を行う事を示している。
- 赤
- 最初の膨大な候補
- 安価で粗い計算により、候補を一括評価する
- オレンジ → 緑
- 段階的な絞り込み
- 上位候補だけを残し、徐々に高精度な計算へ進める
- 青
- 最終的な少数候補
- 最も有望と判断された分子に、高価な計算や実験を行う
逆に言うと、初期の安価な計算が不正確だと、本当に優れた分子まで途中で落としてしまうので注意。
代表的なアルゴリズム
HPOの文脈では、多信頼度最適化を体系化したアルゴリズムがいくつか提案されている。
Successive Halving
- 多数の候補を、少ない予算(少ないepoch数など)で一斉に評価する
- 成績が良かった上位半分だけを残し、残りは打ち切る
- 生き残った候補には、より多くの予算を割り当てて再評価する
- これを繰り返し、最終的に少数の最有力候補にだけ、フルの予算を投入する
Hyperband
- Successive Halvingの弱点(予算の初期配分をどう決めるかが難しい)を補うために提案された手法
- 「少ない候補に多くの予算を割く探索」と「多くの候補に少ない予算を割く探索」を複数パターン同時に走らせ、良い結果を採用する
- Li et al. (2018)で提案されている
ASHA・BOHB
- Hyperbandをさらに発展させた手法
- ASHA(Asynchronous Successive Halving Algorithm)は、非同期に候補の足切りを行うことで、並列実行時の待ち時間を減らす
- BOHB(Bayesian Optimization and Hyperband)は、ベイズ最適化とHyperbandを組み合わせ、単なるランダム探索よりも良い候補を優先的に生成する
学習曲線外挿(Learning-curve Extrapolation)
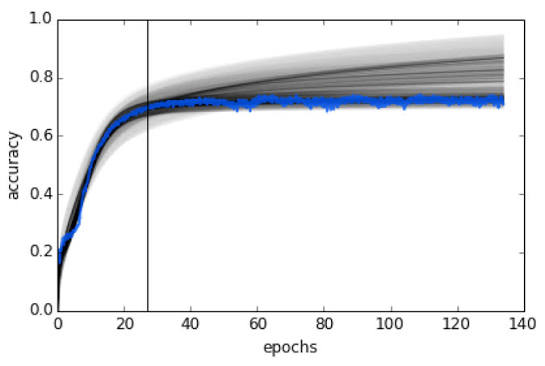
- 例えば、「100epoch必要なところを、3epochだけ学習して100epoch目の結果を予測する」ということがしたくなる
- この考え方が、まさに学習曲線外挿と呼ばれる、多信頼度最適化の典型的な応用の1つ
- Successive HalvingやHyperbandが「今の時点での生の性能」を候補間で比較して足切りするのに対し、学習曲線外挿は「これまでの学習曲線の形」にモデルを当てはめ、その先(最終的な収束値)を予測するという、一歩踏み込んだアプローチ
基本的な考え方
- 損失や精度の学習曲線は、多くの場合、以下のようなべき乗則(power law)に近い形で収束していく
$f(t)$: epoch $t$時点での性能(精度など)
$a$: $t\to\infty$としたときの収束値(=知りたい最終的な性能)
$b, c$: 曲線の形を決めるパラメータ
序盤の数epoch分の観測値(例えば3epoch分)から$a, b, c$をフィッティングすれば、実際に100epoch学習しなくても、収束値$a$を100epoch目の結果の予測値として使える
実務では、単一のべき乗則だけでなく、指数関数的な収束や対数線形など複数の曲線モデルを重み付けして組み合わせ、予測の頑健性を上げる手法も提案されている(Domhan, Springenberg, Hutter, 2015)
Freeze-Thaw Bayesian Optimization
- 学習曲線外挿をベイズ最適化に組み込んだ手法として、Freeze-Thaw Bayesian Optimization(Swersky, Snoek, Adams, 2014)がある
- 名前の通り、学習を「凍結(freeze)」して外挿による予測を行い、有望と判断した候補だけ「解凍(thaw)」して学習を再開する、という運用を形式化したもの
- 3epoch学習して一旦止め、外挿で100epoch目の性能を予測し、見込みが薄ければそのまま打ち切る、というのはこの考え方そのもの
注意点
- 外挿の精度は、観測済みのepoch数と、実際の学習曲線が仮定した曲線モデルの形にどれだけ従うかに依存する
- 学習率のスケジュール変更(ウォームアップ・再起動など)で曲線の形が途中で大きく変わる場合、序盤だけを見た外挿は外れやすい
- そのため、学習曲線外挿は単独で使うより、Successive Halvingのような足切りと組み合わせ、外挿による予測が怪しい候補は保守的に生き残らせる、といった運用がされることが多い
LLM事前学習におけるスケーリング則としての応用
- 大規模言語モデルの事前学習でも、同じ考え方が使われている
- 本番の大規模学習を始める前に、小さいモデル・小さいデータで同じ変更(データの変更、正則化の変更など)を試し、傾向が良ければ本番の大規模学習に進む、という運用が一般的
- この関連で語られるのがスケーリング則(Scaling Laws)で、モデルサイズ・データ量・計算量と性能の関係を、小規模な実験から外挿して予測する研究群を指す
- 多信頼度最適化が「どの候補を本番に回すか」を選ぶ手法であるのに対し、スケーリング則は「小規模の結果から本番の性能をどう予測するか」に主眼がある、という違いはあるが、根底にある「小規模実験で本番実験の予算を節約する」という発想は共通している
実例: 小さいモデルを代理評価に使う
手元の学習実験で、実際に「小さいモデル」をlow-fidelityな代理評価として使った例を紹介する(タスクの詳細は割愛し、数値のみを一般化して示す)。
データセットの前提
データ・セットは次を使った:
- train
- val
- diag(診断用)
- test(評価用)
制約:
- test
- カンニング(エラーアナリシス)は禁止
- ミクロと、カテゴリーごとのスコアまでしか見てはいけない
- diag
- testの代わりに診断データセットはカンニングOK
- 診断は評価を真似するように作ったデータセット
設定と結果
設定とモデルサイズ・データ種類ごとの結果は以下だった。
| 設定 | モデルサイズ | データ | タスク精度 |
|---|---|---|---|
| 設定A | 大 | データ版1 | 93.720% |
| 設定B | 大 | データ版2(改良) | 94.910% |
| 設定C | 小 | データ版2(改良) | 93.957% |
結果:
- データ改善の効果(設定A→B、同じ大モデル): +1.190pt
- モデルサイズの効果(設定C→B、同じデータ版2): +0.953pt
考察:
- この実験では、データ改善の効果がモデルサイズの効果と同等かそれ以上だった
- つまり、大モデルでなければ判断できないような差ではなく、小さいモデルでも十分に「このデータ改善は効きそうか」を判断できる規模の差だったことになる
- これが、小さいモデルを代理評価として使う運用の妥当性を裏付けている
どの指標を代理に使うか
- low-fidelityな評価では、学習中に安価に計算できる指標(例えば検証loss)を代理指標として使うことが多い
- ただし、代理指標が本番で見たい指標とどれだけ強く連動しているかは、事前に確認しておく必要がある
- 手元の実験では、複数の指標と本番評価の相関係数を確認したところ、以下のような違いが見られた
- 検証lossは、評価Accとある程度は連動するが、相関はそこまで強くない
- 一方、診断Accの方が、評価Accとより強く連動していた
サンプル数がまだ小さいため、これらの相関係数はあくまで傾向として捉えるべきだが、運用としては以下のように役割を分けるのが妥当と判断した:
- 検証lossは、学習の早期打ち切りや失敗した実行の検出に使う
- 診断Accは、データ改善案を採用するかどうかの判断に使う
- 評価Accは、最終確認にのみ使う
運用ループ
実際の運用は、以下のループで回している。
- データやレギュラライゼーションの変更案を1つ作る
- 小さいモデルで、同じ評価用データ分割を使って学習する
- 診断Accを確認する
- 診断Accが一定以上改善した変更案だけを残す
- 残った変更案だけを、大きいモデルで本番学習する
モデル小で目指すべきスコア
- モデル小では、モデル大より、評価データセットでのスコアが1%低かった
- 99%を仮に目指す場合は、モデル小で目指すべきは98%になる
- ただし、これは同じデータセットで線形に差がある場合の仮定なので注意
診断データセットで弱点を洗い出す
- 診断データセットと評価データでのスコアに相関性があったため、診断データセットの結果を信頼している
- 評価データのカテゴリー(サブセット)に対してモデルの容量のサイズが大と小で実験をして小の弱点をあぶり出した
- 同じデータセットで学習しているので、モデル小が苦手なカテゴリーはモデル大も苦手だと推定できる(あくまで推定)
- そこで、その弱点のカテゴリーに対してデータを追加して、モデル小の性能が上がるか確認する
- 仮に上がった場合は(例えば、診断でそのターゲットのカテゴリーに対して+3pt)、そこから更に考察ができる
- 「trainの分布のバランスを崩さないようにしつつ、何件追加すれば+3pt上がったか」が分かれば、そこから「+10pt上げるには何件追加が必要か」という見積もりの精度も上げていける
分母に注意
- 基本的に分母が違うものは比較できないので注意
- 特にValやLossなどはTrainのデータセットを追加したり修正したりしたら比較はできなくなる
- その場合にControlとするのは追加する前のデータセットと追加後のデータセットにおける同じ容量のモデルとなる
- これにより、データの追加分による、データの効果を測ることができる
まとめ
- 多信頼度最適化は、安価なlow-fidelity評価で候補を絞り込み、高価なhigh-fidelity評価は絞り込んだ候補にだけ使うという考え方
- 学習曲線外挿は、序盤の少ないepoch数の観測値から収束値を予測する、多信頼度最適化の一種で、Freeze-Thaw Bayesian Optimizationのように学習の凍結・解凍という形で運用に組み込まれる
- HPOの文脈ではSuccessive Halving・Hyperband・ASHA・BOHBといった具体的なアルゴリズムがあり、LLM事前学習の文脈ではスケーリング則を使った小規模実験がこれに近い役割を果たす
- 代理評価に使うモデル・指標を選ぶ際は、それが本番の評価とどれだけ連動しているかを事前に確認しておくべきで、連動が弱い指標を代理にすると判断を誤る
- 手元の実験では、データ改善の効果がモデルサイズの効果と同等以上だったことが、小さいモデルを代理評価として使う運用の妥当性を裏付けていた
- 他にも相関係数だけじゃなく、ベイズや相互情報量などもあるので、そっちも今後は試してみたい
参考文献
- Li, L. et al. (2018). “Hyperband: A Novel Bandit-Based Approach to Hyperparameter Optimization” (Journal of Machine Learning Research)
- AutoML with Hyperband - YouTube
- Li, L. et al. (2020). “A System for Massively Parallel Hyperparameter Tuning” (ASHA, MLSys)
- Falkner, S. et al. (2018). “BOHB: Robust and Efficient Hyperparameter Optimization at Scale” (ICML)
- Kaplan, J. et al. (2020). “Scaling Laws for Neural Language Models” (arXiv:2001.08361)
- Hoffmann, J. et al. (2022). “Training Compute-Optimal Large Language Models” (Chinchilla, arXiv:2203.15556)
- A multi-fidelity machine learning approach to high throughput materials screening | npj Computational Materials
- Domhan, T., Springenberg, J. T., & Hutter, F. (2015). “Speeding up Automatic Hyperparameter Optimization of Deep Neural Networks by Extrapolation of Learning Curves” (IJCAI)
- Swersky, K., Snoek, J., & Adams, R. P. (2014). “Freeze-Thaw Bayesian Optimization” (arXiv:1406.3896)
- Klein, A. et al. (2017). “Learning Curve Prediction with Bayesian Neural Networks” (ICLR)
- Learning Curve Extrapolation. Best Accuracy Achieved by Algorithm 1. | Download Scientific Diagram