目次
背景
- 分布外データの対処方法の
結果の比較では、実験Aと実験Bの差が本物かどうかを疑うべき、という話をした - 実際にその差を統計的に検定する方法として、マクネマー検定(McNemar’s test)がある
- 同じテストセットに対する2つのモデルの正解・不正解を比較するのに使う、ペア化されたデータ専用のカイ二乗検定
なぜ単純な精度の差では判断できないか
- モデルAとモデルBの精度を、同じテストセットで比較したとする
- 単純に「精度の差が何%あるか」だけを見てしまうと、その差が本物の性能差なのか、たまたまのブレなのかが区別できない
- さらに、同じテストセットを使っている以上、サンプルごとの正解・不正解はAとBの間で相関する
- そのため、AとBを独立な2群として扱う単純な比率差の検定(例えば2標本の$z$検定)を使うのは前提が間違っている
- マクネマー検定は、この「同じサンプルに対するペアの結果である」という前提を正しく扱う
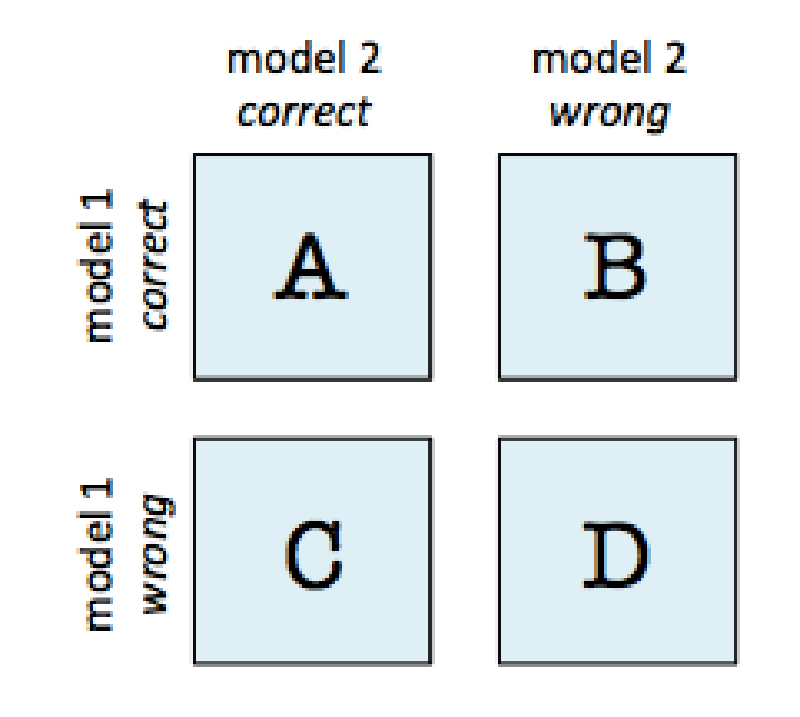
2×2分割表
同じテストセットに対するAとBの正解・不正解を、次のような分割表にまとめる。
| - | Bが正解 | Bが不正解 |
|---|---|---|
| Aが正解 | $a$ | $b$ |
| Aが不正解 | $c$ | $d$ |
- $a$:AもBも正解したサンプル数
- $d$:AもBも不正解だったサンプル数
- $b$:Aは正解、Bは不正解だったサンプル数
- $c$:Aは不正解、Bは正解だったサンプル数
$a$と$d$は一致するペア(concordant pairs)で、AとBのどちらが優れているかについては情報を持たない。実際に比較に使えるのは、$b$と$c$の不一致ペア(discordant pairs)だけ。
検定統計量
帰無仮説は「AとBの性能に差がない」で、これは分割表の上では「$b$と$c$が同じくらいの数である」という仮説に対応する。連続性補正を加えた検定統計量は次の通り。
$$ \chi^2 = \frac{(|b - c| - 1)^2}{b + c} $$- この統計量は、自由度1のカイ二乗分布に近似的に従う
- $b + c$が小さい場合(目安として25未満)は、カイ二乗近似の精度が落ちるため、二項分布に基づく厳密検定(exact McNemar test)を使う方が安全
具体例
200件のテストセットに対して、モデルAとモデルBを評価したとする。
| - | Bが正解 | Bが不正解 |
|---|---|---|
| Aが正解 | 150 | 20 |
| Aが不正解 | 10 | 20 |
- モデルAの精度:$\frac{150+20}{200} = 85\%$
- モデルBの精度:$\frac{150+10}{200} = 80\%$
- 見た目の精度差は5ポイントある
これをマクネマー検定にかけると、次のようになる。
$$ \chi^2 = \frac{(|20 - 10| - 1)^2}{20 + 10} = \frac{81}{30} \approx 2.7 $$自由度1のカイ二乗分布で有意水準5%の臨界値は約3.84であるため、$\chi^2 \approx 2.7$はこれを下回る。つまり、見た目は5ポイントの精度差があっても、この不一致ペアの数(20件と10件)では、統計的に有意な差があるとは言えない。
使う上での注意点
- 同じテストセットに対する、同じサンプルのペア予測であることが前提。テストセットが異なる2つの実験の比較には使えない
- p値は「差がないという帰無仮説のもとで、観測された不一致ペアの偏りが起きる確率」を示すだけで、効果量(実際の差の大きさ)を示すものではない。p値そのものの解釈についてはp値の正しい解釈と誤解で詳しく扱っている
- サンプルサイズが小さいと、実際に意味のある差があっても検出力が不足し、有意差が出ないことがある
- 逆に、テストセットが十分大きい場合は、実務上どうでもいいような小さな差でも統計的に有意になりうる
- こうした限界があるため、p値だけでなく、分布外データの対処方法で触れたWinner’s Curseのような、実験比較全体に対する慎重さも合わせて必要になる
モデルの改善・退行を判定する
- 過去のモデルを$A$、現行のモデルを$B$とすれば、マクネマー検定はそのまま「モデルが改善したか退行したか」の判定に使える
- $\chi^2$統計量は$|b-c|$を使う両側検定なので、これ単体では「差があるかどうか」しか分からない
- 方向は、分割表の$b$と$c$を直接見比べれば分かる
- $b$(Aは正解・Bは不正解):現行モデルで悪化したサンプル
- $c$(Aは不正解・Bは正解):現行モデルで改善したサンプル
- $c > b$なら改善が優勢、$b > c$なら退行が優勢
- つまり「有意な差があるか」はマクネマー検定、「どちらの方向か」は$b$と$c$の大小比較、という役割分担になる
- 機械学習におけるデータセットの分割の再考で触れたerr split(過去のエラーを固定化した回帰テスト用データ)に対してこの判定を行えば、モデル更新のたびに退行していないかを統計的に確認できる
退行の原因を特定し、処方箋を作る
モデル更新の多くはTrainデータの追加によって起きるため、$b$(退行したサンプル)が見つかった場合、その原因は追加したデータにあることが多い。
- $b$の集合と、新しく追加したTrainデータを見比べ、特徴やパターンに共通点がないかを確認する
- よくある原因は次の2つ
- 追加データが$b$の集合とSpurious Correlationを共有しており、モデルが誤った特徴を学習してしまった
- 追加データによってクラス間の量のバランスが崩れ、機械学習におけるデータとデータソースの再考の「相対的な量にも注意する」で触れたように、モデル容量が追加データ側に取られて上書きされた
- 原因が特定できたら、$b$の集合に似ているが正しいラベルを持つ「対称データ」を作り、Trainに追加する
- これは機械学習におけるデータセットの分割の再考で触れた処方箋splitそのもので、機械学習におけるクラスとラベルの再考のhard case mining手法(Truncated Negative・adversarial negativesなど)や、対称的な属性のPair.json(Dyad pair)の考え方がそのまま使える
- 処方箋splitをTrainに戻して再学習した後、再びマクネマー検定にかけて退行が解消したかを確認する、という診断→処方箋のループになる
関連する検定
- 5×2 cvペアードt検定(Dietterich, 1998):交差検証を使う場合に、複数の分割を組み合わせてより安定した検定を行う方法。5×2交差検証自体については交差検証の種類で扱っている
- ブートストラップ法・permutation test:分布の仮定を置かずに、リサンプリングによって差の有意性を評価するノンパラメトリックな方法
- Cochranの Q検定:3つ以上の分類器を同時に比較する場合の、マクネマー検定の拡張
まとめ
- マクネマー検定は、同じテストセットに対する2つのモデルの正解・不正解のペアから、その差が統計的に有意かを検定する手法
- 一致するペア($a$、$d$)は情報を持たず、不一致のペア($b$、$c$)だけで検定する
- 見た目の精度差があっても、不一致ペアの数が少なければ統計的に有意とは言えない場合がある
- 検定はあくまで「差がないとは考えにくい」ことを示すだけで、効果量やその差の実務的な重要性は別に評価する必要がある
- 過去モデルと現行モデルの比較に使えば、$b$と$c$の大小からモデルが改善したか退行したかの方向も分かる。err splitに対して継続的に行えば、モデル更新ごとの退行検知にもなる
- 退行が見つかった場合は、$b$の集合と追加したTrainデータを見比べて原因を特定し、対称データ(処方箋split)を作ってTrainに戻すという診断→処方箋のループにつなげられる
参考文献
- McNemar, Q. (1947). “Note on the sampling error of the difference between correlated proportions or percentages”
- Dietterich, T. G. (1998). “Approximate Statistical Tests for Comparing Supervised Classification Learning Algorithms”
- McNemar’s test - Wikipedia
- 分布外データの対処方法