目次
背景
- もともとは、VRAMに乗る範囲でバッチサイズをできるだけ上げれば、それだけ効率的に学習できると思っていた
- しかしある実験でバッチサイズを32から16に変えたところ、結果に大きな差が出た
- ログを見ると、エポック0終了時点のglobal_step(パラメータ更新回数)が、バッチサイズ32では約50,974、バッチサイズ16では約100,874と、ほぼ2倍になっていた
- 同じ1エポック(同じ量のデータを1回ずつ見る)でも、バッチサイズを変えるとパラメータ更新の回数自体が変わり、学習の進み方に大きな差が出る
- これをきっかけに、バッチサイズが学習効率にどう影響するかを整理する
- 整理にあたって、関連する論文・概念の要約はAIにまとめてもらった
事前知識
Optimizer(オプティマイザー)
- 勾配を使って、パラメータをどう更新するかを決めるアルゴリズム
- SGD(確率的勾配降下法)、Momentum、Adam、AdamWなどの種類がある
- どれも「与えられた学習率と勾配から、パラメータをどの方向・どれくらい動かすか」を計算する役割を持つ
Learning Rate Scheduler(学習率スケジューラ)
- Optimizerが使う学習率そのものを、訓練の進み具合(global stepやepoch数)に応じて変化させる、Optimizerとは別の仕組み
- 代表的な種類
| 種類 | 挙動 |
|---|---|
| StepLR | 一定のstep数ごとに、学習率を一定の割合で下げる |
| CosineAnnealingLR | コサイン関数の形に沿って、滑らかに学習率を下げていく |
| Linear Warmup + Decay | 最初に学習率を線形に上げてから、その後線形または他の形で下げる |
- 後述するLinear Scaling Ruleのウォームアップや、学習率を下げる代わりにバッチサイズを増やすという話は、いずれもこのSchedulerの役割にあたる
- SchedulerがOptimizerに渡す学習率の値を、global_step(またはepoch)を見ながら動的に書き換えている、という関係になる
バッチサイズとは
- バッチサイズとは、1回のパラメータ更新(optimizer step)に使うサンプル数のこと
- 1回の更新に何件使うかによって、以下の3つに分類できる
| 手法 | バッチサイズ | 特徴 |
|---|---|---|
| フルバッチ勾配降下法 | 全データ($N$件) | 勾配は真の勾配に一致するが、1エポックに1回しか更新できない。DNNではデータ量が大きすぎて、ほぼ使われない |
| ミニバッチ勾配降下法 | バッチサイズ分(例: 16〜数千) | 1エポックで複数回更新でき、勾配ノイズによる正則化効果もある。DNNの実務で最も一般的 |
| 確率的勾配降下法(SGD) | 1件 | 本来の定義では1件ずつ更新する手法。GPUの並列性を活かせず、Batch Normalizationも機能しないため、DNNでは直接使われることは少ない |
- 実務ではミニバッチ勾配降下法を指して「SGD」と呼ぶことも多く、厳密な1件ずつの定義とは区別せずに使われがちなので注意
エポックとoptimizer stepの違い
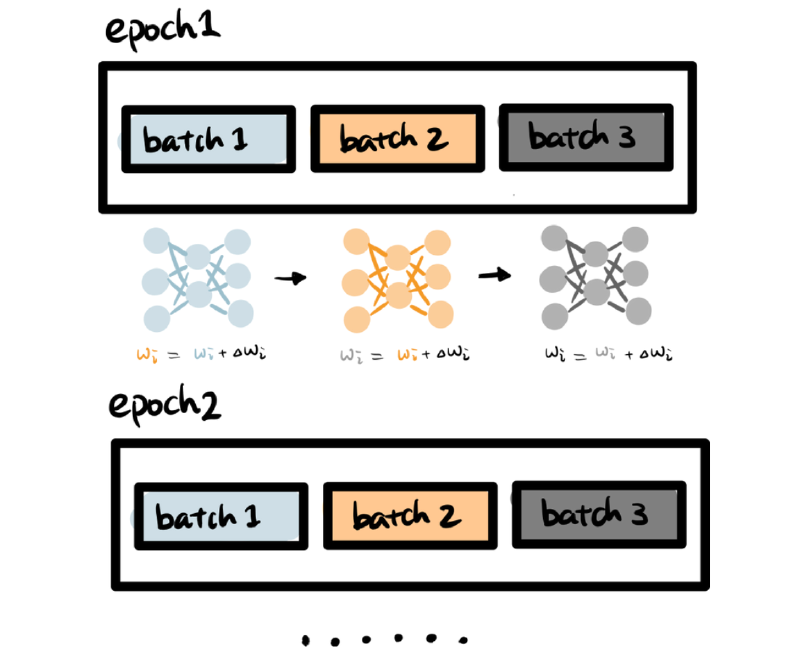
- データ数を$N$とすると、1エポックあたりのoptimizer step数は、おおよそ$N/\text{バッチサイズ}$になる
- バッチサイズ32なら1エポックあたり約$N/32$ step、バッチサイズ16なら約$N/16$ stepで、バッチサイズを半分にすると、1エポックあたりのパラメータ更新回数はほぼ2倍になる
- ただし、これは「学習データを2倍見た」という意味ではない。1エポックで見るサンプル数自体はどちらも同じ$N$件。違うのは、同じ$N$件を何回に分けて更新するかという点
- バッチサイズ32: 32件のデータから勾配を平均して1回更新
- バッチサイズ16: 16件のデータから勾配を平均して1回更新し、次の16件でもう1回更新
- つまり同じ32件を見る間に、バッチサイズ32では1回の更新だが、バッチサイズ16では2回の更新が起こる
- 学習率が同じなら、更新回数が多い方がパラメータが細かく・頻繁に動くため、最終的な結果が大きく変わりうる。さらに小さいバッチサイズほど勾配のばらつきも大きくなるため、単に「更新回数が2倍」というだけでなく、最適化そのものの性質も変化する
- 学習率スケジューラ(LR scheduler)がglobal_step基準で動いている場合、学習率スケジュール自体の進み方も変わる。バッチサイズが半分になれば、同じエポック数でも学習率スケジュールは約2倍の速さで進んでしまう
Effective Batch Size
- Gradient Accumulation(勾配累積)やマルチGPU学習を使う場合、実際にoptimizerが1回更新するときに使われるサンプル数は、以下の式になる
- 例えば、バッチサイズ16でもGradient Accumulationのステップ数が2なら、実効バッチサイズは32になり、optimizerの更新回数は原則バッチサイズ32のときと同等になる
- バッチサイズを比較する際は、単純なバッチサイズの数字だけでなく、この実効バッチサイズで揃えて比較する必要がある
勾配のノイズと汎化性能
- バッチサイズが大きいほど、勾配の推定値は真の勾配(全データで計算した勾配)に近づき、ノイズ(分散)は小さくなる
- 逆にバッチサイズが小さいほど、勾配推定のノイズは大きくなる
- このノイズは単なる邪魔者ではなく、暗黙の正則化として働くことが知られている。Keskar et al. (2016) “On Large-Batch Training for Deep Learning: Generalization Gap and Sharp Minima"は、大きいバッチサイズでの学習が、損失関数の鋭い局所解(Sharp Minima)に収束しやすく、汎化性能(テストデータへの適応性)が落ちやすいことを示した
- 一方、小さいバッチサイズの勾配ノイズは、学習を鋭い局所解から逃がし、より平坦な局所解(Flat Minima)に収束させる効果があり、結果的に汎化性能が良くなりやすいとされる
バッチサイズを小さくする追加のメリット
ここまでのSharp/Flat Minimaの話は、最終的な解の汎化性能に関する効果だった。これとは別に、学習の過程そのものに対するメリットもある。
サドルポイントからの脱出
- Dauphin et al. (2014) “Identifying and attacking the saddle point problem in high-dimensional non-convex optimization"は、深層学習のような高次元の非凸最適化で学習が停滞する主な原因は、局所最小値ではなくサドルポイント(鞍点)だと指摘した
- サドルポイント周辺は勾配がほぼゼロの平坦なプラトーに囲まれており、学習が極端に遅くなる
- Jin et al. (2017) “How to Escape Saddle Points Efficiently"は、勾配にノイズ(摂動)を加えることで、ほぼ追加コストなしにサドルポイントから脱出できることを示した
- 小さいバッチサイズの勾配ノイズは、まさにこの摂動の役割を果たす。これはSharp/Flat Minima(最終的な解の汎化性能)とは別軸で、学習の途中で停滞しにくいという、プロセスそのものへの効果
Batch Normalizationの統計量のノイズ
- Batch Normalizationを使う場合、バッチ内の平均・分散(統計量)自体も、バッチサイズが小さいほどノイズが増える
- この統計量のノイズも、勾配のノイズとは別に、追加の正則化効果を持つことが知られている
- ただしバッチサイズが極端に小さいと(目安として8未満など)、統計量自体が不安定になりすぎてBatch Normalizationがうまく機能しなくなる。その場合は、GroupNormやLayerNormのような、バッチサイズに依存しない正規化手法に切り替えることもある
ロングテール・希少クラスの対応
バッチサイズは、ロングテール分布(一部のクラスだけ極端に少ない)や希少な難しいサンプルの学習にも間接的に関わる。ただし直接の対策ではないため、実際に使われる手法とあわせて整理する。
バッチサイズとの関係
- データ全体に対する希少クラスの割合を$p$、バッチサイズを$B$とすると、1バッチあたりの希少クラスの期待出現回数は$B \times p$になる
- バッチサイズを小さくすると、希少クラスが1バッチに出現する確率は下がる。しかし、出現したときにその1件が勾配平均に占める重みは$\frac{1}{B}$なので、バッチサイズを小さくするほど大きくなる
- この2つの効果は、期待値の上では打ち消し合う
- つまり、1バッチあたりの希少クラスの平均的な寄与度は、バッチサイズを変えても変わらない。1エポックでどう分割しても、希少クラスのサンプルは結局全部1回ずつ見るため、これは当然の結果でもある
- ただし「平均」が同じでも「分散(バラつき方)」は異なる
- バッチサイズが小さい: ほとんどのバッチで希少クラスの寄与はゼロだが、出現したバッチでは、競合する他のサンプルが少ないため、そのバッチの勾配方向への影響力は相対的に大きくなる
- バッチサイズが大きい: 希少クラスが出現する頻度は上がるが、同じバッチ内の多数派クラスのサンプルに勾配が埋もれて薄まりやすい
- つまりバッチサイズを小さくすると、希少クラスが出現したときに「他のサンプルに埋もれず、相対的に強い影響力を持つ」という効果がある
- ただし、この「薄められていない1ステップの影響力」が、学習全体に定着するかどうかは別問題
- バッチサイズ1(純粋なSGD)を想像すると、希少サンプルが出たその瞬間はパラメータを完全にその方向へ動かせるが、直後に続く多数派クラスのステップが、パラメータを多数派の方向へすぐに押し戻してしまう可能性がある。これは破滅的忘却(Catastrophic Forgetting)に近い現象
- 1件だけの勾配は、複数件の平均と違って個体差(たまたまのノイズ、ラベルノイズなど)がそのまま反映されてしまうため、その1件固有のクセを拾ってしまうリスクもある
- つまり「出現した瞬間の影響力」はバッチサイズを小さくする方が大きいが、「それが結果として希少クラスの学習に定着するか」は別軸の問題で、必ずしも保証されない
- これは1エポックに希少クラスが出現する総回数自体を増やすわけでもないため、重み付けサンプリングやFocal Lossほど確実な対策にはならない
重み付けサンプリング
- 希少クラスのサンプリング確率を、元の頻度$p$より高い$p'$に人為的に引き上げる手法。機械学習におけるクラスとラベルの再考のHard Negative Miningとも関連する
- バッチサイズの調整とは違い、$p$自体を上げるため、1バッチあたりの平均的な寄与度も$p'$に上がり、根本的な解決に近づく
- ただし2つの副作用がある
- 過学習のリスク: 希少クラスの実サンプル数が少ない場合、同じ少数の実例を何度も繰り返し見せることになり、そのクラスの一般的な特徴ではなく具体例そのものを記憶してしまうリスクがある
- 分布のズレ: 訓練時の見かけの分布(重み付け後)と、実際の運用時のデータ分布(元の$p$)がズレるため、モデルが学習する事前分布が歪み、推論時の確信度(確率の出力)をそのままでは信頼できなくなることがある。運用時にこの歪みを補正するキャリブレーションが必要になる場合がある
Focal Loss
- Lin et al. (2017) “Focal Loss for Dense Object Detection"が提案した手法
- サンプリング自体を変えるのではなく、損失関数側で簡単な(多数派の)サンプルの損失を減衰させ、難しい・少数派のサンプルに学習を集中させる
- 全サンプルを見る頻度自体は変えないため、重み付けサンプリングの「同じ実例を繰り返し見て過学習する」リスクを避けやすい
- 元々は物体検出(RetinaNet)における、簡単な負例が多数を占める極端なクラス不均衡を解決するために提案された
Linear Scaling Rule
- Goyal et al. (2017) “Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour"が提示した手法
- バッチサイズを$k$倍にするときは、学習率も$k$倍にするという、ハイパーパラメータ探索を必要としないシンプルな調整ルール
- これだけでは学習初期が不安定になりやすいため、学習率を訓練初期に徐々に上げていくウォームアップ(Warmup)を併用する
- この2つを組み合わせることで、バッチサイズ8192のような大規模バッチでも、小規模バッチと同等の精度を達成し、ImageNetの学習を1時間に短縮した
学習率を下げる代わりにバッチサイズを増やす
- Smith et al. (2017) “Don’t Decay the Learning Rate, Increase the Batch Size”(ICLR 2018)が提示した考え方
- 学習率$\varepsilon$とバッチサイズ$B$の間には、$B \propto \varepsilon$という比例関係がある
- 従来は学習が進むにつれて学習率を下げていく(Learning Rate Decay)のが一般的だったが、学習率を下げる代わりにバッチサイズを増やしていくことでも、同じ学習曲線を再現できることを示した
- バッチサイズを増やす方法には、必要なパラメータ更新回数そのものを減らせる、ハードウェアの並列計算を活かしやすいという利点がある
- この手法で、ResNet-50によるImageNetの学習を、30分未満・76.1%の精度で完了させた
クリティカルバッチサイズ
- McCandlish et al. (2018, OpenAI) “An Empirical Model of Large-Batch Training"が提示した考え方
- 勾配のノイズスケール(Gradient Noise Scale)という指標が、ドメインごとに異なる「有用な最大バッチサイズ(クリティカルバッチサイズ)」を予測できることを示した
- クリティカルバッチサイズまでは、バッチサイズを増やすほど、目標の損失に到達するために必要なステップ数がほぼ線形に減っていく。つまりバッチサイズを2倍にすれば、必要なステップ数はほぼ半分になり、ハードウェアの並列化によってほぼそのまま学習時間の短縮につながる
- クリティカルバッチサイズを超えると、ステップ数の減り方が鈍くなり、同じ性能に到達するために必要な総計算量(サンプル数×ステップ数)がむしろ増えていく
- つまりバッチサイズを増やしても学習が無限に速くなるわけではなく、ドメインやモデルの性能向上に応じて変化する、ある程度の最適なバッチサイズが存在する
まとめ
- バッチサイズを変えると、同じエポック数でもoptimizer stepの回数自体が変わるため、学習の進み方・学習率スケジュールの進み方が変わる。「エポック」という単位だけでバッチサイズの違う実験を比較するのは不十分
- Gradient Accumulationやマルチ GPUを使う場合、比較には実効バッチサイズ(バッチサイズ×Gradient Accumulationステップ×GPU数)を揃える必要がある
- 小さいバッチサイズは勾配ノイズが大きく、暗黙の正則化によって汎化性能が良くなりやすいが、ハードウェアの並列性を活かせず訓練が遅くなりやすい
- 小さいバッチサイズの勾配ノイズは、サドルポイントからの脱出を助け、学習が途中で停滞しにくくなるという、最終的な汎化性能とは別のメリットもある。Batch Normalizationを使う場合は、統計量自体のノイズによる追加の正則化効果もあるが、バッチサイズが極端に小さいと統計量が不安定になる
- ロングテール・希少クラスへの平均的な寄与度はバッチサイズを変えても不変だが、小さいバッチサイズは出現時の影響力が相対的に大きくなる。根本的な対策には、サンプリング確率そのものを上げる重み付けサンプリングや、損失側で難しいサンプルに学習を集中させるFocal Lossが使われる
- 大きいバッチサイズは勾配推定が正確でハードウェア効率が良いが、Sharp Minimaに収束しやすく汎化性能が落ちやすいため、Linear Scaling Ruleのように学習率を調整する工夫が必要になる
- 学習率を下げる代わりにバッチサイズを増やすという考え方もあり、どちらも同じノイズスケールの調整として捉えられる
- クリティカルバッチサイズを超えてバッチサイズを増やしても、学習速度の向上は鈍っていくため、無条件にバッチサイズを大きくすればよいわけではない
参考文献
- Dauphin, Y., et al. (2014). “Identifying and attacking the saddle point problem in high-dimensional non-convex optimization”
- Jin, C., Ge, R., Netrapalli, P., Kakade, S. M., & Jordan, M. I. (2017). “How to Escape Saddle Points Efficiently”
- Keskar, N. S., et al. (2016). “On Large-Batch Training for Deep Learning: Generalization Gap and Sharp Minima”
- Goyal, P., et al. (2017). “Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour”
- Smith, S. L., Kindermans, P., Ying, C., & Le, Q. V. (2017). “Don’t Decay the Learning Rate, Increase the Batch Size”
- McCandlish, S., Kaplan, J., Amodei, D., & OpenAI Dota Team (2018). “An Empirical Model of Large-Batch Training”
- Lin, T.-Y., Goyal, P., Girshick, R., He, K., & Dollár, P. (2017). “Focal Loss for Dense Object Detection”
- 機械学習におけるクラスとラベルの再考