目次
背景
- 確率的グラフィカルモデルの分類で、生成モデルの代表例としてNaive Bayesを扱ったが、仕組みを詳しく見ていなかった
- この記事では、Naive Bayes(ナイーブベイズ)分類器の仕組みと、具体的な計算例を整理する
ナイーブベイズとは
- 教師あり学習の分類手法の1つで、スパムメール判定や文書分類など、自然言語処理の分類タスクで古くから使われている
- 特徴量$X$の各要素がクラス$Y$ごとに独立に生成されると仮定した、生成モデルの分類器
- 「ナイーブ(素朴)」という名前は、この特徴量同士の独立性という、現実には成り立たないことが多い強い仮定を置いていることに由来する
特徴
- シンプルな仮定にもかかわらず、実務では十分な精度が出ることが多い
- 少量の学習データでも機能しやすい
- 計算が軽く、学習・推論が高速
- 特徴量の数が増えても(次元の呪いの影響を受けにくく)性能が落ちにくい
- 一方で、出力される確率の値そのものは、実際の発生確率としては信頼できないことが多い(相対的な大小関係の比較には使える)
計算方法
ベイズの定理
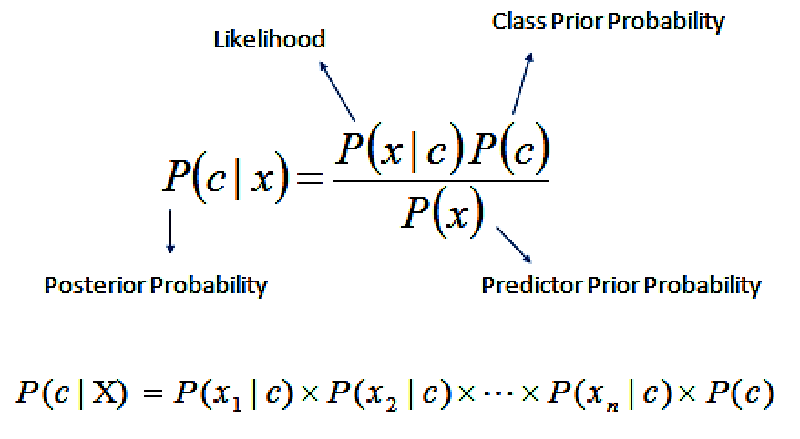
- ナイーブベイズの土台になるのが、ベイズの定理
- $P(Y)$: 事前確率(クラス$Y$が起こる確率)
- $P(X\mid Y)$: クラス$Y$のときに特徴量$X$が観測される確率
- $P(Y\mid X)$: 特徴量$X$が観測されたときに、クラスが$Y$である確率(これを知りたい)
ナイーブベイズの計算
- 特徴量$X$が$x_1,\ldots,x_n$という複数の要素からなるとき、$P(X\mid Y)$をそのまま計算するのは難しい
- そこで、$x_1,\ldots,x_n$が互いに独立だと仮定し、同時確率を積の形に単純化する
- 分類時は、$X$が与えられたときに$P(Y\mid X)$が最大になる$Y$を選ぶ。$P(X)$はどのクラスでも共通の値なので、比較には不要
計算例
- 「お金 当選 無料」のような単語の並びを、迷惑メール(Spam)か通常メール(Ham)かに分類する例を考える
- 学習データは以下の6件
| カテゴリ | 文章 |
|---|---|
| Spam | お金 当選 無料 |
| Spam | 当選 無料 クリック |
| Spam | お金 クリック 当選 |
| Ham | 会議 資料 送付 |
| Ham | 明日 会議 時間 |
| Ham | 資料 確認 お願い |
- 各単語の出現回数を数えると、Spamは9語(お金2、当選3、無料2、クリック2)、Hamも9語(会議2、資料2、送付1、明日1、時間1、確認1、お願い1)
- 単語の種類(語彙数)は、両方のカテゴリを合わせて11種類
- 学習データに出現しない単語の確率が0になってしまう問題を避けるため、ラプラススムージング(全ての単語の出現回数に1を足す)を使う
- $N_Y$はクラス$Y$の全単語数、$V$は語彙数
- 新しい文章「当選 クリック」を分類する場合
- 事前確率はどちらも$P(\text{Spam})=P(\text{Ham})=3/6=0.5$なので
- この2つの値を正規化すると、Spamである確率は約92.3%、Hamである確率は約7.7%になり、「当選 クリック」はSpamに分類される
まとめ
- ナイーブベイズは、特徴量同士が独立という強い仮定のもとで、ベイズの定理を使ってクラスを分類する生成モデル
- 計算が軽く、少量のデータでも機能しやすいため、スパム判定や文書分類で古くから使われている
- 学習データに出現しない単語の確率が0になる問題を避けるため、ラプラススムージングを使うのが一般的
- 確率的グラフィカルモデルの分類では、ナイーブベイズは独立データに対する生成モデルの代表例として位置づけられる