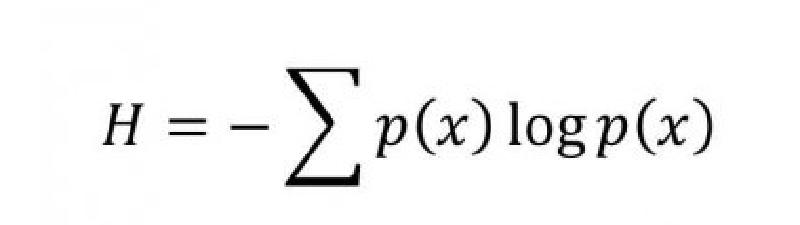
目次
背景
- 以前ブルーバックスでシャノンの情報量について書かれた本を読んだことがあるが、時間が経って内容をだいぶ忘れかけている
- ベイズ実験計画法の期待情報利得(EIG)が相互情報量として定義されていることに改めて気づき、相互情報量の定義自体を曖昧にしか覚えていないことに気づいた
- そこで、忘れないうちに自己情報量・エントロピー・相互情報量の関係を整理しておく
- 自己情報量とエントロピーの基礎は機械学習でよく出るシャノンの情報量で既にまとめているので、ここでは簡単におさらいした上で、相互情報量を中心に扱う
自己情報量とエントロピーのおさらい
- 自己情報量: ある出来事$x$が実際に起きたときの「驚きの大きさ」。珍しい出来事ほど大きい
- エントロピー: 自己情報量の期待値。結果を見る前の「平均的な不確実性」
- 確率分布が均等なほどエントロピーは大きく、偏っているほど小さい
- 詳しい導出・直感(なぜ対数を使うか、bitとnatの違いなど)は機械学習でよく出るシャノンの情報量を参照
結合エントロピーと条件付きエントロピー
相互情報量を定義する前に、2つの確率変数を扱うエントロピーを整理しておく。
結合エントロピー(Joint Entropy)
- 確率変数$X$と$Y$を同時に観測したときの、全体の不確実性
条件付きエントロピー(Conditional Entropy)
- $X$の値が分かった後に、$Y$に残っている不確実性の期待値
- $X$を知ることで$Y$の予測がどれだけ楽になるかを表す量
- $X$と$Y$が独立なら、$X$を知ってもYの不確実性は減らないため$H(Y\mid X)=H(Y)$になる
- $X$が$Y$を完全に決定するなら、$X$を知った時点で$Y$の不確実性はゼロになるため$H(Y\mid X)=0$になる
連鎖律(Chain Rule)
- 結合エントロピーは、条件付きエントロピーを使って以下のように分解できる
- 「XとYを合わせた不確実性」は、「Xだけの不確実性」と「Xが分かった後に残るYの不確実性」の和に等しい、という直感的な式
相互情報量(Mutual Information)
定義
- 相互情報量$I(X;Y)$は、「Xを知ることで、Yの不確実性がどれだけ減るか」を表す量
- 連鎖律を使うと、対称な形にも書き換えられる
- つまり、「Xを知ってYの不確実性が減る量」と「Yを知ってXの不確実性が減る量」は常に等しい。これが「相互」情報量と呼ばれる理由
直感的なイメージ
- $X$と$Y$が独立: $X$を知ってもYの予測は何も変わらないので$H(Y\mid X)=H(Y)$、よって$I(X;Y)=0$
- $X$が$Y$を完全に決定する: $X$を知った瞬間に$Y$が確定するので$H(Y\mid X)=0$、よって$I(X;Y)=H(Y)$(最大)
- 相互情報量は、0(全く無関係)から$\min(H(X),H(Y))$(一方が他方を完全に決定する)までの範囲を取る
確率分布を使った別の表現
相互情報量は、同時分布$p(x,y)$と周辺分布の積$p(x)p(y)$のKLダイバージェンス(相対エントロピー)としても定義できる。
$$ I(X;Y) = D_{\text{KL}}\bigl(p(x,y) \,\|\, p(x)p(y)\bigr) = \sum_x\sum_y p(x,y)\log\frac{p(x,y)}{p(x)p(y)} $$- $p(x,y)=p(x)p(y)$(独立)であれば、このKLダイバージェンスは0になる
- $X$と$Y$の同時分布が、独立を仮定した分布からどれだけ離れているかを測っている、とも解釈できる
- つまり相互情報量は「エントロピーの差」であると同時に「同時分布と独立分布のズレ」でもあり、2つの見方が同じ量に一致する
ベイズ実験計画法との接続
- ベイズ実験計画法で扱った期待情報利得(EIG)は、まさにこの相互情報量そのもの
- $\theta$(モデルパラメータ)についての事前分布$p(\theta)$のエントロピーから、実験結果$Y$を観測した後の条件付きエントロピーの期待値を引いたもの、という構造になっている
- 「情報量が大きい実験=結果の不確実性(エントロピー)が高い実験」という直感的な言い方は、厳密には「その実験のEIG(相互情報量)が大きい」という意味であり、相互情報量自体はエントロピーの差分として定義されている
- つまり、ベイズ実験計画法での「最も不確実な実験を選ぶ」という発想は、シャノンのエントロピーの概念を土台にして、相互情報量という形で定式化されたもの
まとめ
- 自己情報量は1回の出来事の驚きの大きさ、エントロピーはその平均(不確実性)
- 条件付きエントロピー$H(Y\mid X)$は、Xを知った後に残るYの不確実性
- 相互情報量$I(X;Y)=H(Y)-H(Y\mid X)$は、Xを知ることでYの不確実性がどれだけ減るかを表し、XとYについて対称
- 相互情報量は、同時分布と独立分布のKLダイバージェンスとしても表現でき、2つの見方が一致する
- ベイズ実験計画法の期待情報利得(EIG)は、この相互情報量そのものであり、エントロピーという土台の上に組み立てられた量
参考文献
- 機械学習でよく出るシャノンの情報量
- ベイズ実験計画法
- Shannon, C. E. (1948). “A Mathematical Theory of Communication”
- Cover, T. M., & Thomas, J. A. “Elements of Information Theory”