目次
背景
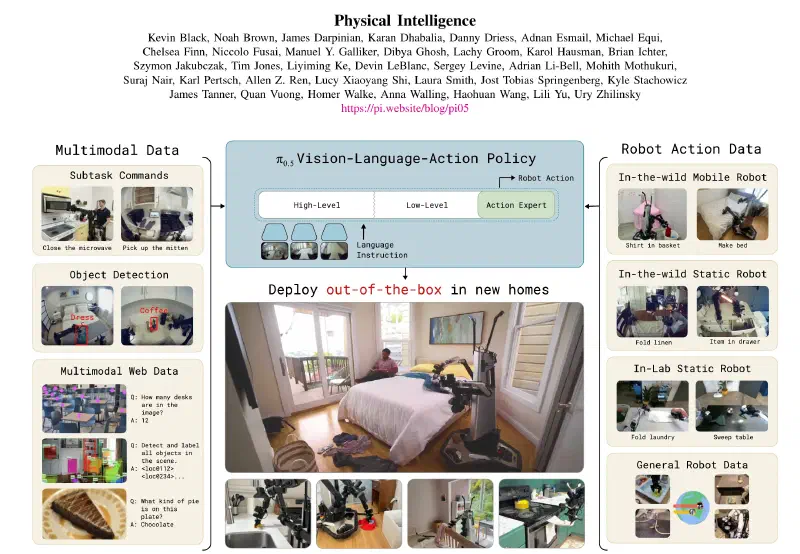
- Physical Intelligence社が発表したロボット基盤モデル「π0.5(pi oh five)」について、論文「π0.5: a Vision-Language-Action Model with Open-World Generalization」(arXiv:2504.16054)をAIにまとめてもらった
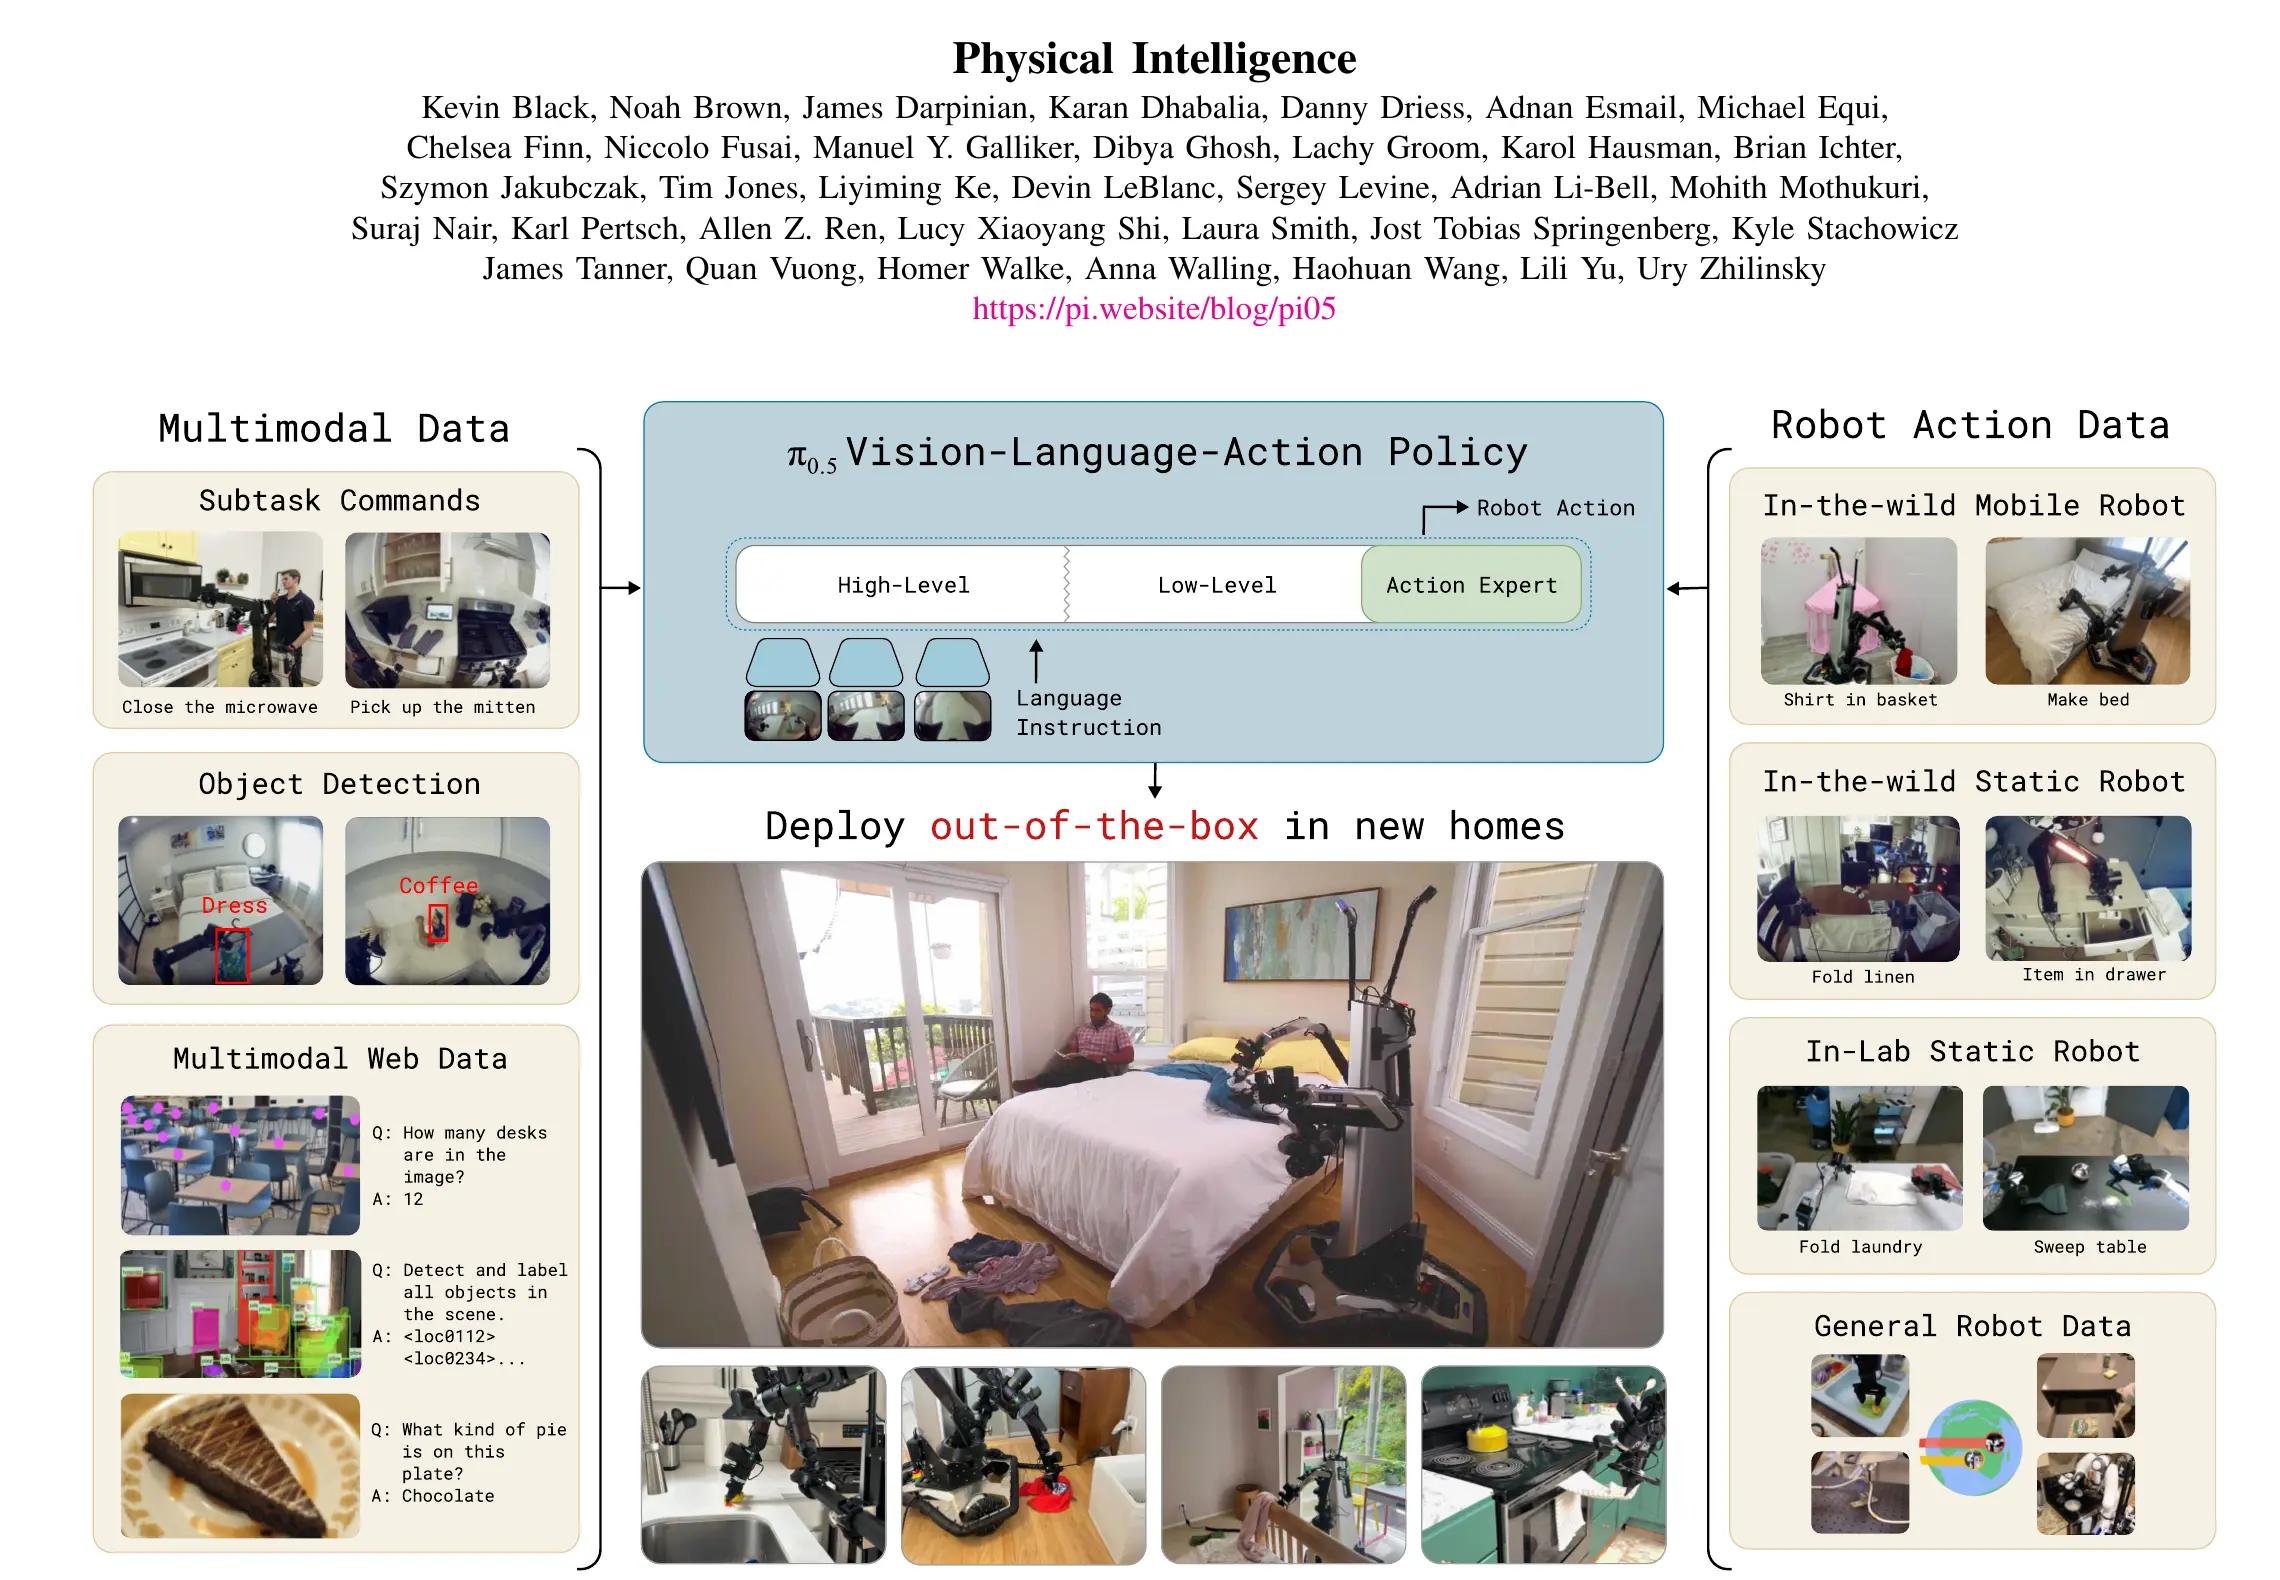
- 前身の「π0」を拡張し、学習に一度も登場しない家庭環境でも、キッチンの片付けや寝室の整理のような複数ステップのタスクをこなせる点が特徴
π0.5とは
Vision-Language-Action(VLA)モデル
- カメラ画像・言語指示・ロボットの関節状態を入力とし、ロボットの行動(アクション)を出力するモデルの総称
- 事前学習済みのVision-Languageモデル(VLM)をベースに、行動生成能力を追加する設計が主流
- π0.5は前身のπ0と同じくVLAモデルの一種で、SigLIP(画像エンコーダ)とGemma(言語モデル、2.6B)をベースに構築されている
open-world generalizationというテーマ
- 多くのロボット学習システムは、学習時に見た環境・物体に近い状況でしか評価されない
- π0.5は学習データに一切含まれない実際の家庭(キッチン・寝室)で評価され、10〜15分かかるような長時間・多段階の作業を完遂できることを示した
- 評価では「散らかった食器をシンクに入れる」「ベッドを整える」のような、曖昧な高レベル指示から具体的な動作列を自分で組み立てる必要がある
アーキテクチャ
階層構造
π0.5は、1つのモデルの中に「高レベル推論」「低レベル推論」「Action Expert」という3つの役割を持たせている。
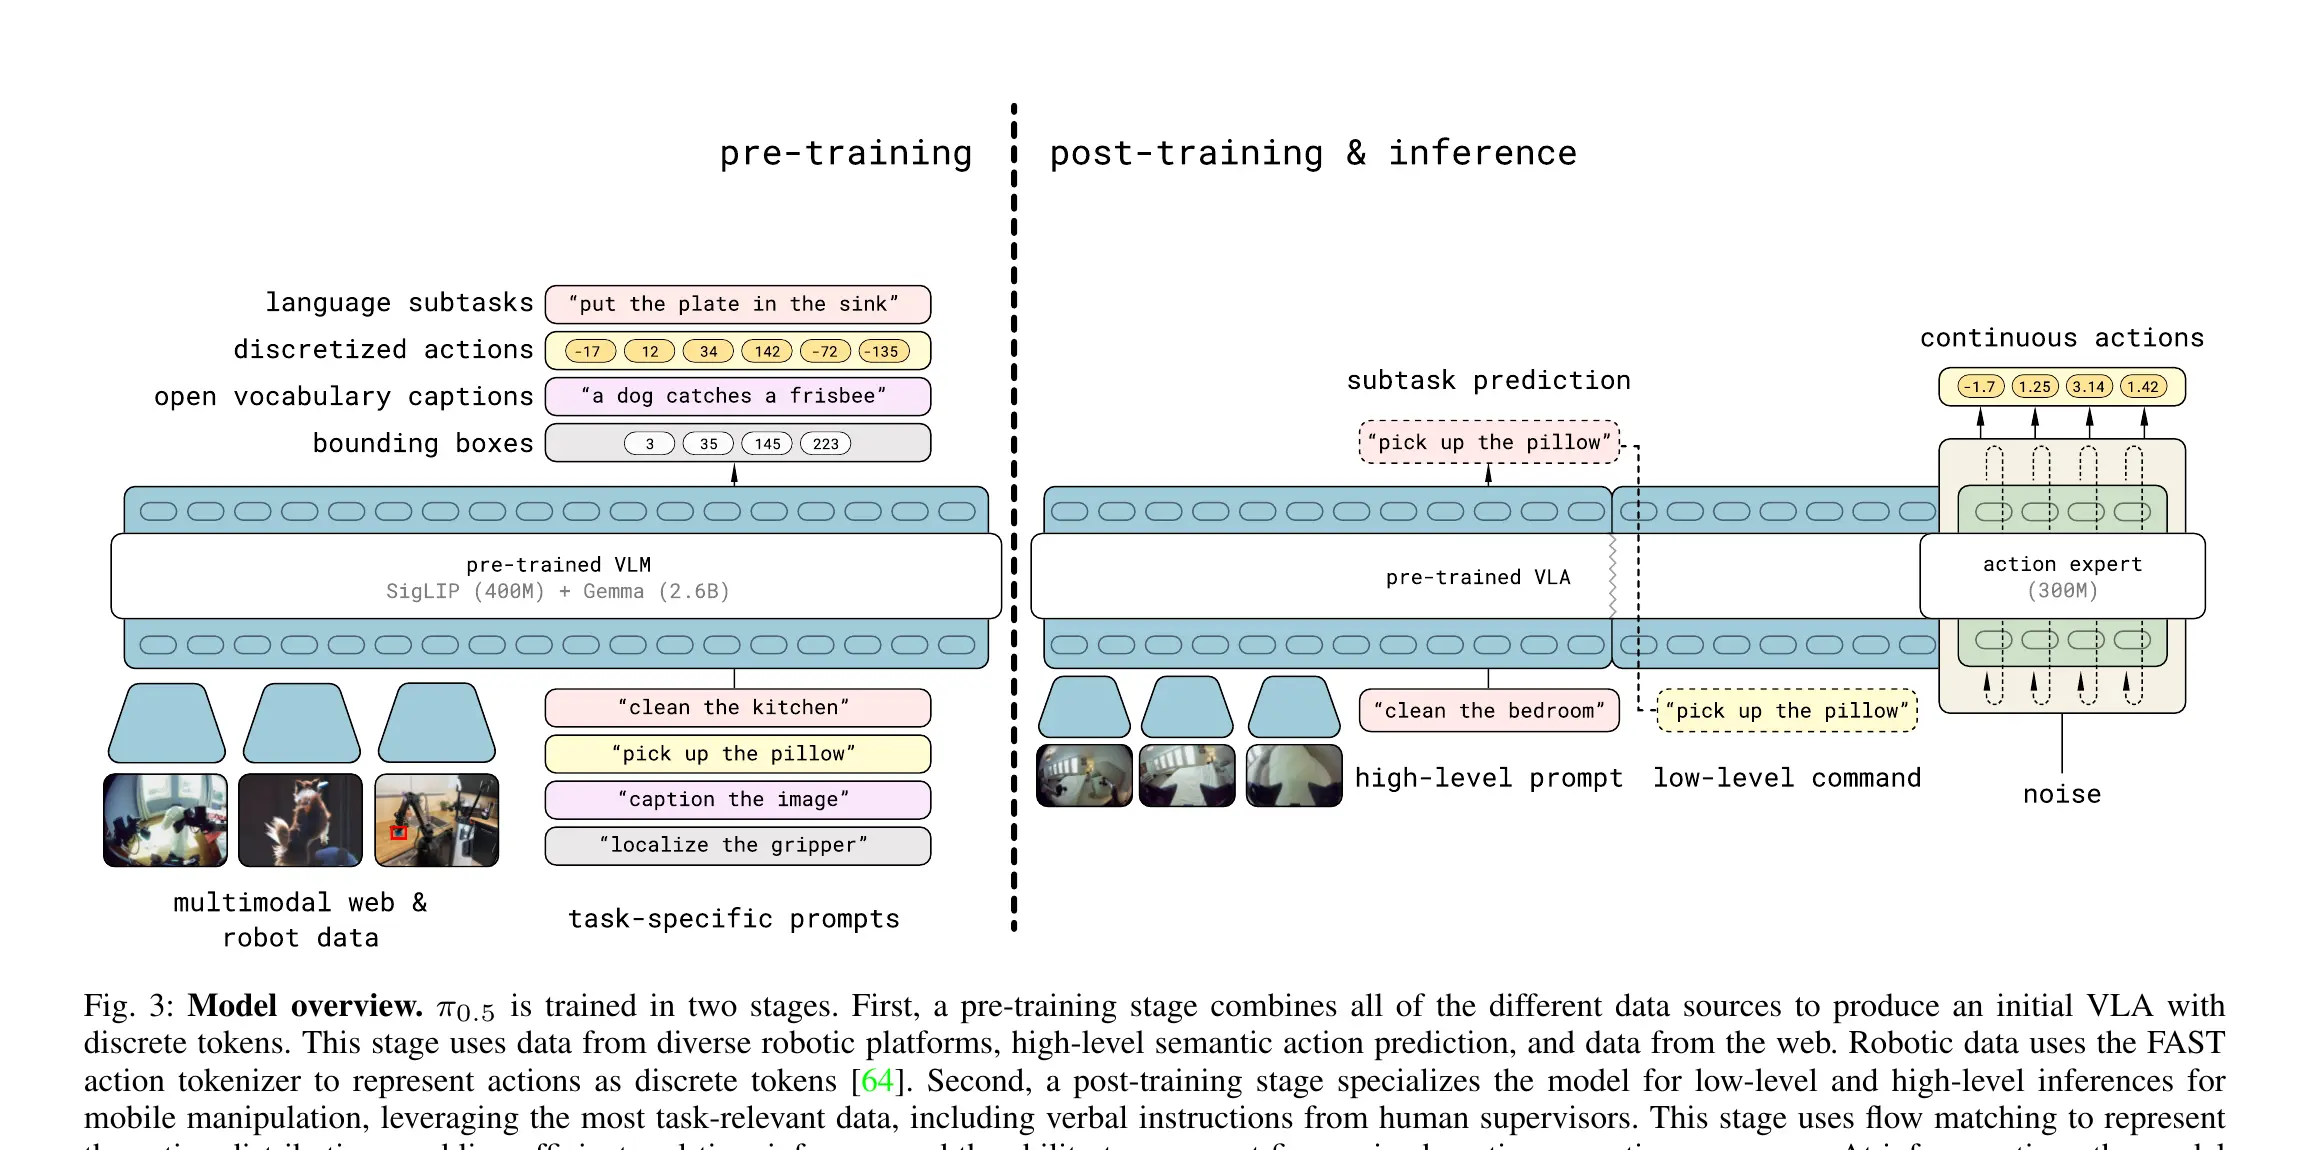
- High-Level: カメラ画像と高レベル指示(例: “clean the bedroom”)から、次に行うべきサブタスク(例: “pick up the pillow”)をテキストとして予測する
- Low-Level: 画像と直前に予測したサブタスクを条件に、低レベルの行動チャンク(関節角度やグリッパーの軌道)を予測する
- Action Expert: Low-Level推論の中で、連続値のアクションをFlow Matchingという手法で生成する専用の重み(元のモデルより小さいサブネットワーク)
flowchart LR
    Obs["カメラ画像<br>(4台)"] --> VLA
    Prompt["高レベル指示<br>例: clean the bedroom"] --> VLA
    subgraph VLA["π0.5 モデル"]
        direction LR
        HL["High-Level<br>サブタスク推論<br>例: pick up the pillow"] --> LL["Low-Level<br>低レベル推論"]
        LL --> AE["Action Expert<br>Flow Matching"]
    end
    AE --> Action["連続アクション<br>関節角度・グリッパー・ベース速度"]
Action -.次のステップで再度観測.-> Obs- 推論時は毎ステップ、まず高レベルのサブタスクを推論し、それを条件にして低レベルの行動を予測する2段構えになっている
- この構造は、大規模言語モデルのchain-of-thoughtに近い発想で、複雑なタスクを「今何をすべきか」という中間ステップに分解してから行動する
離散トークンとFlow Matchingの併用
- 行動の表現方法には、離散トークン化(FASTというトークナイザ)と、連続値を扱えるFlow Matchingの2種類がある
- 離散トークンは学習が高速で安定するが、推論時に自己回帰的なデコードが必要になり遅い
- Flow Matchingは少ないステップ(10ステップ程度のdenoising)で連続的な行動を生成でき、リアルタイム制御に向く
- π0.5は事前学習で離散トークンを使い、事後学習でAction Expertを追加してFlow Matchingによる連続行動生成を学習する、という2段階の設計でこの両方の利点を得ている
学習データの多様性(co-training)
π0.5の核心は、モデル構造そのものよりも「何を一緒に学習させるか」という学習データの設計にある。
事前学習(pre-training)
事前学習では、ロボットから集めた行動データだけでなく、性質の異なる複数のデータソースを同時に学習させる。
- Diverse Mobile Manipulator data(MM): 約100の異なる家庭環境で収集した、移動可能なロボットによる家事タスクの実演データ(約400時間)、評価タスクに最も近いデータ
- Multi-Environment非モバイルロボットdata(ME): 複数の家庭環境で、固定式のロボットアームから集めたデータ、本体が軽量なため環境の多様性を稼ぎやすい
- Cross-Embodiment laboratory data(CE): 研究室内で、さまざまな種類のロボットから集めた行動データ
- High-Level subtask prediction(HL): 「ベッドを整えて」のような高レベル指示を、「毛布を直す」「枕を置く」のような具体的なサブタスクに分解したラベル
- Multi-modal Web Data(WD): 画像キャプション、VQA(視覚質問応答)、物体検出など、ロボットとは無関係な一般的なWebデータ
flowchart TB
    MM["Mobile Manipulator data<br>家庭での家事タスク約400時間"] --> PT
    ME["Multi-Environment data<br>固定ロボット・複数環境"] --> PT
    CE["Cross-Embodiment data<br>研究室の異種ロボット"] --> PT
    HL["High-Level subtask data<br>サブタスク分解ラベル"] --> PT
    WD["Multi-modal Web Data<br>キャプション・VQA・物体検出"] --> PT["事前学習<br>(pre-training)"]
    PT --> VI["Verbal Instruction data<br>人間による言語デモ"]
    VI --> Post["事後学習<br>(post-training)<br>モバイルマニピュレーションに特化"]
Post --> Model["π0.5"]- 事前学習で使われるデータのうち、実に97.6%はモバイルマニピュレータによる家事タスクそのものではなく、これら周辺のデータソースから来ている
- 論文のアブレーション実験では、CEやMEのような他ロボットのデータを除外すると性能が大きく落ちることが示されており、「異なるロボット・異なる環境からの知識転移」が汎化に不可欠であることを裏付けている
- Webデータ(WD)を除外しても平均的な成功率への影響は小さいが、学習に出てこない物体カテゴリ(out-of-distribution)への汎化性能は大きく落ちる、という非対称な結果も出ている
事後学習(post-training)
- 事前学習済みのモデルに対し、実際の使用用途であるモバイルマニピュレーションに特化させる段階
- ここでAction Expertの重みをランダム初期化で追加し、Flow Matchingによる連続行動生成を学習する
- 加えて、人間が手本としてロボットを操作しながら「次はこうして」と言語でサブタスクを逐次指示した「Verbal Instruction data(VI)」を使い、高レベル推論の質を高める
ロボットシステム
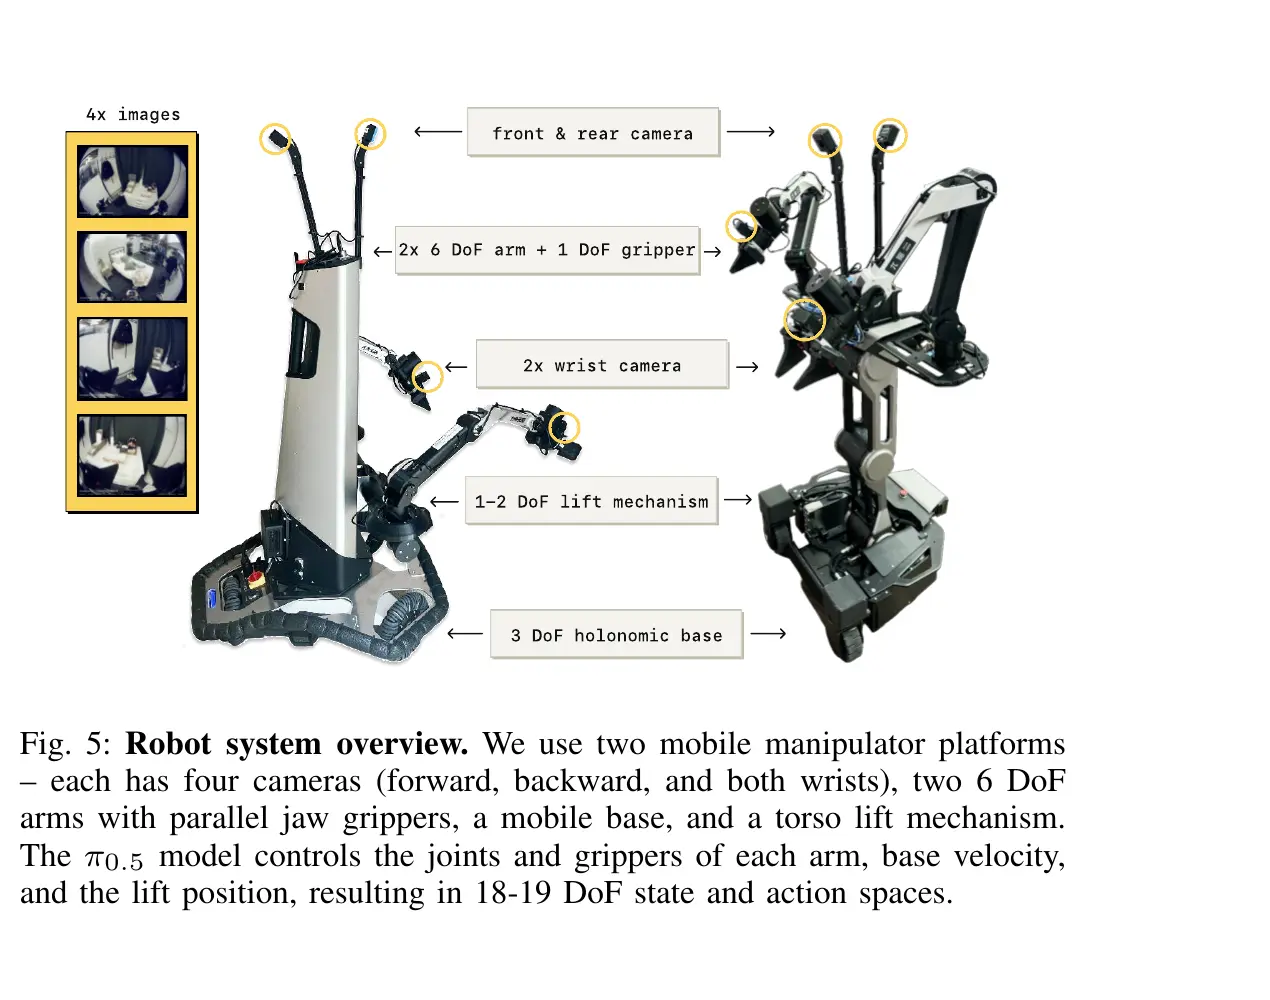
- 評価には2種類のモバイルマニピュレータを使用、いずれも前後・両手首に計4台のカメラ、6自由度のアーム×2、昇降機構付きの台車を備える
- π0.5が出力するのは、両腕の関節角度・グリッパー開閉・台車の並進速度・昇降位置で、合計18〜19自由度の行動空間
- 制御はシンプルなPD制御のみで、軌道計画や衝突回避のような追加の仕組みは持たず、認識から行動までを完全にエンドツーエンドで学習したモデルだけで賄っている
評価実験
新しい家庭環境での汎化
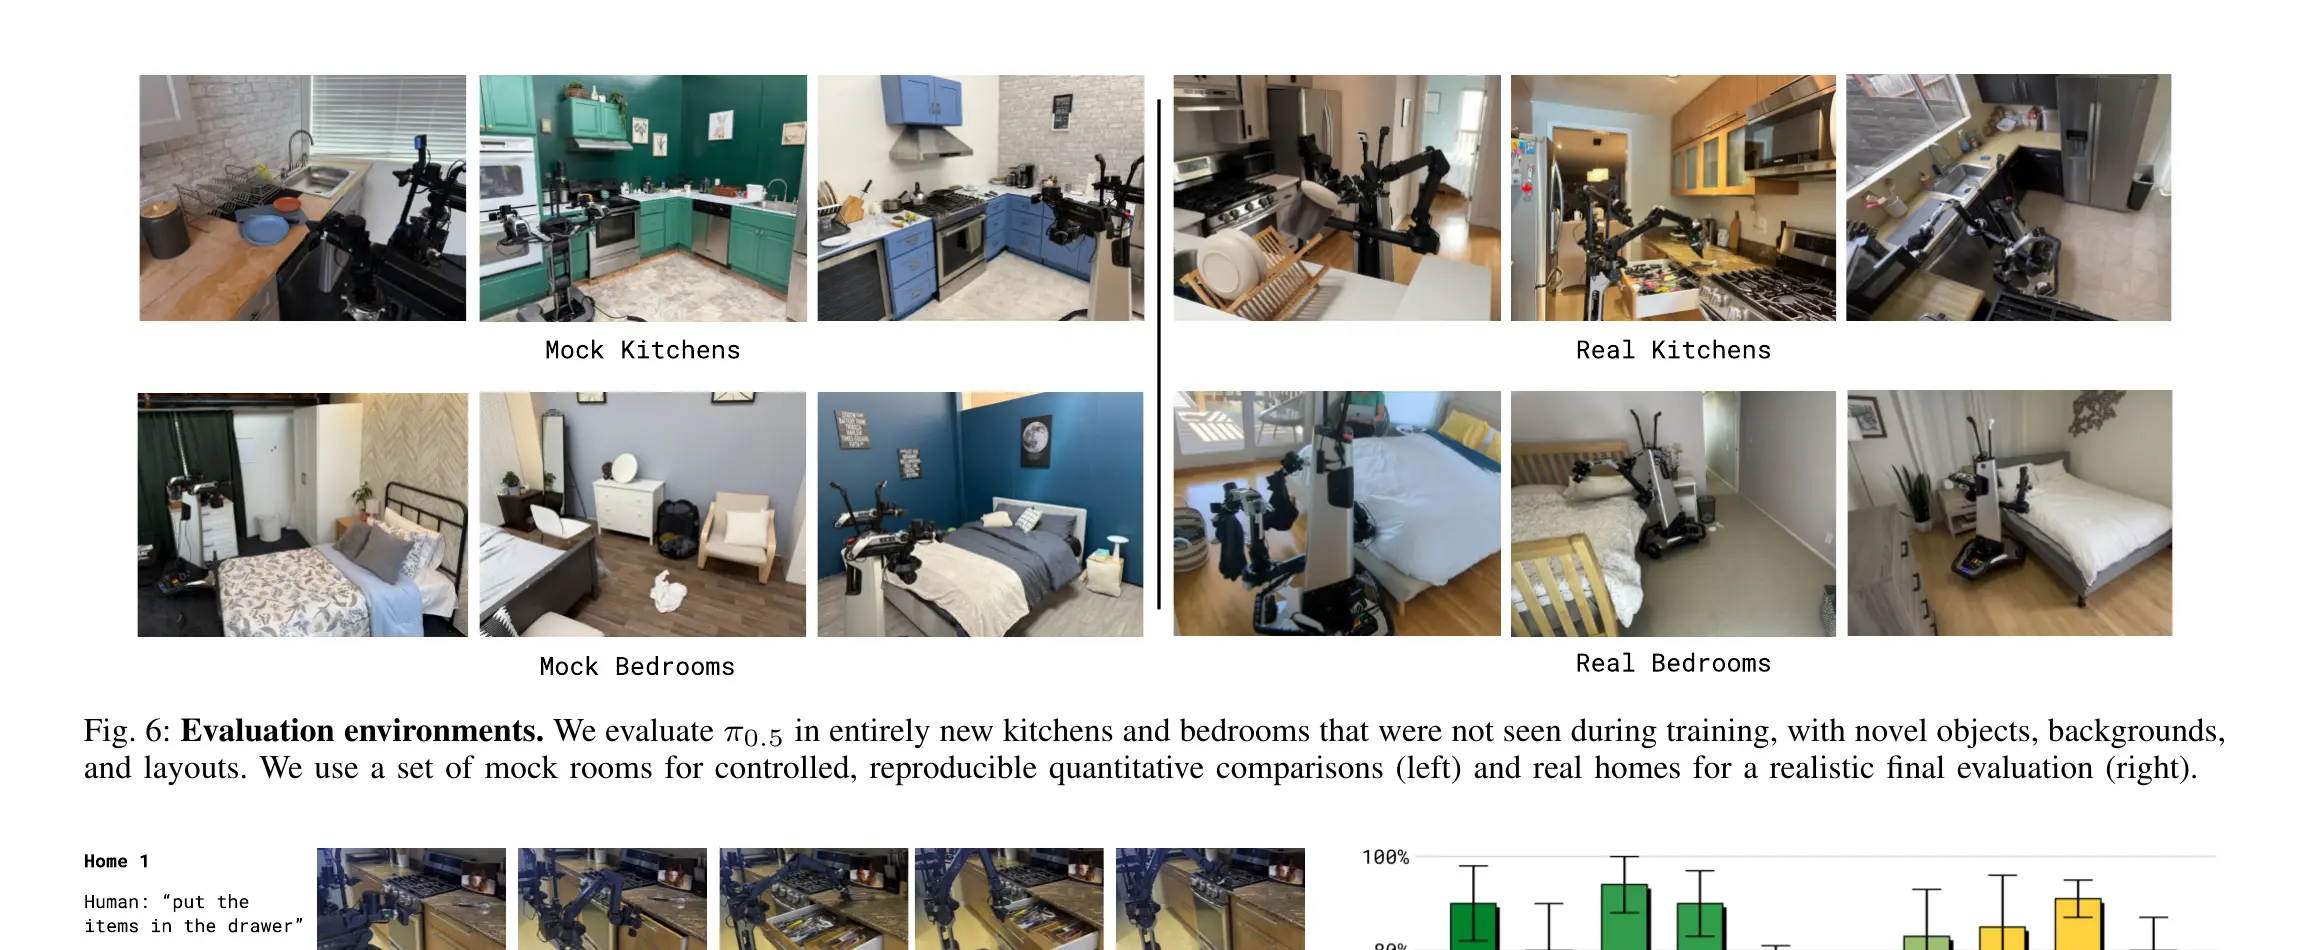
- 定量評価には再現性のある「模擬部屋」、最終評価には学習データに一切含まれない3件の実際の家庭を使用
- いずれも「寝室の片付け」「キッチンの片付け」という高レベル指示だけを与え、具体的な手順(どの物を先に動かすか等)はモデル自身が決定する
- 実際の家庭での評価でも、模擬部屋での評価と同程度の性能が出ており、模擬環境での評価が実環境の代替として妥当であることが確認されている
環境数とスケーリング
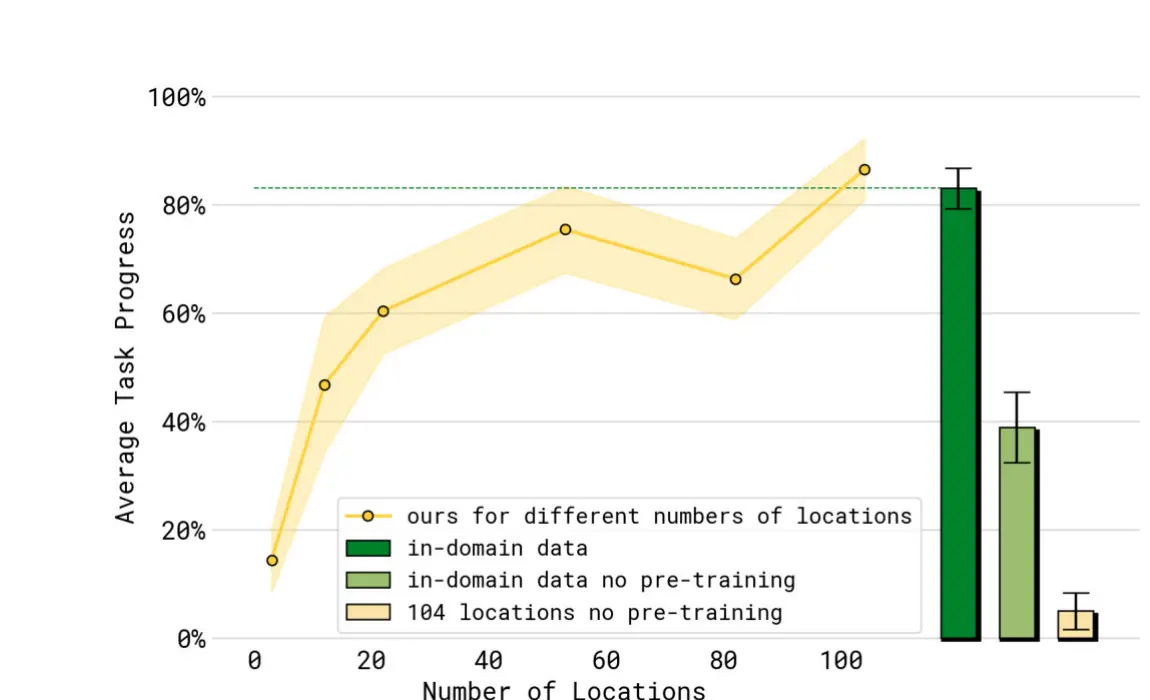
- 事後学習で使う環境の数を3・12・22・53・82・104と変えて、汎化性能の変化を測定した実験
- 環境数が増えるほど、未知の環境(模擬部屋)での性能が一貫して向上する
- 104環境で学習したモデルは、評価対象の家庭そのものを学習データに含めたモデル(図中の緑のバー)とほぼ同等の性能に達しており、十分な数の環境で学習すれば、個別の家庭を学習していなくても同水準の汎化が可能であることを示している
他モデルとの比較
- 同条件で学習したπ0(オリジナル)、およびπ0にFAST+Flowのハイブリッド学習だけを適用したモデル(高レベル推論なし)と比較
- π0.5はいずれの比較対象よりも高い性能を示し、π0の学習ステップ数を3倍(300kステップ)に伸ばしても追いつかない差があった
- 高レベル推論を使わずタスクプロンプトを直接低レベル推論に渡す構成とも比較されており、高レベル推論を挟む2段階構造自体が性能に寄与していることも確認されている
まとめ
π0.5は、モバイルマニピュレータによる家事データだけでなく、他ロボットのデータ・高レベルサブタスク予測・Webデータといった性質の異なる複数のデータソースをco-trainingし、高レベル推論と低レベル推論を1つのモデルに統合することで、未知の家庭環境でも長時間・多段階のタスクを遂行できる汎化性能を実現している。アーキテクチャ自体はπ0から大きく変えておらず、学習データの多様性と設計こそが性能向上の主な要因である、という点が論文を通じて一貫して強調されている。
Sources: